
腾讯开源 DSpine,代码从 28 冲到 129 tok/s
本文来源: 大模型前线观察(公众号:大模型前线观察)
原文链接: https://mp.weixin.qq.com/s/VJWfu53ymOE1YOmxvduOVQ
发布时间: 2026-11-10 08:20
作者: 大模型前线观察 发布时间: 2026-11-10 08:20
Qwen3.8-27B 本地生成是逐 token 的,每吐一个 token 都要把 27B 的完整网络跑一遍。推测解码让一个小模型先连着猜一段候选,再由目标模型一次验证,从头开始连续猜对的部分直接收下,猜错那一位之后的候选全部作废。一轮能收下多少个 token ,决定了最终速度。
把整块候选放在一次前向里全算出来的并行草稿器,前向本身很快,麻烦在于每个位置做决定时还不知道前面究竟选了哪个 token 。单独看每个候选都合理,接在一起不连贯,目标模型只能收下很短的一截。
2026 年 11 月 7 日,腾讯在 Hugging Face 放出 tencent/Qwen3.8-27B-DSpine-b16,给 Qwen3.8-27B 配了专用草稿模型, Apache 2.0 。论文《 Draft in Parallel, Condition Through Depth 》 9 月 28 日上 arXiv , 10 月 10 日修订到 v2 , 10 月放出推理代码、 Qwen3-8B 权重和训练实现, 11 月补上 27B 权重与推理支持。作者来自上海交大、腾讯优图实验室和厦门大学。
这份权重是什么
官方给 27B 配的草稿器是五层网络,约 20.3 亿参数, 4.05 GB 的 BF16 权重,一个 safetensors 文件。草稿块长 16 ,其中 1 个是已知的起始 token ,另外 15 个是待猜位置;草稿侧用 8192 token 的滑动窗口注意力。
每一层把相邻位置预测出的前驱特征传给后继位置,让因果依赖沿网络深度传递,这是模型卡对 DSpine 的定义。它从目标模型的五层取隐藏状态作为输入,与目标模型共享输入 embedding 和 LM head ,训练时这三者都冻结。这份权重只服务 Qwen3.8-27B ,换一个目标模型就要重新训练一份。官方仓库目前列了两个组合, Qwen3-8B 对 tencent/Qwen3-8B-DSpine-b16, Qwen3.8-27B 对这一份 27B 的 b16 。同类的 z-lab/Qwen3.8-27B-DFlash2 草稿块长是 8 。训练实现放在 SpecForge 的 PR 1038 ,配合官方 training guide 可以自己重训一份草稿器。这份仓库只放权重,不带推理运行时,跑起来要靠 SGLang 插件或社区 llama.cpp 分支。运行时目标模型负责验证,草稿模型只出候选,两份权重同时常驻显存,验证不通过的位置由目标模型自己接着生成。
安装入口是两条命令,权重可以直接用 Hugging Face 路径,也可以先下到本地。
git clone https://github.com/Tencent/DSpine.git cd DSpine pip install -e .加速效果
官方数字来自 SGLang 8 路并发的 agent 会话回放,吞吐按总输出 token 数除以并发回放的端到端墙钟时间算。评测环境是 Python 3.11+、 SGLang 0.5.22 、 BF16 、 FlashAttention 3 ;每个子集 20 段对话,按工具决策前缀依次重放,开前缀缓存,单请求最多新生成 32768 token 。 SWE-bench Pro 的 xhigh 档,不开投机解码 248.17 tok/s , DFlash2 711.60 ( 2.87 倍), DSpine 791.30 tok/s ( 3.19 倍);同一行的接受长度是 4.00 对 4.77 。 WorkBuddy Office 的 low 档从 210.03 tok/s 到 805.53 tok/s , 3.84 倍,是表里最高的一档。 WorkBuddy Web 的 xhigh 档 840.14 tok/s ( 3.33 倍),τ²-bench 的 low 档 964.30 tok/s ( 3.20 倍)。
通用基准另用 xhigh 推理档,贪心与采样各测一遍,单请求最多新生成 4096 token ,采样参数是 temperature 1.0 、 top_p 0.95 、 top_k 20 。贪心解码下五项平均接受长度, GSM8K 从 5.69 提到 7.20 , MATH-500 5.49 到 6.49 , HumanEval 4.87 到 5.71 , MBPP 5.04 到 6.14 , MT-Bench 4.11 到 4.48 。 agent 回放的 low 档接受长度, WorkBuddy Code 4.19 到 5.08 , WorkBuddy Web 3.95 到 4.91 , WorkBuddy Office 4.24 到 5.63 ,τ²-bench 4.70 到 5.53 。
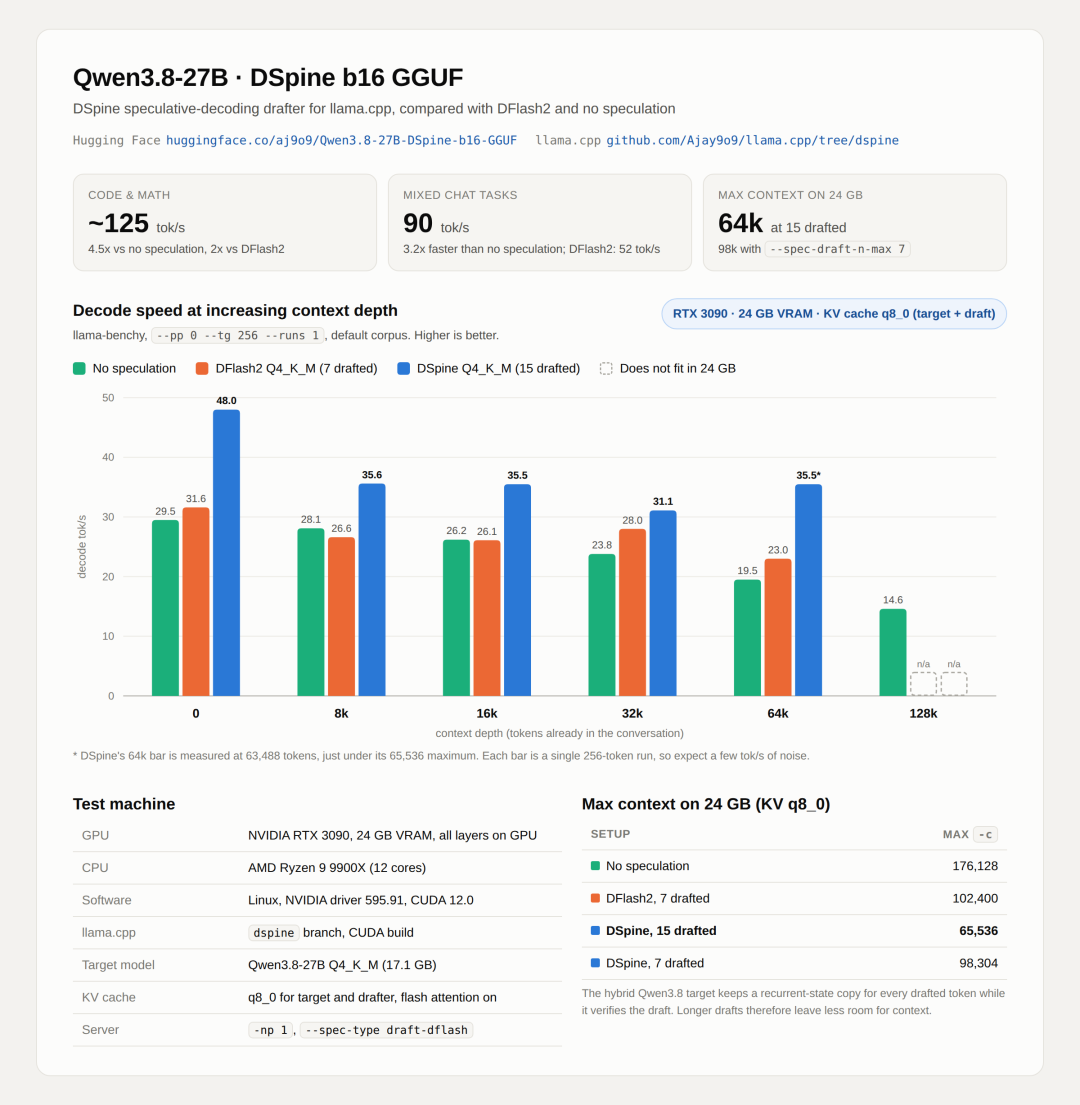
单卡数字来自社区开发者 aj9o9 转出的 GGUF 。测试机是 RTX 3090 24 GB 、 Ryzen 9 9900X 、 CUDA 12.0 、-np 1、目标与草稿的 KV cache 都是 q8_0 ;短上下文 10 组聊天加 4 组代码提示,每组最多生成 1024 token ,关掉思考模式。贪心解码下基准 28.2 tok/s , DFlash2 51.7 , DSpine 90.1 ( 3.19 倍);温度 1 时 DFlash2 50.6 、 DSpine 80.4 。
按任务拆开, DSpine 在代码上是 128.7 tok/s 、每验证步接受 7.6 个 token ,数学 122.8 、每步 7.3 ,摘要翻译 62.0 、每步 3.6 ,散文故事 41.6 、每步 2.5 。长上下文以小说为输入生成 256 token , 0 深度 48.0 tok/s , 8K 深度 35.6 , 32K 深度 31.1 。
上面两组数一组是 8 路并发合计的服务吞吐,一组是单卡单请求的解码速度,测试条件不同。
原理
目标模型一次验证整块候选,只保留从头开始连续通过的那一段。第 4 位猜错,第 5 位到第 16 位算得再好也用不上,所以并行草稿的收益取决于连续通过的前缀有多长。
已有的几种做法各占一个位置。 DFlash 完全不用前驱信息,各位置独立选词; Domino 和 DSpark 在骨干网络之后接一个轻量模块补条件依赖; DFlash2 用路径选择器在 top-k 候选上挑链子,并加了因果的两 tap 卷积。前驱信息进入后继位置时,骨干的特征已经定型。
腾讯用官方 Qwen3-8B 的 DFlash 草稿器做了探针实验。从浅层注入正确前缀特征,连续正确 token 提升 6.7%;同样的注入量提前到更早的层,增益从 1.2% 抬到 4.3%;只把相邻前驱换成草稿自己的预测,其余保持正确,后继准确率掉 31.8 个百分点,把正确的前驱提前送进去能多拿 14.8 个点。靠前的位置在浅层就形成了可读出的预测,这份信息越早送达越有用。
官方仓库给过一组同条件对照:五种草稿器都用五层、块长 16 、六轮、同一份数据重训,在 Qwen3-8B 的七项数学、代码、聊天基准上量平均接受长度。贪心解码下 DFlash 5.92 、 Domino 7.05 、 DSpark 7.44 、 DFlash2 7.55 、 DSpine 7.83 ;采样温度 1 时依次是 4.94 / 5.59 / 6.65 / 6.53 / 6.98 。训练数据是 Open-PerfectBlend , DSpark 、 DFlash2 和 DSpine 用同一份数据和同一份训练预算。 DSpine 贪心解码下七项分别是 GSM8K 10.55 、 MATH-500 10.30 、 HumanEval 8.27 、 MBPP 7.66 、 LCB 7.25 、 MT-Bench 5.63 、 Arena-Hard 5.13 。
DSpine 把条件依赖搬进骨干网络内部。位置 t 只看目标上下文的 K/V ,以及块内不晚于自己的位置,不再像 DFlash 那样双向可见,消息传递方向和注意力方向因此一致,训练时注入到某位置的正确信息也不会回流到更靠前的位置。
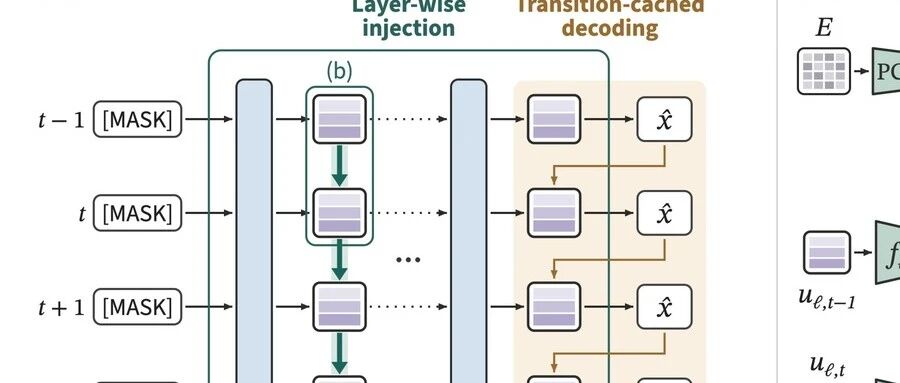
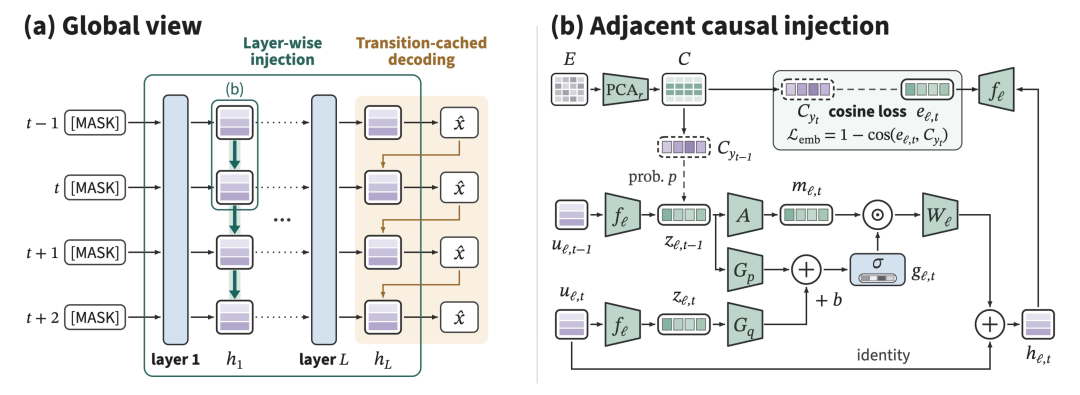
每层算完,位置 t 收到且只收到直接前驱 t-1 的预测特征。门控同时看前驱特征和接收方自己的特征,决定写入多少。所有消息都用更新前的特征,单层内所有位置仍然并行更新;上一层收到的消息进入下一层计算,因果链沿着网络深度展开,不按时间逐 token 排队。
传的是「前一位准备预测什么」这件事本身,用一张固定的 token 表示表来表达:把目标模型 LM head 的输出 embedding 逐行做 L2 归一化、 PCA 白化、保留 r 个主方向后再归一化,得到表 C 。前驱还没定时传网络预测的低维特征,前驱已经解码出来就直接查表取它的 embedding ,两者走同一条注入通路。每层还加了一项余弦监督,让浅层的预测特征对齐正确 token 的表示。
前驱一旦选定,用它的 token 表示替换原来的预测特征,重做最后一次写入,这一步叫 last-write refinement 。每个位置先留 top-16 候选,再把相邻位置所有候选组合的分数一次性并行算成 16×16 的转移表,即 transition cache ;从左到右选词时沿表查结果即可,不必每选一步再做一次矩阵计算。
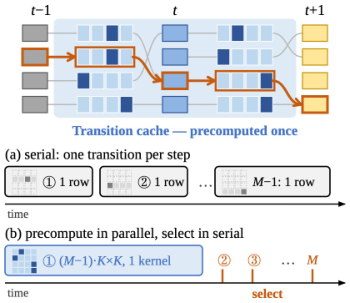
论文把这套结构的耗时也给了出来。五层注入合起来每轮最多增加 0.15 ms ;骨干之后的条件解码头, Domino 0.97 ms 、 DSpark 0.88 ms 、 DSpine 0.36 ms 。整体一轮 DSpine 7.14 ms 、 DFlash2 7.19 ms ,每生成一个 token 的解码时间少 10.9%。消融表里去掉 last-write refinement ,接受长度降 6.6% 到 7.1%,再把注入一起去掉,降幅扩大到 8.8% 到 10.7%。
官方 SGLang 部署
官方路径要求 Python 3.11+、 CUDA 和 SGLang 0.5.22 。装完插件,按官方 27B 模型卡的参数启动服务。
sglangserve\--model-pathQwen/Qwen3.8-27B\--speculative-algorithmDSPINE\--speculative-draft-model-path/path/to/Qwen3.8-27B-DSpine-b16\--speculative-num-draft-tokens16\--dtypebfloat16\--attention-backendfa3\--speculative-draft-attention-backendfa3\--linear-attn-backendtriton\--enable-linear-replayssm-spec\--mamba-ssm-dtypefloat32\--mamba-radix-cache-strategyextra_buffer\--max-mamba-cache-size64\--mem-fraction-static0.80\--context-length131072\--max-running-requests8\--cuda-graph-max-bs-decode8\--min-free-slots-delay1\--sampling-backendflashinfer\--reasoning-parserqwen3\--tool-call-parserqwen3_coder\--trust-remote-code后面五个开关管解码 batch 、采样后端和 Qwen3 的推理与工具调用解析格式,官方评测用的就是这一整套参数,照抄即可。--mem-fraction-static 0.80 把 80% 显存划给静态占用,--context-length 131072 与 --max-running-requests 8 对应上下文长度和并发数。
Qwen3.8 是混合注意力模型,--enable-linear-replayssm-spec 配合 ReplaySSM 在验证后重放递归状态,让下一轮从真正接受的前缀继续。动态验证参考了 DSpark ,仓库里的 docs/sps_tuning.md 要求先用代表性对话前缀跑一遍 SPS 调优,把结果存成 sps.json,再用 --speculative-dspark-sps-table-path 挂上去。
单卡 llama.cpp 部署
社区把官方权重转成了 GGUF ,仓库是 aj9o9/Qwen3.8-27B-DSpine-b16-GGUF,三个文件分别是 Q4_K_M 1.26 GB 、 Q8_0 2.20 GB 、 BF16 4.06 GB ,推荐 Q4_K_M , code bridge 张量保留 BF16 。这些文件只有草稿模型,还需要另配一份 Qwen3.8-27B 的目标 GGUF ,作者用的是 Q4_K_M , 17.1 GB 。
上游 llama.cpp 目前还不支持 DSpine , stock 版本会直接拒绝加载这些文件,要跑得克隆 Ajay9o9/llama.cpp 的 dspine 分支。
gitclone-bdspinehttps://github.com/Ajay9o9/llama.cpp.git cdllama.cpp cmake-Bbuild-DGGML_CUDA=ON cmake--buildbuild--configRelease-j启动命令里 --spec-draft-n-max 的默认值只有 3 ,等于只用了 16 token 块的一小截,要自己设成 15 。-c 也要手动给, auto-fit 不会给草稿器留够空间。
./build/bin/llama-server\-mQwen3.8-27B-Q4_K_M.gguf\-mdQwen3.8-27B-DSpine-b16-Q4_K_M.gguf\--spec-typedraft-dflash\--spec-draft-n-max15\-ngl999--spec-draft-ngl999\-faon--jinja-c32768-np1\--cache-type-kq8_0--cache-type-vq8_0\--spec-draft-type-kq8_0--spec-draft-type-vq8_0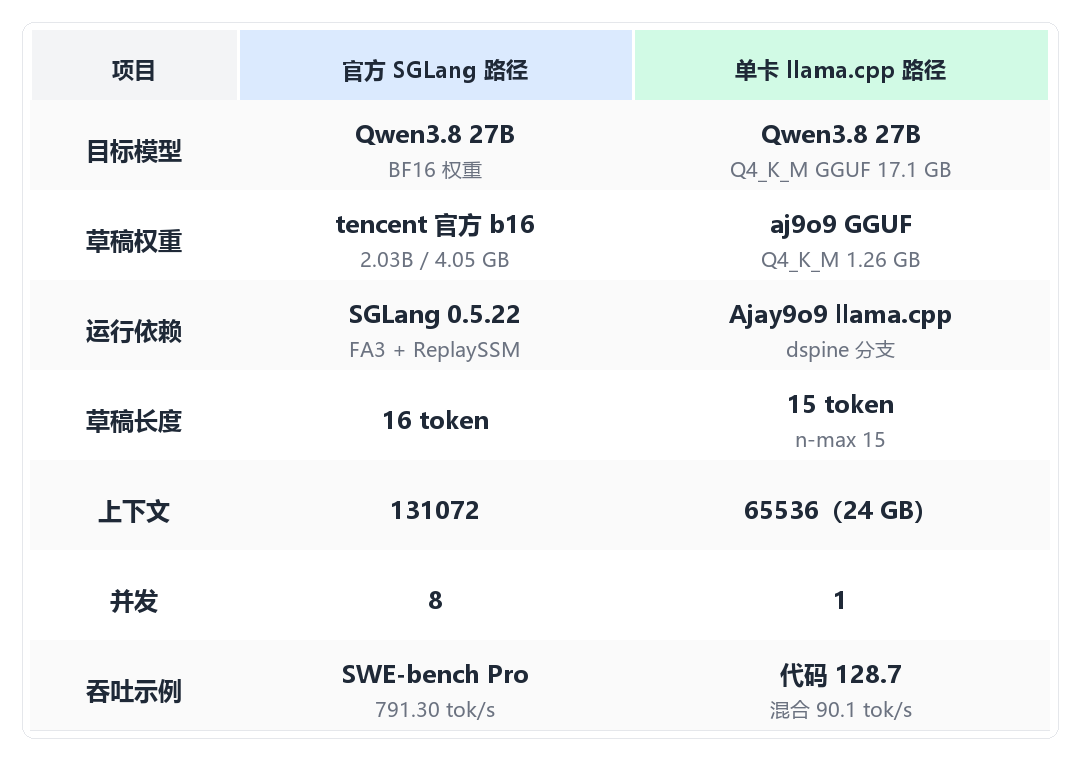
调参与显存
24 GB 卡上能开到的最大 -c,不开投机是 176128 , DFlash2 7 个草稿是 102400 , DSpine 15 个草稿只有 65536 ,把草稿降到 7 个能回到 98304 ,换成 Q8_0 草稿是 40960 。 Qwen3.8 验证草稿时会为每个候选 token 保留一份约 150 MB 的递归状态, 16 token 块比 8 token 块多占约 1.2 GB ,这份显存从上下文预算里出。
同一份 GGUF 在不同后端上的最优草稿长度不一样,社区模型卡收了五位测试者的结果。
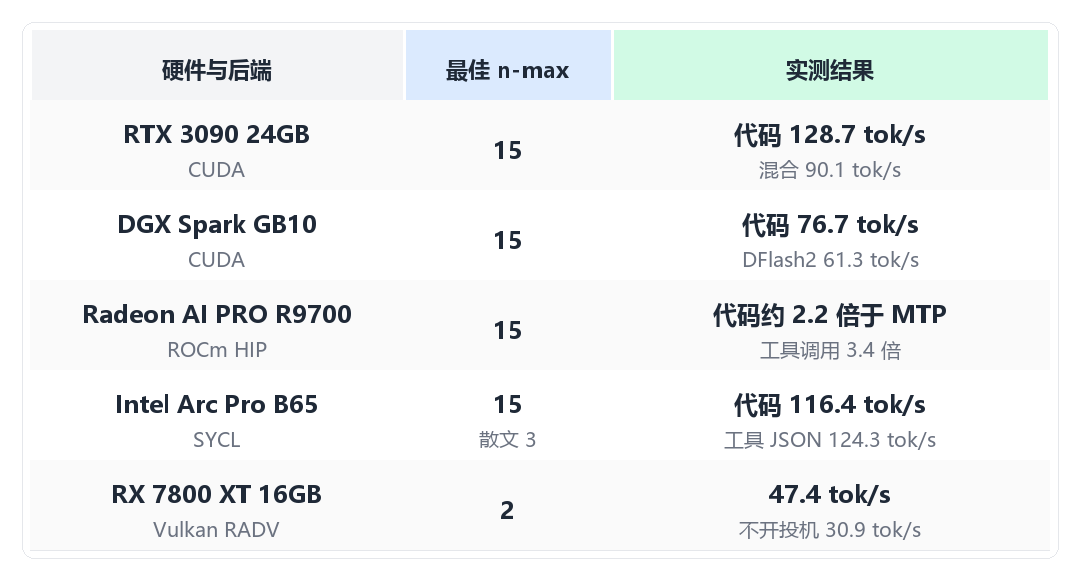
在自己的提示词上依次试 --spec-draft-n-max 的 2 、 3 、 4 、 7 、 15 。 CUDA 、 ROCm/HIP 、 SYCL 大多落在 15 , AMD 走 Vulkan 建议 2 或 3 ,纯散文聊天先试 3 ,长草稿在散文上大多会被拒。按任务选草稿器, DSpine 的强项是代码、数学和工具调用,散文、聊天、图像描述可以换 DFlash2 ,或用目标模型自带的 MTP (--spec-type draft-mtp --spec-draft-n-max 2,需要带 MTP 层的目标 GGUF )。 24 GB 卡开 -np 2 时把草稿降到 7 个,双卡分层拆分也可行,显存不够就降 n-max 或降 -c。
即使 temperature 0 ,开了草稿器之后输出也可能和不开草稿器时不同。批量验证多个 token 的浮点舍入与逐 token 不同,接近并列的 token 可能翻转;代码和工具调用通常一致,散文与图片描述更容易分叉。
一键三连『点赞』『转发』『小心心』,让更多人看到。
欢迎在评论区留下你的想法!
✨ 点亮星标 ✨
公众号「大模型前线观察」,每日追踪大模型前沿动态。
本文转载自微信公众号「大模型前线观察」,仅供学习交流使用。
觉得内容不错?我要