
AI 芯片杂谈系列(四):GPU、TPU、NPU、DPU、RPU 差别在哪里?
本文来源: 徐禾(公众号:徐禾)
原文链接: https://mp.weixin.qq.com/s/gZ4DNI7k5aQyjZJ3fMGwBA
发布时间: 2026-10-13 12:23
作者: 徐禾 发布时间: 2026-10-13 12:23
一句话摘要:一张分类图加一张对照表,把五种「PU」按「替谁干活」归位,让你下次看到新「PU」能自己判断它是什么、能不能跑模型。
1. 五个「PU」,干的是三种活
芯片圈有一堆带 PU 的名字:GPU、TPU、NPU、DPU、RPU。发布会、招聘 JD、选型文档里到处是,却很少有人说清它们是不是一回事。
它们不是一回事。五个名字背后,是三种完全不同的活儿:有替模型做计算的,有替数据中心搬数据的,还有换了一条技术路线的。
这一篇不逐个背名词。先给你一个归位框架,再一张表对照,最后挑三组最容易混的讲清。
2. 先归位:按「替谁干活」分三条线
看到一颗「X PU」,第一件事不是查它全称,而是问一句:它替谁干活?
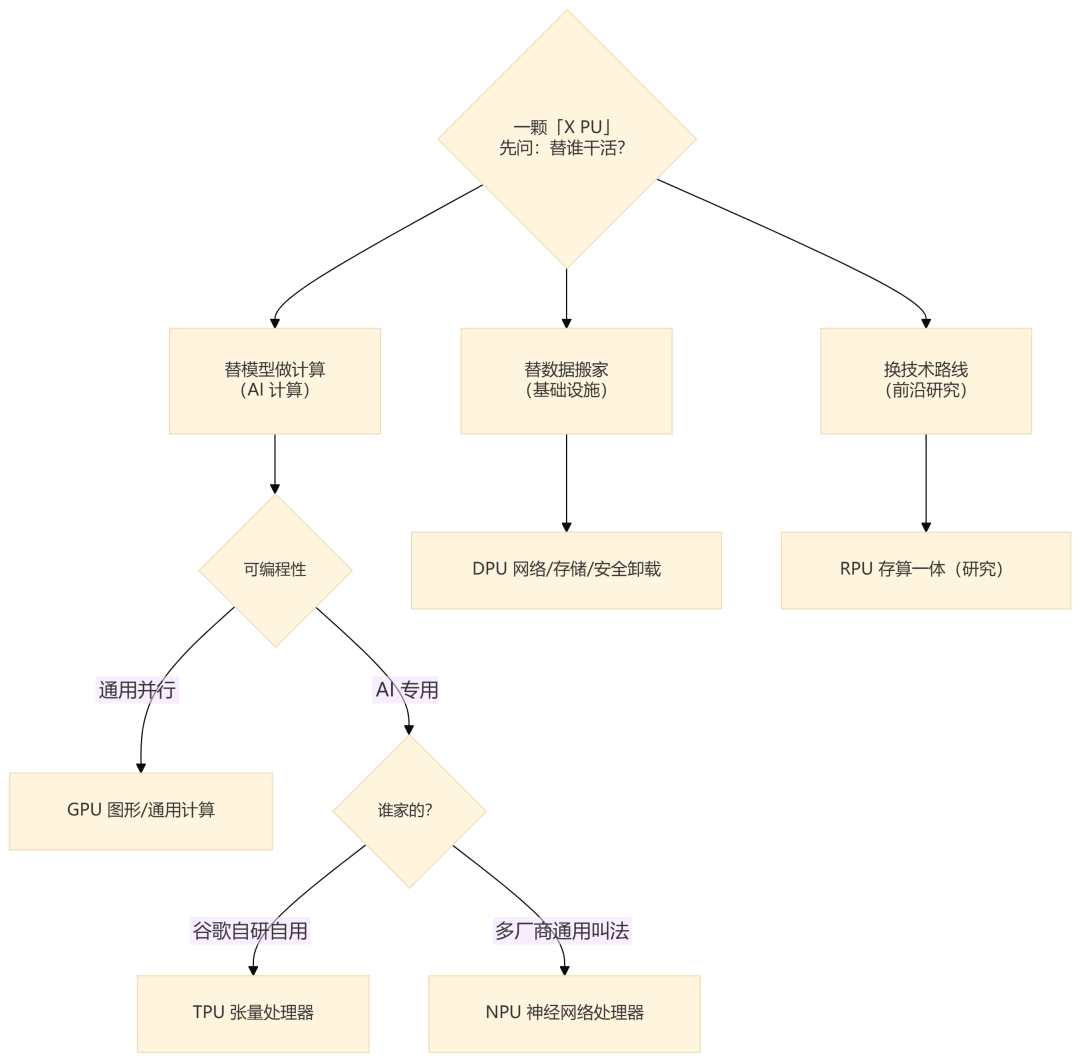
三条线,一眼看清谁和谁是一伙的:
- GPU、TPU、NPU 同在「替模型算」这条线,只是通用程度不同。
- DPU 在另一条线,它根本不碰模型。
- RPU 是第三条线,换了一条技术路线。
3. 逐个拆开看
3.1 GPU:从画图起家,如今以通用计算为主
GPU(Graphics Processing Unit,图形处理器)起家是为 3D 游戏渲染,几千个核心并行算像素。
转折点是 2006 年的 CUDA:它让开发者能用熟悉的语言写通用并行程序,GPU 从此不只会画图 [1]。
这里补一个专业叫法:当 GPU 被拿来做画图以外的通用计算时,专业上称 GPGPU(General-Purpose computing on GPU,通用计算 GPU)。 今天的 AI 语境里说的就是它——数据中心里的 H100/H200 这类卡连视频输出接口都没有,主业是 AI 和科学计算,画图反而成了附带能力。
典型代表:NVIDIA H100/H200、AMD Instinct 系列。
边界也在这:最通用、最可编程,代价是通用性带来的效率折损——有些晶体管和复杂度是为「什么都能跑」付的,不是为矩阵乘付的。
3.2 TPU:谷歌自研自用的张量处理器
TPU(Tensor Processing Unit,张量处理器)是谷歌为神经网络定制的专用芯片(ASIC),矩阵乘是它的主运算。
它最大的特点是不单卖:你买不到一颗 TPU 芯片,只能通过 Google Cloud 按小时用它 [2]。 编程走 TensorFlow/JAX,由 XLA 编译器把图翻译成 TPU 指令。
典型代表:TPU v5p、v6(Trillium)。
边界:只做神经网络那几类运算,出了这个范围就用不了;但在这个范围内,效率做得很高。
3.3 NPU:神经网络处理器的通用叫法
NPU(Neural Processing Unit,神经网络处理器)不是某一家产品,而是一大类——面向神经网络(尤其推理)的专用加速器。
范围最宽。手机里有苹果的 Neural Engine、高通的 Hexagon;数据中心有华为昇腾、寒武纪思元 [4]。端侧到云都有。
边界:字面上 TPU 也算一种 NPU,但习惯上谷歌的单独叫 TPU,其余各家叫 NPU。 具体能力看产品,不能看到「NPU」就假设它能训练或能跑大模型。
3.4 DPU:不跑模型的数据处理器
DPU(Data Processing Unit,数据处理器)卸载数据中心的网络、存储、安全等「搬数据、管数据」的活儿,替 CPU 减负。
它不训练也不推理模型(部分产品带一点 AI 能力,但主业不是)。把它放进盘点,就是为了提醒:别看到「PU」就当 AI 算力芯片 [3]。
典型代表:NVIDIA BlueField、Intel IPU、AMD Pensando。
3.5 RPU:还在研究里的存算一体
RPU 是五个里名字最不统一的,至少两个展开:
- Resistive Processing Unit(电阻式/存算一体处理器):IBM 提出的用非易失存储器直接做模拟矩阵运算。
- Reconfigurable Processing Unit(可重构处理器)。
AI 芯片语境里通常指前者——IBM 的存算一体路线 [5]。
它的意义正在第 3 篇讲的带宽瓶颈:把「算」和「存」合一,省掉数据在内存和计算单元之间搬来搬去。现状是研究/早期原型,未量产,也没有成熟生态。
4. 一张对照表
| 缩写 | 全称 | 干的活 | 典型代表 | 主战场 |
|---|---|---|---|---|
| GPU | Graphics Processing Unit(通用计算时称 GPGPU) | 通用并行计算 | NVIDIA H100、AMD Instinct | 训练 + 推理 + 科学计算 |
| TPU | Tensor Processing Unit | 张量/矩阵专用 | Google TPU v5p/v6 | 谷歌云上的训练与推理 |
| NPU | Neural Processing Unit | 神经网络专用(宽泛) | 华为昇腾、寒武纪、苹果 Neural Engine | 端侧到数据中心的 AI 加速 |
| DPU | Data Processing Unit | 网络/存储/安全卸载 | NVIDIA BlueField、Intel IPU | 数据中心基础设施 |
| RPU | Resistive Processing Unit | 模拟存算一体(研究) | IBM RPU 原型 | 前沿研究,未量产 |
5. 三组最容易混的
5.1 GPU vs TPU/NPU:通用 vs 专用
GPU 什么并行算法都能写,但通用性要付代价;TPU/NPU 只做神经网络那几类运算,换来更高的效率和更低的功耗。
一句话:通用机床 vs 流水线专用夹具。 专用夹具更快,但换个活儿就抓瞎。(类比到这里为止,别往「GPU 一定慢」上推——真实性能还看具体实现和软件。)
5.2 TPU vs NPU:产品名 vs 通用术语
TPU 是谷歌的具体产品,NPU 是行业通用叫法。所以「TPU 也算一种 NPU」这句话字面没错,但没人这么叫——就像「iPhone 也算一种智能手机」,但讨论时你会单说 iPhone。
5.3 DPU:它根本不是 AI 芯片
DPU 和前面四个不在一个赛道。它服务的是「数据怎么搬、怎么管」,不是「模型怎么算」。选型时把它和算力芯片放在一起比,就像拿交换机去比 GPU。
6. 看到「X PU」,先问四句
- 替谁干活? 模型计算 / 数据搬运 / 别的?
- 通用可编程,还是专用? 决定它能不能干计划外的活。
- 产品名还是通用术语? TPU 是产品名,NPU 是术语,别混着比。
- 量产了吗、生态成熟吗? RPU 这类研究路线,离「能买来跑业务」还远。
7. 思考题 + 下期预告
思考题
- 为什么说「TPU 也算一种 NPU」,但习惯上没人这么叫?
- 手机里的 NPU 和数据中心的昇腾,同为 NPU,为什么能力天差地别?
- RPU 的「存算一体」想解决第 3 篇讲的哪个瓶颈?
下期预告
五种 PU 不管怎么变,跑 AI 都绕不开一个话题:用什么精度算。FP32、FP16、BF16、INT8 怎么选,量化为什么能又快又省?下一期《AI 芯片杂谈系列(五):混合精度与量化》。
参考资料
[1] NVIDIA 数据中心 GPU — NVIDIA;GPU 与 CUDA 通用计算;https://www.nvidia.com/en-us/data-center/ (查阅 2026-09-30)
[2] Cloud TPU — Google Cloud;TPU 架构与使用方式;https://cloud.google.com/tpu (查阅 2026-09-30)
[3] NVIDIA BlueField DPU — NVIDIA;DPU 卸载网络/存储/安全;https://www.nvidia.com/en-us/networking/products/data-processing-unit/ (查阅 2026-09-30)
[4] 华为昇腾 Ascend — 华为;昇腾 NPU 与 CANN 软件栈;https://www.hiascend.com/ (查阅 2026-09-30)
[5] Equivalent-accuracy accelerated neural-network training using analogue memory — Ambrogio et al.;Nature 558, 60–67 (2018);IBM 存算一体 RPU 路线;https://www.nature.com/articles/s41586-018-0180-5 (查阅 2026-09-30)
本文转载自微信公众号「徐禾」,仅供学习交流使用。
觉得内容不错?我要