
Transformer——训练模型图解
本文来源: 大头酱瓜(公众号:大头酱瓜)
原文链接: https://mp.weixin.qq.com/s/k0eH3NF8wGLaiAo8C7J6Wg
发布时间: 2026-09-17 08:00
作者: 大头酱瓜 发布时间: 2026-09-17 08:00
训练模型图解——私教健身房
照图纸组装学员、体重秤量差距、私教按差调计划,撕单、复盘、更新三步循环练出87.2%小黑怪诞配图 × Transformer通识第三十四站
数据会流动了,本章压轴大戏开演:把模型练出来。这一站小黑当上私教,健身房里全套流程走一遍——学员(模型)照图纸组装身体(nn.Module 定义层、forward 定义动作);体重秤量出与目标的差距(损失函数);私教按差距调整训练计划(优化器);每轮训练固定三步:撕掉上次的成绩单(zero_grad)→ 考试复盘找出每块肌肉差多少(backward)→ 按差异调整训练量(step);训练档和考试档随时切换(train/eval)。最后用 FashionMNIST 真刀真枪练三轮。
目录 / 私教健身房
01私教登场——训练到底在干什么
02按图纸组装——nn.Module与层
03体重秤——损失函数
04私教方案——优化器
05三步循环——训练循环的固定动作
06双档开关与三轮特训——train/eval与实战
07总结:一纸训练处方
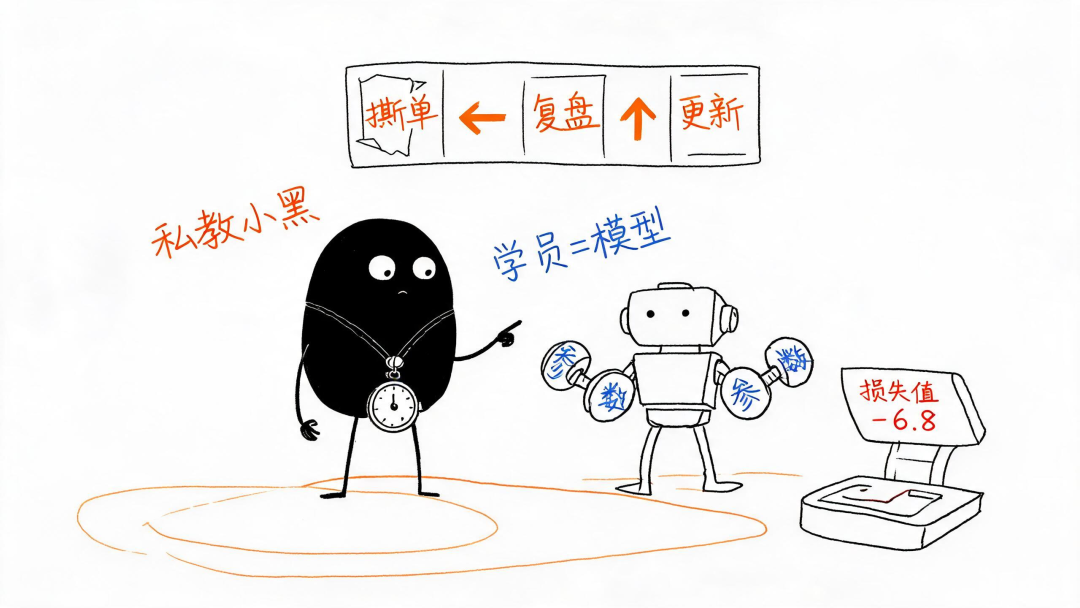
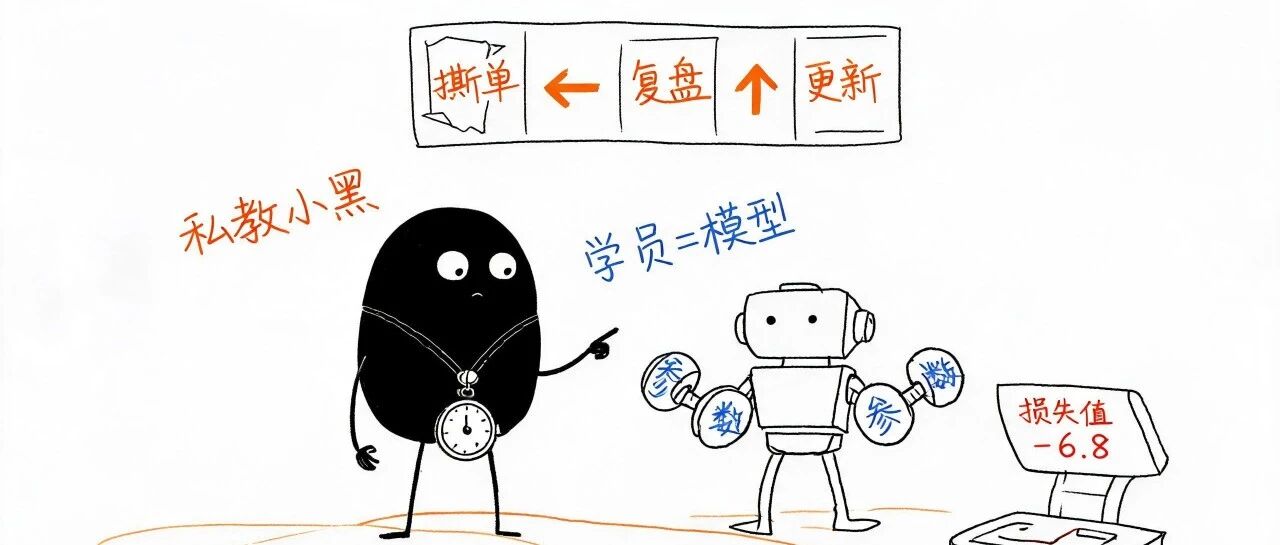
图1 私教健身房总览——小黑私教 + 机器人学员(模型):墙上三步流程牌、角落损失体重秤,训练的全部要素一间房装下
1私教登场训练到底在干什么
先把前几站攒的家底盘一遍:张量能算(第二十六、二十七站)、梯度能求(第二十八站)、形状能调(二十九至三十二站)、数据能源源不断供给(第三十三站)。万事俱备,训练正式定义成一个迭代过程:每一轮 epoch 迭代中,模型对输入样本进行预测,对预测结果计算损失(loss),求 loss 对每一个模型参数的偏导,最后用优化器更新所有参数。循环往复,损失越来越小,本事越来越硬。
每一轮 epoch 实际包含两个步骤:训练循环(Train Loop)——在训练集上迭代,尝试收敛到最佳参数;验证/测试循环(Validation/Test Loop)——在测试/验证集上迭代,检查模型性能有没有真的提升。练完就考、考完再练——私教的基本节奏。
一句话总纲:训练 = 用损失函数量差距 + 用梯度指出方向 + 用优化器迈步子。三件套齐了,剩下的全是循环。
2按图纸组装nn.Module与层
PyTorch 所有的模块(层)都是 nn.Module 的子类,而神经网络模型本身也是一个模块——大模块套小模块,俄罗斯套娃式组装。自定义模型两步走:在 __init__() 里初始化模型中的层和参数(点齐零件),在 forward() 中定义模型的操作(写明数据怎么流过这些零件)。
原文的 FashionMNIST 分类模型就是标准样板:__init__ 里备好 nn.Flatten()(压平臂)和一个 nn.Sequential 容器串起整条流水线——nn.Linear(28*28, 512) 全连接关节 → ReLU() 激活肌肉 → Linear(512, 256) 再来一组 → Linear(256, 10) 出口接 10 分类 → 末端挂 Dropout(p=0.2) 护具防过拟合。forward 里两句话:先 flatten 压平输入,再过 linear_relu_stack,输出 logits。
整体数据流:28×28 的二维图像先被 Flatten 压成一维向量(784),经过两个带 ReLU 激活的全连接隐藏层,最后送入包含 10 个神经元的分类器完成 10 分类,输出前加 Dropout 缓解过拟合。输出的是 logits 值——和 pipeline 模型一样,要再接 Softmax 层才能得到概率:构造 (4, 28, 28) 的四张伪图输入,nn.Softmax(dim=1) 一转得到 (4, 10) 概率表,argmax(-1) 取每行最大值位置就是预测类别。
logits → Softmax → argmax 是推理三连:模型吐原始分数,Softmax 归一成概率,argmax 挑出最大概率的类别。训练时通常停在 logits(损失函数内部自带 Softmax)。
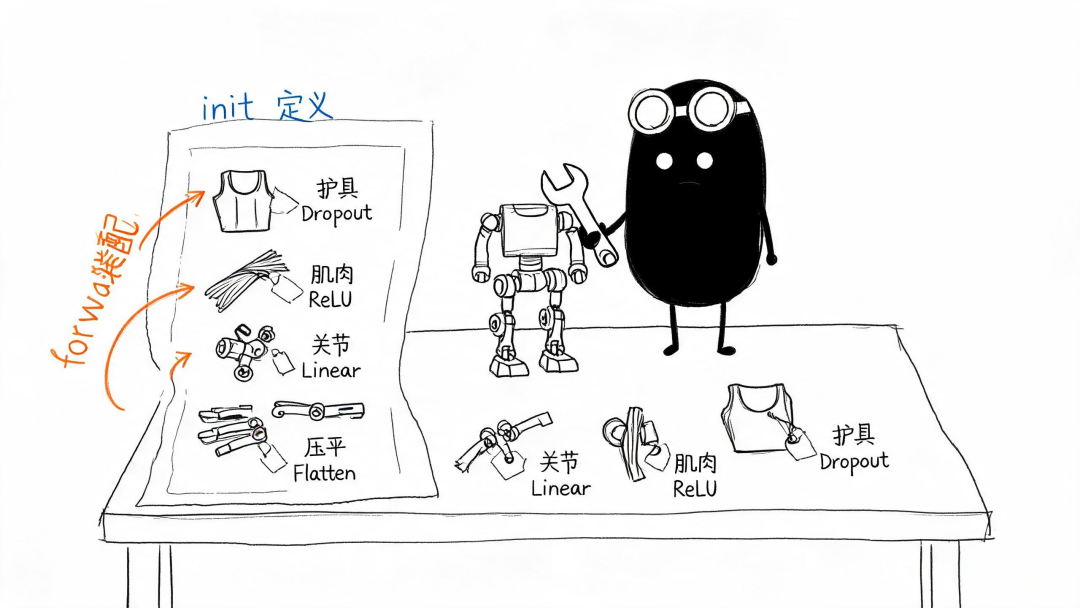
图2 按图纸组装——__init__ 点零件(Flatten 压平臂、Linear 关节、ReLU 肌肉、Dropout 护具),forward 写装配顺序,nn.Sequential 串成流水线
3体重秤损失函数
学员练得怎么样,不能靠私教嘴说,得上秤。损失函数(Loss function)度量预测值与答案之间的差异,模型的训练过程就是最小化损失函数——把秤上的指针往零按。PyTorch 实现了很多常见损失函数:
→ nn.MSELoss:均方误差,回归任务的秤——预测连续数值(房价、温度);
→ nn.NLLLoss:负对数似然,分类任务的秤——要配 LogSoftmax 先取对数概率;
→ nn.CrossEntropyLoss:交叉熵——同时结合了 LogSoftmax 和 NLLLoss,分类训练的事实标准:喂原始 logits 就行,内部一次算完。
选秤原则跟着任务走:回归用 MSE,分类用 CrossEntropy。第七章微调预训练模型做文本分类,用的正是 CrossEntropyLoss——它的输入就是模型 logits 和标签,输出一个标量,backward 就从这一个数倒查回去。
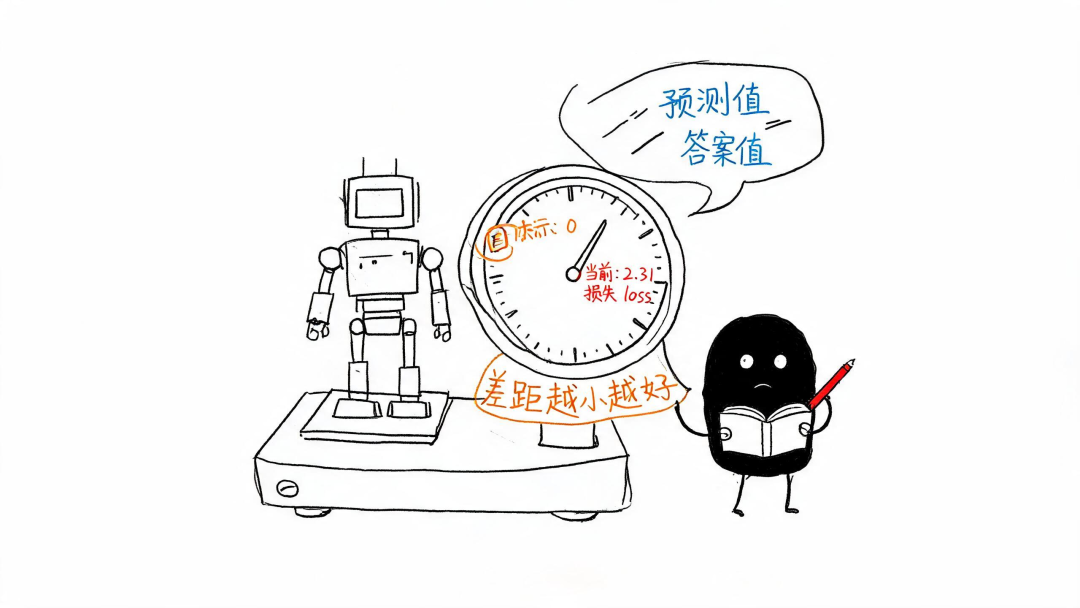
图3 体重秤——损失函数把预测与答案的差距压成一个数:指针越靠近 0 越好;训练的全部目标就是把这根指针按向零
4私教方案优化器
秤量出差距、梯度指出方向,最后一步是谁来实际调整参数——优化器(Optimizer)。它使用特定的优化算法(例如随机梯度下降),通过在每一个训练阶段(step)减少基于一个 batch 样本计算的模型损失来调整模型参数。PyTorch 实现了很多优化器:
→ SGD:随机梯度下降——最朴素的匀速慢跑,算得少、稳,但对学习率敏感;
→ Adam:自适应配速——给每个参数配自己的步幅,收敛快、省心,深度学习默认款;
→ AdamW:Adam 带防护版——修正权重衰减的实现方式,Transformer 训练标配,原文实战用的就是它。
创建优化器只要两样东西:模型的参数(model.parameters() 告诉它要调整哪些旋钮)和学习率(lr,每步迈多大,原文取 1e-3)。学习率是训练里最敏感的旋钮:太大来回震荡不收敛,太小磨磨蹭蹭爬不动。
NLP 微调惯例:优化器 AdamW + 学习率 1e-3 到 1e-5 量级起手,效果不好再调。第七章微调实战将直接照此配方开工。
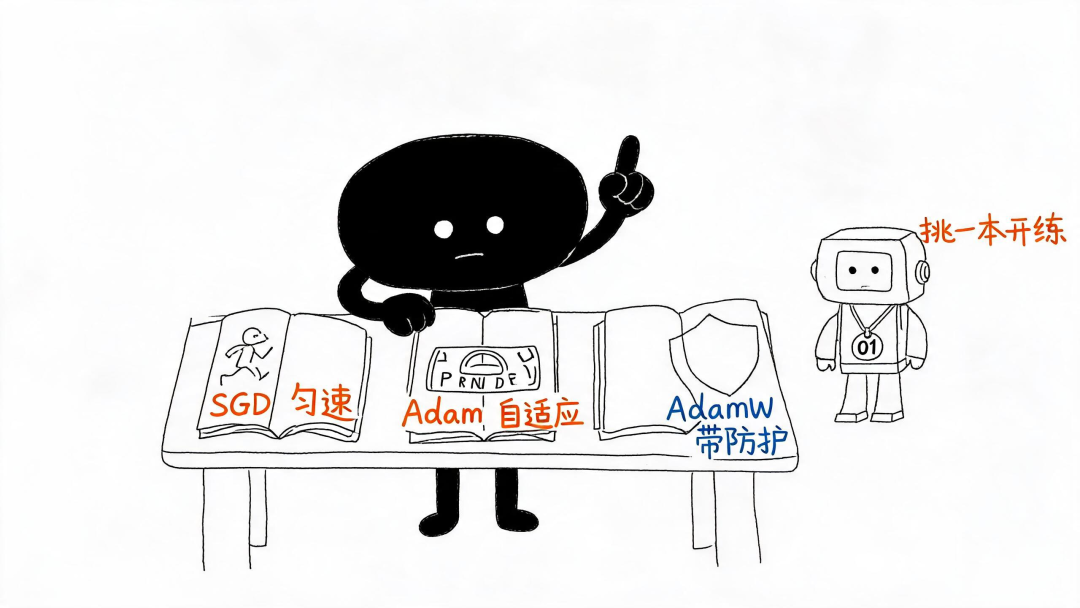
图4 私教方案——SGD 匀速慢跑、Adam 自适应配速、AdamW 带防护(Transformer 标配);model.parameters() 点旋钮、lr 定步幅
5三步循环训练循环的固定动作
健身房墙上那块三步流程牌,是整个训练循环的心脏。在训练循环中,优化器通过以下三个步骤进行优化:
→ 撕掉旧成绩单——optimizer.zero_grad():重设模型参数的梯度。默认情况下梯度会累加,为了防止重复计算,每个训练阶段开始前都需要清零梯度(第二十八站账房"清账"的老规矩);
→ 复盘找差距——loss.backward():反向传播预测结果的损失,计算损失对每一个参数的偏导(账房倒查账本,grad 落到每个参数名下);
→ 调整训练量——optimizer.step():根据梯度调整模型的参数(私教照差距拧旋钮)。
把三步嵌进 DataLoader 的循环里就是完整的 train_loop:逐批取 (X, y) → model(X) 前向出 logits → loss_fn 算损失 → 三步走 → 下一批。原文的代码每 100 批打印一次 loss 和进度,训练是否有效一目了然。
三步顺序不可颠倒:先 zero(撕单)再 backward(复盘)后 step(更新)。忘了 zero_grad 会梯度累加——损失不降反升的经典病因。
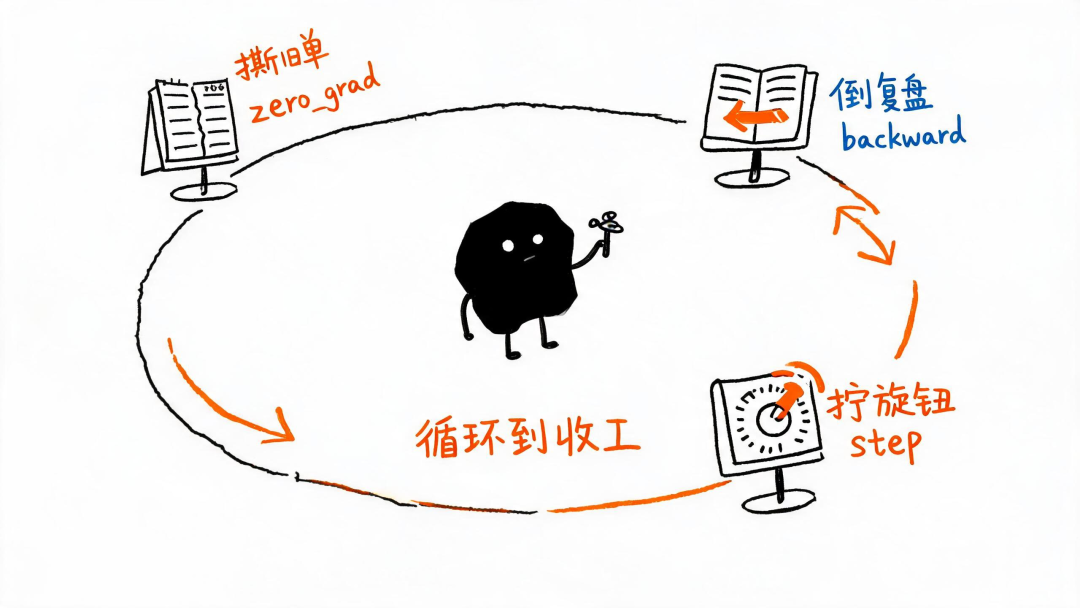
图5 三步循环——zero_grad 撕旧成绩单 → backward 倒复盘 → step 拧旋钮更新;沿环循环,批批如此、轮轮如此
6双档开关与三轮特训train/eval与实战
开考之前必须扳的开关:model.train() 与 model.eval()。训练循环开头调 train() 开"训练档"——Dropout 护具随机收紧(随机丢弃)、batch normalization 用批统计;测试循环开头调 eval() 换"考试档"——护具全开、行为稳定。原文明确警告:一定要在预测之前调用 model.eval() 将 dropout 层和 batch normalization 层设置为评估模式,否则会产生不一致的预测结果。测试循环还包一层 torch.no_grad()——考试不记账,省内存又提速(第二十八站"此段不记账"的牌子派上用场)。
全部凑齐,上原文的完整实战:FashionMNIST、CrossEntropyLoss、AdamW、lr=1e-3、batch=64、epochs=3。三轮战报——
→ 第 1 轮:训练损失从 0.94 一路波动下降,测试集准确率 83.7%;
→ 第 2 轮:损失整体再降,准确率 85.4%;
→ 第 3 轮:平均损失降到 0.36,准确率 87.2%——三轮爬升 3.5 个百分点,且训练损失与测试准确率同步改善,证明优化器成功调整了参数、没有过拟合。
这三十行代码就是深度学习训练的完整骨架:数据加载(上一站)、模型构建、损失、优化器、三步循环、双档开关——往后所有训练代码,包括第七章的微调,都是这套骨架的变奏。
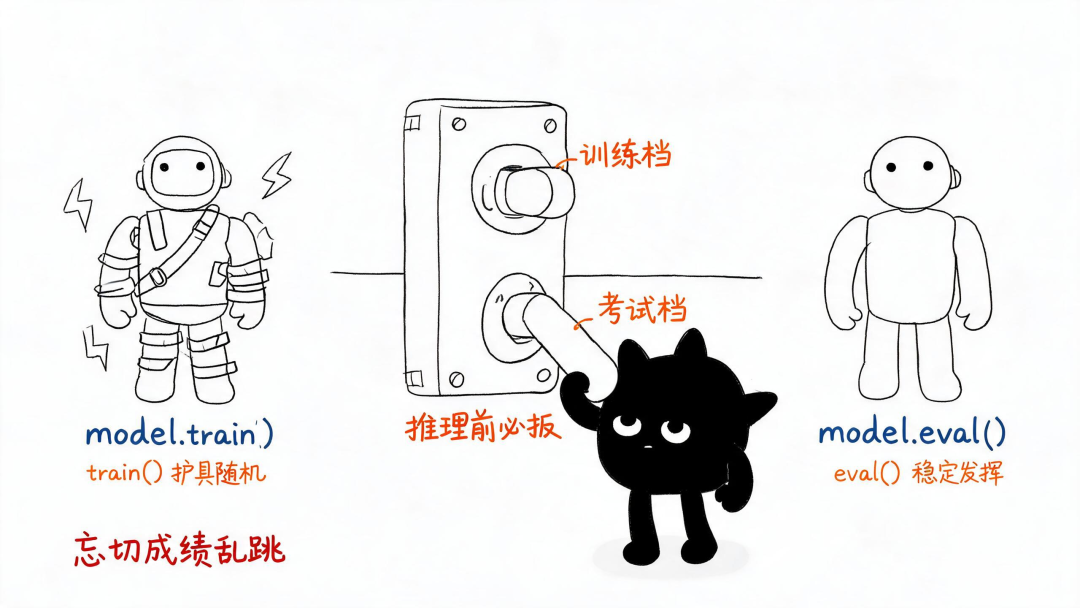
图6 双档开关——train() 训练档护具随机(Dropout 生效)、eval() 考试档轻装稳定;推理前必扳,忘切成绩乱跳
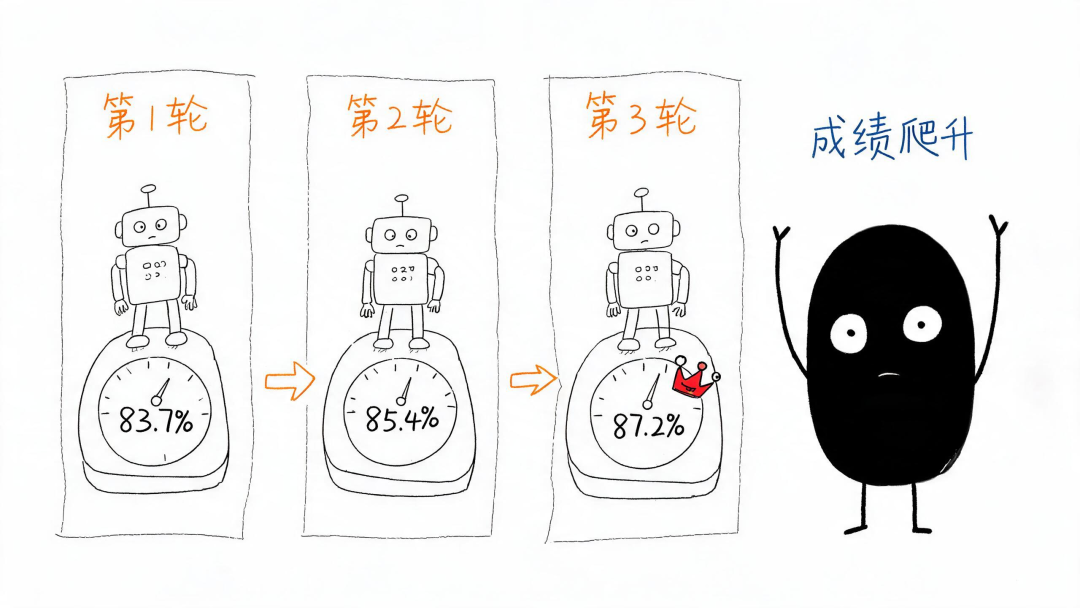
图7 三轮特训——FashionMNIST 实战:第 1 轮 83.7% → 第 2 轮 85.4% → 第 3 轮 87.2%,指针步步逼近目标,训练循环验证有效
训练处方一张:nn.Module 照图纸组装(__init__ 点零件、forward 写流程、Sequential 串流水线);损失函数当体重秤(回归 MSE、分类 CrossEntropy);优化器当私教(SGD/Adam/AdamW + lr);三步循环 zero_grad → backward → step;双档开关 train/eval 每轮切换。
预测、称重、倒查、更新——四个动词循环到底,模型就练出来了。
练出来的本事得存起来带走,换个机器还能接着用——下一站(也是本章最后一站),小黑开行李打包店。
小黑怪诞配图 × Transformer图解 · 2026
本文转载自微信公众号「大头酱瓜」,仅供学习交流使用。
觉得内容不错?我要