
什么是数值精度? FP32/FP16/BF16/FP8通俗完整对比
本文来源: IT孙磊(公众号:IT孙磊)
原文链接: https://mp.weixin.qq.com/s/9i4BXM48W3Wsu6hkRSaJ8Q
发布时间: 2026-09-13 06:09
作者: IT孙磊 发布时间: 2026-09-13 06:09
本期摘要
前面我们理解了上下文窗口,知道模型一次最多能看多少Token。但所有的参数、张量、计算,本质上都属于数字。同样一组模型,为什么在不同显卡上跑,速度、效果不一样?核心就在于数值精度。
欢迎来到《大模型底层技术通俗解读》系列。本系列用生活化类比,带你一步步读懂大模型底层技术。
前面我们理解了上下文窗口,知道模型一次最多能看多少Token。但所有的参数、张量、计算,本质上都属于数字。同样一组模型,为什么在不同显卡上跑,速度、效果不一样?核心就在于数值精度。
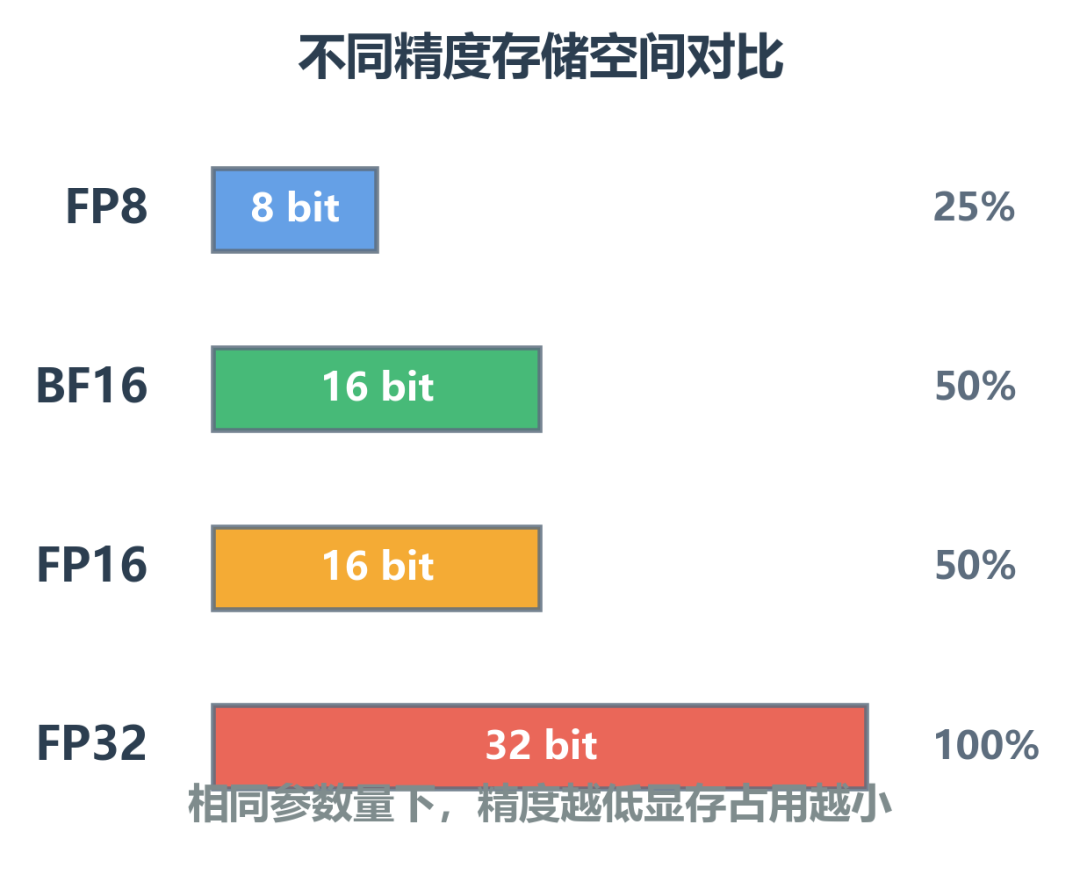
▲ 四种精度的存储空间占用:bit数越少,显存占用越小
厨房类比:精度是称量的秤
继续沿用厨房类比:数值精度 = 厨师称量调料的秤
- FP32
:高精度电子分析天平,可以称出极微小重量,误差极小,但称重慢、设备成本高
- FP16/BF16
:厨房高精度电子秤,足够精细,称重速度快,性价比高
- FP8
:简易秤,刻度少,称重速度最快,但微小重量容易出现误差
什么是数值精度?
在计算机底层,模型参数、中间计算结果,全部以浮点数保存。数值精度,就是存储一个数字占用多少比特,代表数字能保留多少有效细节。
比特越多,能记录的数字越精细,误差越小;比特越少,保存的数字越粗糙,占用的显存、算力也越少。
四种主流精度通俗拆解
1. FP32(单精度浮点数,32bit)
- 占用32个比特存储一个数字
- 精度最高,数值表示范围广,几乎没有计算误差
- 缺点:占用空间巨大,计算速度慢,显存消耗高
- 大模型训练早期曾经使用,现在推理几乎不会全用FP32
2. FP16(半精度浮点数,16bit)
- 16比特存储,精度不错,但数值表示范围比较窄
- 遇到数值特别大或者特别小的时候,容易溢出出错
- 适合图像、传统科学计算
- 大模型训练/推理会有限使用
3. BF16(Brain Float 16,16bit)
- 同样16bit,和FP16占用空间一样
- 牺牲一点点小数精度,换取更大的数值范围,不容易溢出
- 这是现在大模型训练、原生推理最主流的精度
- AI芯片原生优化,大模型训练基本首选BF16,兼顾速度和稳定性
4. FP8(8bit浮点数)
- 仅8比特,体积只有BF16的一半
- 存储极小、计算极快,显存压力大幅降低
- 代价:精度损失更大,数值误差变多,需要配套算法做补偿
- 当下新一代算力卡主推的推理精度
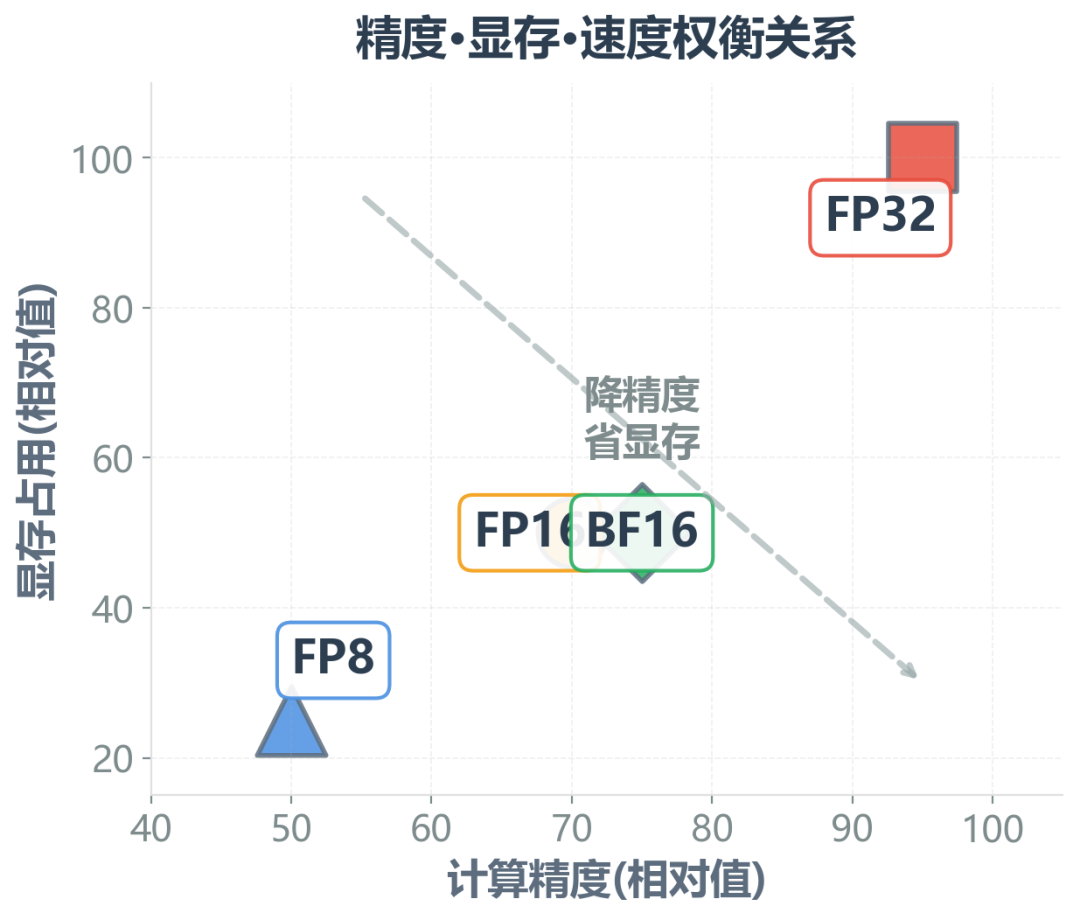
▲ 精度越高显存越大但误差越小,精度越低速度越快但误差增加
核心底层逻辑:精度到底影响什么?
很多人误以为精度是直接决定模型"智商"。其实不是。数值精度影响两件事:
- 存储
:精度bit越少,参数占用显存越少,能加载更大模型
- 计算
:芯片一次能并行算更多低精度数字,吞吐更高、速度更快
但代价:低精度会丢失数字的微小细节,积累计算误差。误差积累严重时,模型推理会变不稳定,幻觉增多。
训练和推理,精度选择完全不一样
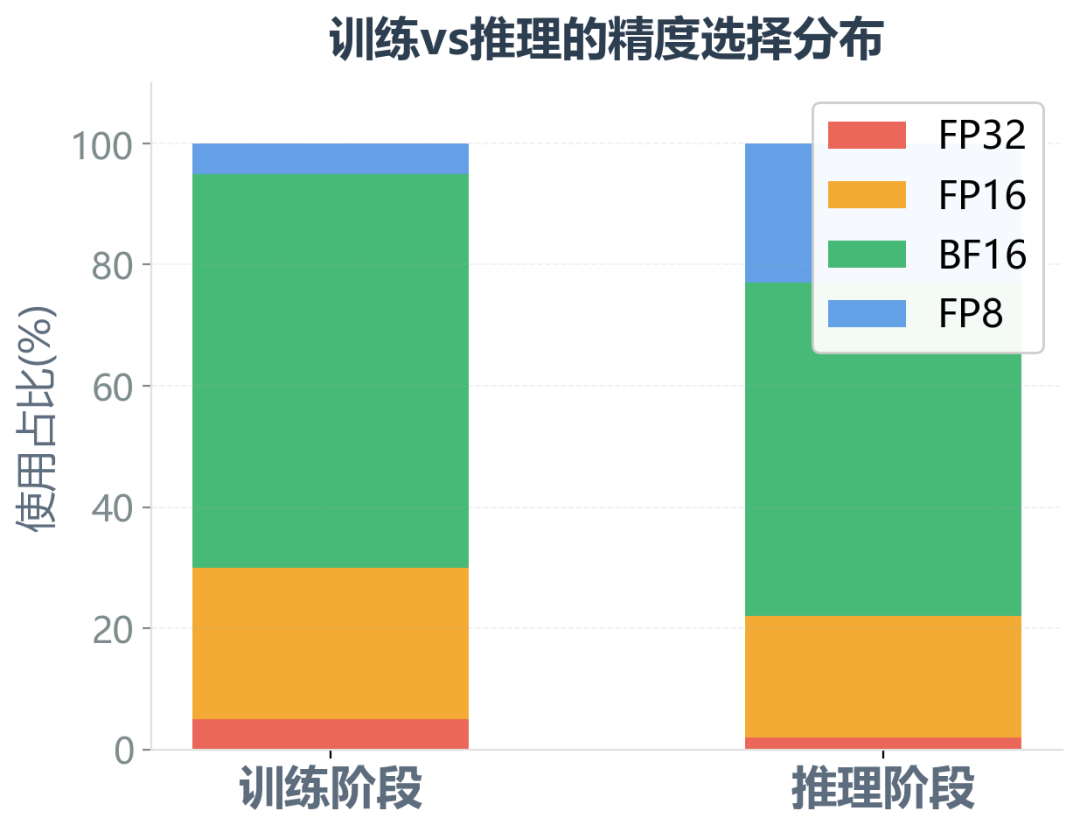
▲ 训练阶段BF16占主导,推理阶段FP8使用比例明显提升
| 阶段 | 主流精度 | 核心考量 |
|---|---|---|
| 模型训练 | BF16为主 | 对误差敏感·误差累积影响大 |
| FP16辅助 | 部分场景混合精度训练 | |
| 极少FP8 | 训练不能随便降精度 | |
| 模型推理 | BF16基准 | 误差容忍度更高 |
| FP8加速 | 想要提速省显存可切换 | |
| 几乎不用FP32 | 推理成本太高 |
关键区别:
- 训练阶段
:对误差敏感,大多采用BF16,部分场景混合精度FP16;极少用FP8训练。训练不能随便降精度,误差会不断累积,模型学不会知识
- 推理阶段
:误差容忍度更高。BF16是基准;想要提速省显存,可以切换FP8。FP32推理几乎不会用,成本太高
实际案例对比
同样一个7B模型,使用不同精度推理:
| 精度 | 显存占用 | 推理速度 | 精度损失 | 适用场景 |
|---|---|---|---|---|
| FP32 | 28GB | 基准 | 无损失 | 科学计算·极高精度要求 |
| BF16 | 14GB | 2倍 | 极小 | 标准推理·主流选择 |
| FP8 | 7GB | 3-4倍 | 小 | 高并发·成本敏感场景 |
| INT8量化 | 7GB | 4-5倍 | 中等 | 边缘部署·极致压缩 |
从FP32到BF16,显存减半、速度翻倍,精度损失几乎可忽略,这是为什么BF16成为主流的原因。
高频误区纠正
误区1:精度越高,模型回答一定越聪明
错。模型的知识藏在参数里面,不是精度。BF16和FP32推理同一个模型,回答效果差距很小。精度只控制数字保存的精细程度。
误区2:BF16 = FP16
错!虽然都是16bit,底层设计目标完全不同。FP16适合传统计算,BF16专门为大模型设计,数值范围更大,不容易溢出。
误区3:FP8就是量化
不完全等同。FP8属于浮点低精度,而4bit/8bit量化大多是整数量化,二者底层存储格式不一样,很多人会混淆。
误区4:降精度一定会损失效果
不一定。从FP32降到BF16,效果几乎无损。关键看降精度的幅度和模型对误差的敏感度。
选型建议
1. 训练场景
- 首选BF16,行业标准配置
- 混合精度训练:关键层用FP32,其他层用BF16
- 不建议直接用FP8训练,误差累积风险高
2. 推理场景
- BF16作为基准,效果稳定
- 高并发场景可降到FP8,换取吞吐量
- 成本敏感场景结合INT8量化,进一步压缩
3. 硬件适配
- NVIDIA A100/H100原生支持BF16和FP8
- 老卡(V100)只支持FP16,不支持BF16
- 新一代GPU对低精度优化更好,FP8加速明显
本篇小结
- 数值精度就是存储数字的比特位数,相当于计算用的秤。bit越多,数字记录越精细
- FP32精度最高、开销最大;BF16是大模型主流16位精度;FP8是新一代低精度浮点方案
- 训练对精度更敏感,主流用BF16;推理可以选用更低精度换取速度和显存
- 精度不会凭空提升模型知识,只会改变计算误差、显存占用与推理速度
- BF16相比FP32显存减半速度翻倍且效果几乎无损,是当前最优平衡点
术语速查
| 名词 | 通俗解释 |
|---|---|
| 浮点数 | 带有小数点的数字,模型参数与中间计算结果都用浮点数保存 |
| FP32 | 32位单精度浮点数,精度最高,显存开销大 |
| FP16 | 16位半精度浮点数,数值范围窄,传统计算常用 |
| BF16 | 16位脑浮点数,专门为大模型设计,AI训练首选 |
| FP8 | 8位浮点,体积小速度快,新一代推理常用方案 |
| 混合精度 | 训练时不同层使用不同精度,平衡效果与速度 |
下期预告
- 什么是量化?INT8/INT4量化技术通俗解读
看懂了浮点精度,下一篇我们讲更激进的降精度方案:量化技术,如何把模型体积压缩到极致。
看完有启发的话,点个"关注和❤️"再走
本文包含AI辅助创作内容,作者已审核并对全文负责
本文转载自微信公众号「IT孙磊」,仅供学习交流使用。
觉得内容不错?我要