
PD分离:GPU 做 prefill、NPU 做 decode,异构 PD 分离卡在哪
本文来源: Arthur(公众号:Arthur)
原文链接: https://mp.weixin.qq.com/s/7RInEq-GoIC3JOpCFOkiyA
发布时间: 2026-10-30 09:05
作者: Arthur 发布时间: 2026-10-30 09:05
原文:HAWK: Heterogeneity-Aware KV Cache Transfer for Efficient GPU-NPU Phase-Disaggregated LLM Inference
一句话概括
把 prefill 放在 GPU、decode 放在 NPU,理论上能同时拿到"快"和"省"。难点不在两边的 kernel,而在中间那一次 KV cache 搬运:两个设备的通信栈不一样,tensor 在内存里的排布也不一样。HAWK 的做法是把两边都挂到同一条 RDMA 栈上直连显存,并让 NPU 侧的接收 buffer 按目标 tensor layout 分配,使数据"落盘即用"。真实 GPU+NPU 系统上,同 SLO 下吞吐只比纯 GPU 系统低 7.88%,但能效高 1.26 倍、成本效率高 1.72 倍。
一、为什么想把 decode 交给 NPU
先说一个几乎所有推理工程师都熟悉的观察:prefill 和 decode 是两种完全不同的负载。prefill 一次处理整段输入,是 GEMM,能喂满 tensor core;decode 一次只出一个 token,是 GEMV,tile 级并行度和数据复用都很低,tensor core 大量空转,同时还要把整份 KV cache 从 HBM 里读出来。
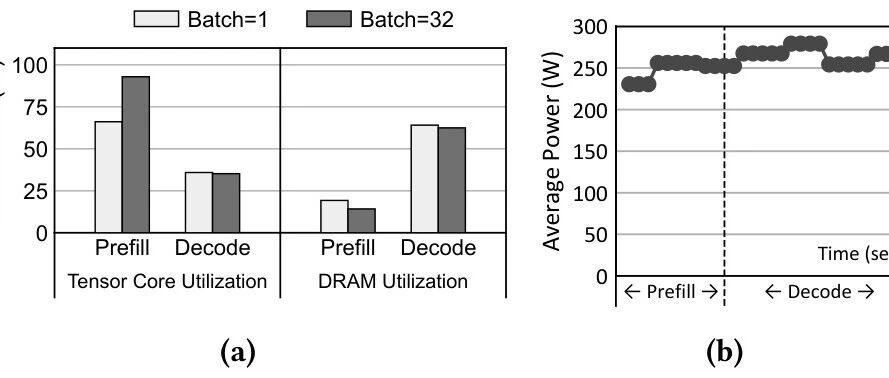
论文在 A100 上用 Nsight Compute 量了这个差距:QKV projection 这个 kernel 在 prefill 阶段 tensor core 利用率约 92.92%、DRAM 利用率约 19.26%;到了 decode,tensor core 掉到 35.90%,DRAM 反而升到 64.09%。一个 decoder layer 里的其它 kernel 也是同样的形状——decode 阶段 tensor core 利用率普遍只有 22%–39%,DRAM 利用率 36%–72%。
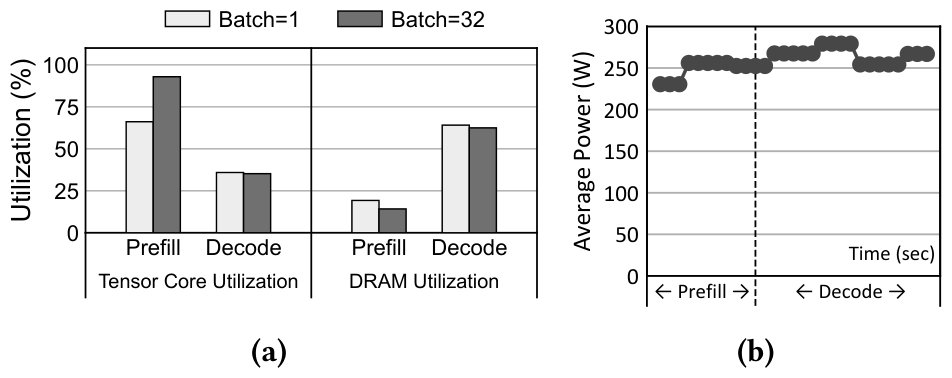
图 1:QKV projection kernel 在 prefill/decode 两个阶段的 tensor core 与 DRAM 利用率,以及板级功耗随阶段的变化。decode 阶段算力闲置、带宽吃紧,而功耗并没有随之下降。
更麻烦的是功耗。既然 decode 阶段 tensor core 大量闲着,直觉上功耗应该跟着降;实测板级功耗在两个阶段基本持平。也就是说,decode 在 GPU 上不仅算得慢,能效也差——这正是"换一种硬件做 decode"的动机。
论文拿 NVIDIA A100 和 Tenstorrent p150a(一颗 dataflow 风格的 NPU)做了同条件对比(512 输入 token、128 输出 token、batch 32):
| 指标 | A100 | p150a | 结论 |
|---|---|---|---|
| Prefill 吞吐(token/s) | 133.16 | 52.74 | GPU 快 2.52 倍 |
| Decode 吞吐(token/s) | 15.27 | 13.17 | 只差 1.16 倍 |
| Decode 能效(token/s/kW) | 77.11 | 107.20 | NPU 高 1.39 倍 |
| Decode 成本效率(token/s/千美元) | 0.40 | 2.35 | NPU 高 5.88 倍 |
表 1:A100 与 Tenstorrent p150a 在 LLM 推理两个阶段的对比。prefill 差 2.52 倍,decode 只差 1.16 倍,而 decode 的能效与成本效率 NPU 明显更好。
这张表就是整篇论文的商业逻辑:prefill 用 GPU,decode 用 NPU,把两种硬件的强项拼起来。
为什么 NPU 在 decode 上反而利用率高?论文的解释是 dataflow 架构对片上 buffer 和"计算—访存"调度有显式控制,可以在 decode 阶段少开一些计算核(比如 FFN 用 8 个核而不是 prefill 的 64 个),并优先选离 DRAM 更近的核,让有限的并行度集中在少数核上跑满。按"实际吞吐 ÷ 所用计算核的峰值吞吐"计算,NPU 在 QKV、attention、output projection、FFN 四类 kernel 上的计算利用率分别是 79.06%、8.34%、74.33%、81.46%,而 A100 只有 11.93%、1.67%、11.20%、13.44%。
| 操作(decode 阶段) | 计算利用率 GPU | 计算利用率 NPU | 能效 GPU(TFLOPS/kW) | 能效 NPU(TFLOPS/kW) |
|---|---|---|---|---|
| QKV projection | 11.93% | 79.06% | 226.82 | 167.59 |
| Attention | 1.67% | 8.34% | 22.64 | 28.34 |
| Output projection | 11.20% | 74.33% | 213.00 | 157.55 |
| FFN projections | 13.44% | 81.46% | 255.47 | 258.99 |
表 2:decode 阶段各 kernel 的计算利用率与能效。注意"利用率"的分母是各自实际启用的计算核,所以 NPU 高利用率不等于吞吐更高——它的绝对吞吐仍略低于 GPU。
这里要提醒一句:表 2 的高利用率有口径问题——分母是"该 kernel 实际用到的计算核峰值",NPU 主动少开核,利用率自然好看。真正的吞吐差距还是表 1 里那 1.16 倍。论文并没有回避这一点,它把 NPU 的定位说成"decode 性能可比、效率更高",而不是"更快"。
二、异构系统的两个硬骨头
PD 分离(prefill-decode disaggregation)本身已经是成熟工程:prefill 实例算完首 token 和 KV cache,把 KV cache 传给 decode 实例。纯 GPU 集群里这条路走得很顺,NIXL、Mooncake 这类传输引擎可以直接让网卡 DMA 读写 GPU 显存。
换成 GPU→NPU,问题来了两层:
第一层,通信栈不通。 NPU 的通信机制往往是厂商私有的,和 GPU 的 peer memory 机制不通用。最省事的办法是"主机中转"(host staging):GPU→主机内存→NPU,但代价是两次额外拷贝加主机介入。论文实测,即使在 GPU 与 GPU 之间,主机中转的延迟就是直连的 1.83 倍到 5.25 倍(传输量从 10MB 增到 1.2GB)。跨异构设备只会更糟。
第二层,tensor 在内存里的排布不一样。 这是更隐蔽、也更难缠的问题。GPU 上 tensor 按行/列主序映射到一段虚拟连续地址,硬件再按固定粒度(如 256B)交错到多个 DRAM channel;NPU 则倾向于显式决定"哪块数据放哪个 DRAM 分区",以便把数据放到离计算单元更近的位置,形成 tiled/blocked 布局。
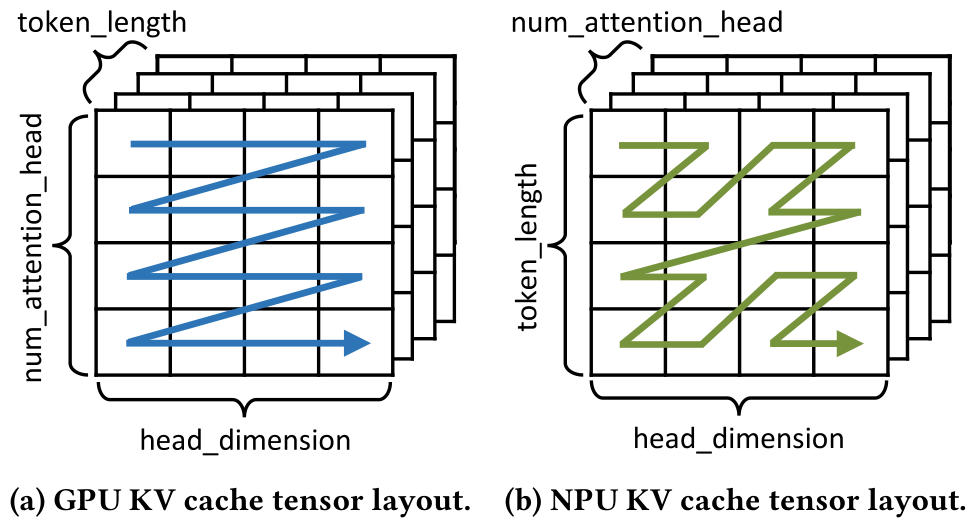
图 2:GPU 与 NPU 的 KV cache tensor layout 对比——维度顺序、元素到虚拟地址的映射、以及在 DRAM channel 上的分布都不同。
排布不同意味着:就算你把字节一个不少地传过去,NPU 也没法直接把它当 tensor 用,还得在 NPU 上做一次重排;而重排要跨 DRAM channel 搬数据,代价很高。论文提到一种"偷懒"方案是强制一边采用另一边的 layout,但每个 layout 都是为自己那套访存路径优化的,强行统一会拖慢 kernel,还得改计算核。
三、HAWK 的三个设计
HAWK 的整体结构和普通 PD 分离没有区别,改动集中在数据通路上。图 3 是它的四步流程:建立直连 RDMA 路径、在 GPU 侧做传输友好的变换、按 NPU layout 分配 RDMA buffer、NPU 直接消费。
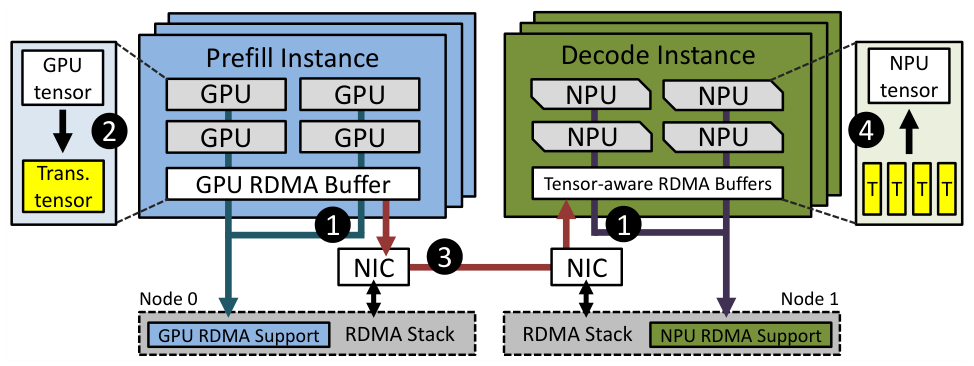
图 3:HAWK 系统总览——统一 RDMA 栈直连两侧显存,GPU 侧做部分 layout 变换,NPU 侧按目标 layout 分配 per-channel RDMA buffer。
3.1 让网卡直接看见 NPU 的显存
GPU 侧本来就有一个 peer memory client,把 GPU 显存注册给 RDMA 子系统,让网卡能直接 DMA。HAWK 做的事情对称:在 NPU 驱动里实现一个同类的 peer memory client,向上暴露同样的语义。核心是五个回调:
npu_acquire:判断 RDMA 子系统请求的地址范围是否属于 NPU 显存
npu_get_pages:取出这段地址对应的 NPU 物理页
npu_dma_map:把这些页映射成网卡可访问的 DMA 地址
npu_dma_unmap:释放映射
npu_put_pages:归还页引用
有了这层,NPU 显存就和 GPU 显存一样,成为 RDMA 栈里的"可注册内存",上面直接复用 Linux 的 ib_core 和 libibverbs,再往上接 Mooncake 的传输引擎。
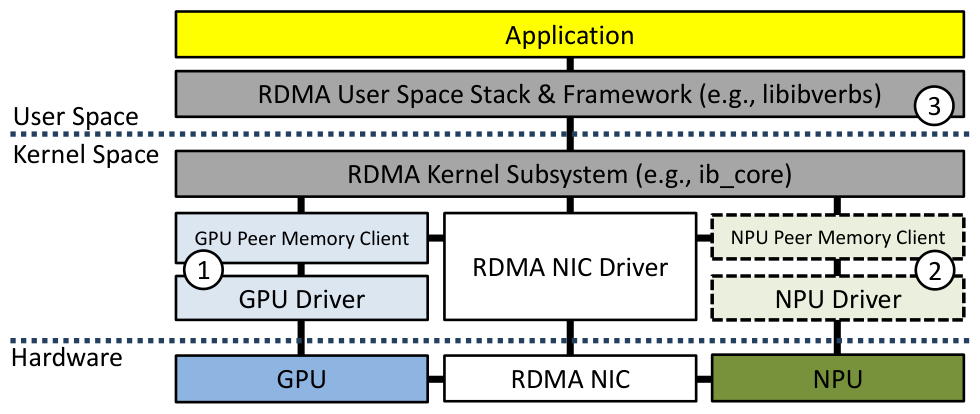
图 4:统一 RDMA 栈——GPU 与 NPU 各自提供 peer memory client,向同一个 RDMA 内核子系统注册显存。虚线框是 HAWK 扩展的部分。
这是整篇论文工程量最大、也最"不性感"的一块:它不是算法创新,但没有它后面所有优化都无从谈起。做异构系统的同学应该有共鸣——真正卡住项目的往往是这种驱动层的对接。
3.2 为什么不能给 NPU 分配一块连续 buffer
传统 RDMA 习惯分配一大块虚拟连续 buffer,元数据简单、请求构造简单。这在 GPU 上没问题,因为 GPU 的地址映射本来就是连续的。但在 NPU 上,一个 tensor 的地址是一组"指针—长度"对:
npu_tensor T ≡ {(ptr_ch0, size_ch0), (ptr_ch1, size_ch1), …}
每个指针对应一个 DRAM channel 里的一段。而一块连续 buffer 只有一对 (ptr, size),它的线性地址布局和 NPU tensor 的分布对不上。
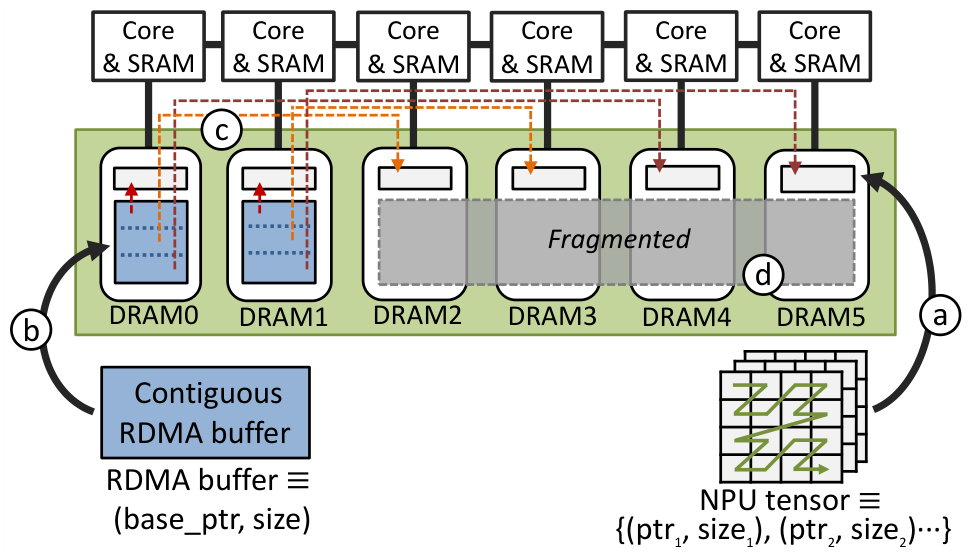
图 5:NPU tensor 与等大小连续 buffer 的物理内存布局差异——tensor 分散在多个 DRAM channel,连续 buffer 的落点则是另一种分布。
这会带来两个后果。轻的是"传完还得再调一次":数据在 buffer 里的位置和目标 tensor 不一致,得再做一次跨 channel 的重排。重的是内存碎片导致 OOM:连续 buffer 的落点和 NPU 的 tensor 分配策略不一致,会让各 DRAM channel 的占用严重不均,某些 channel 先满,即使总量还有富余也分配不出新 tensor。
这不是理论担忧。论文实现了一个"直连 RDMA + 单块连续 buffer"的对照原型,结果在 serving 时直接 OOM,只能把它从定量对比里剔除。
所以 HAWK 改成按目标 tensor layout 分配 RDMA buffer:每个 DRAM channel 一块虚拟连续的 buffer,一组 buffer 拼起来正好对应一个 NPU tensor 的形状。代价是 buffer 数量和 RDMA 请求数变多,但 channel 数通常不超过十个,每块 buffer 内部仍然连续,管理开销可控。论文为此加了几个 C++ 接口:map_buffer_dma、get_device_num_bank、get_buffer_address_bank、get_buffer_size_bank、unmap_buffer_dma——本质上是让上层能"按 bank 申请、按 bank 寻址"。
3.3 把 layout 变换拆成两半,一半藏在传输里
最后一个问题是:谁来付 layout 变换的代价?
如果在 GPU 上做完整变换,需要把 tensor 完全重排成 NPU 的目标形状——这是一次全量数据搬移,代价随 tensor 大小线性增长。如果在传输时逐元素散写到 NPU 的目标位置,RDMA 请求会被切得极碎(每次只有几百字节),协议开销直接吃掉收益。
HAWK 取中间路线,把变换拆成两步:
第一步,在 GPU 上做部分对齐:重排维度顺序和元素,把"将要去往同一个 NPU channel buffer"的数据在地址上排成连续的大块。变换后的形状是
shape(G) = [Nl, L, Nh, Nhd] → shape(G') = [Nch, −1, tile_chunk]
这里 N_ch 是 NPU 的 DRAM channel 数,tile_chunk 是 NPU 的 tile 大小(以元素计)。这样每个 channel 对应的数据在 GPU buffer 里是一段连续区间,一次 RDMA 就能传一大块。
第二步,在传输过程中完成剩余对齐:把 GPU buffer 里第 i 段连续区间,映射到 NPU 第 i 个 channel 的 buffer 上;由于第一步已经把元素顺序调成目标顺序,数据落到 NPU buffer 时就自然符合目标 layout,解码时可以直接消费,不需要后处理。
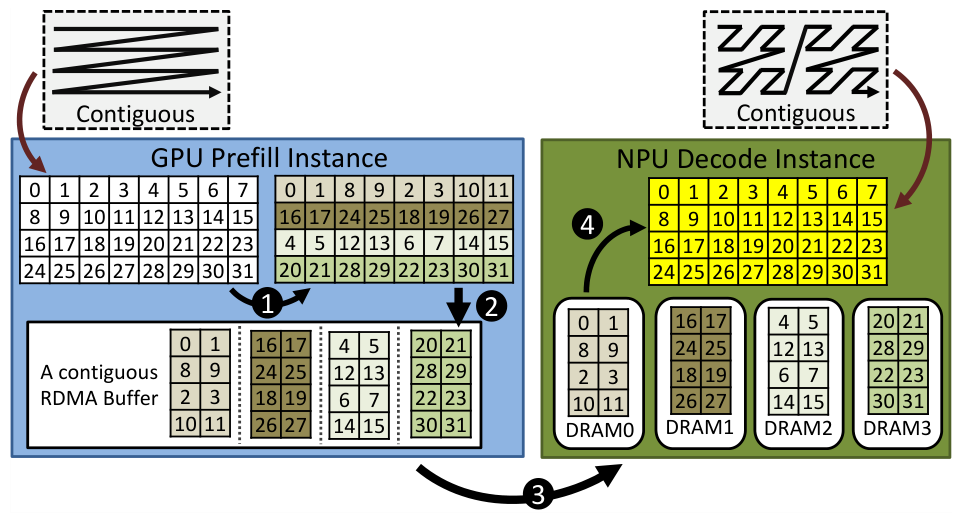
图 6:两步变换——先在 GPU 上部分对齐并聚成 per-channel 大块,剩余对齐在 RDMA 写目标 buffer 的过程中完成。
这个设计有个容易被忽略的前提:变换本身要花 GPU 的显存带宽。论文选择在 prefill 实例上做,理由是 prefill 阶段访存压力比 decode 小,有带宽余量。这个假设在 prefill 很长、batch 很大时是否成立,论文没有单独测——这属于设计上的"合理但未验证"。
四、实测:传输只差 0.65%,端到端差 7.88%
实验平台是两台节点:prefill 用 4 张 A100 PCIe 40GB,decode 用 4 张 Tenstorrent p150a,节点间 200Gbps HDR InfiniBand + ConnectX-6,软件是 vLLM 0.10.0,模型 Llama 3.1 70B,每实例 TP=4。对比四组配置:
GG-Host:GPU prefill + GPU decode,KV cache 走主机中转
GN-Host:GPU prefill + NPU decode,KV cache 走主机中转 + NPU 侧重排
GG-Direct:GPU prefill + GPU decode,KV cache 走 RDMA 直连
GN-HAWK:GPU prefill + NPU decode,KV cache 走 HAWK
先看纯传输延迟(从 decode 实例发起请求,到 KV cache 落进本地 cache pool):
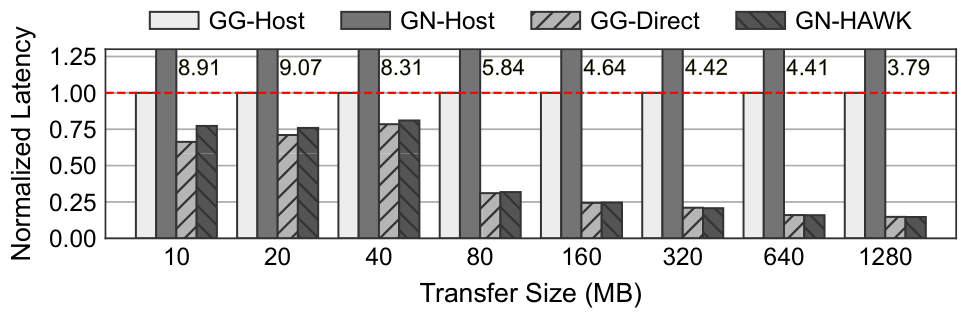
图 7:不同传输尺寸下的端到端 KV cache 传输延迟(归一化到 GG-Host)。HAWK 与 GPU-GPU 直连几乎重合。
几个关键数字:
主机中转的代价随规模放大而收敛但仍然很大:GN-Host 从 8.91 倍(10MB)降到 3.79 倍(1280MB)GG-Host 的延迟
直连把延迟压到 GG-Host 的 66.30%(10MB)到 14.77%(1280MB)
HAWK 是 GN-Host 的 77.25% 到 14.69%
折算下来,HAWK 比主机中转快最多 27.69 倍,和 GPU-GPU 直连的差距只有 0.65%
也就是说,跨异构设备传输这件事,HAWK 已经做到和同构直连基本无差别。这是全文最扎实的一个结果。
再看端到端 serving。两个负载:Chatbot(ShareGPT,输入均值 783 token、输出 140)和 Summarization(LongBench,输入均值 2186、输出 86),SLO 按 MLPerf 设为 TTFT/TPOT = 2000ms/200ms 和 15000ms/200ms。
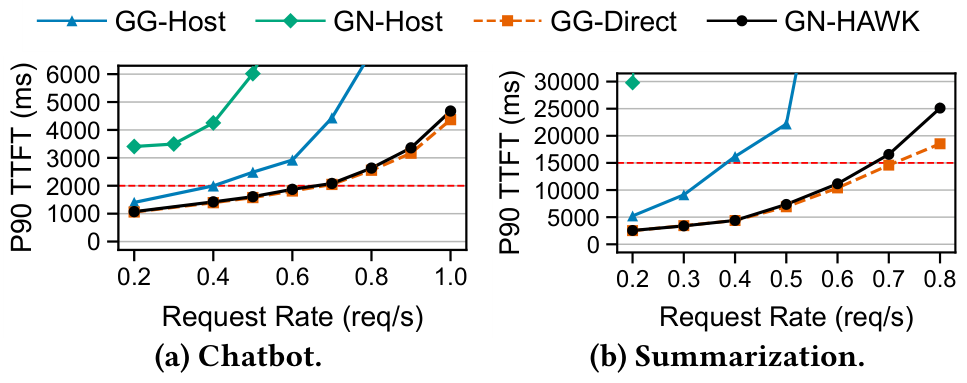
图 8:P90 TTFT 随请求速率变化。90% SLO 达成点上,HAWK 与 GPU 直连的可持续请求速率只差 2.90%(Chatbot)和 5.90%(Summarization)。
TTFT 是对传输最敏感的指标,也是 HAWK 最能证明自己的地方。主机中转的两个配置在很低请求速率下就顶到 SLO 上限(0.40 和 0.38 req/s),而 HAWK 紧跟 GPU 直连。Summarization 在高速率段还有一点差距,论文归因于请求排队——NPU 软件栈接进 vLLM 后 decode 略慢,反压到 prefill 侧,而不是传输本身。
TPOT 对传输不敏感,主要看 decode 硬件本身。HAWK 的 TPOT 在 Chatbot 上满足 SLO;Summarization 上比 GPU 直连早一点触线(0.60 vs 0.65 req/s),原因是 NPU decode 略慢;请求速率升高、batch 变大后 NPU 效率提升,差距收窄。
综合 SLO 达成率,两者在 90% 达成点的请求速率差 7.69%;90% SLO 下的输出吞吐差 0.48%(Chatbot)和 7.88%(Summarization)。
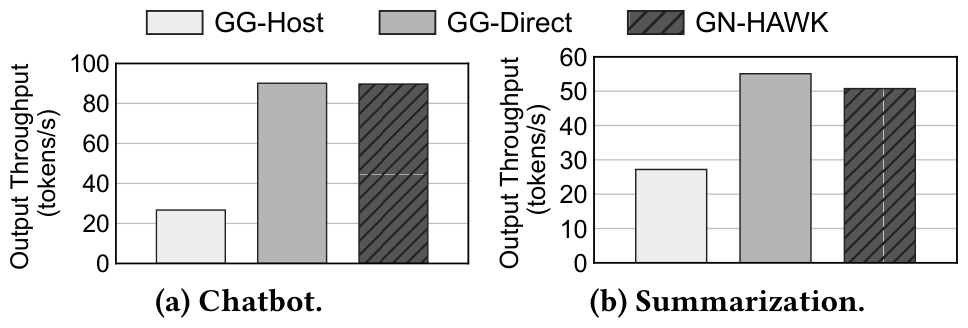
图 9:90% SLO 达成时的输出吞吐对比。GN-Host 因在最低速率下都达不到 90% SLO 被省略。
真正体现价值的是效率:
| 指标(90% SLO 下) | Chatbot GG-Direct | Chatbot GN-HAWK | Summarization GG-Direct | Summarization GN-HAWK |
|---|---|---|---|---|
| 能效(输出 token/s/kW) | 67.09 | 84.48 | 41.01 | 47.18 |
| 成本效率(输出 token/s/千美元) | 1.19 | 2.05 | 0.72 | 1.16 |
表 3:90% SLO 达成点上的能效与成本效率。HAWK 相对 GPU 直连的能效提升为 1.26 倍(Chatbot)和 1.15 倍(Summarization),成本效率提升 1.72 倍和 1.61 倍。
如果对手换成 H100 做 decode(论文叫 GGH-Direct),情况会温和一些,但成本优势更明显:
| 指标(90% SLO 下) | Chatbot | Summarization |
|---|---|---|
| 吞吐(token/s):GGH-Direct → GN-HAWK | 95.96 → 89.69 | 54.28 → 50.75 |
| 能效(token/s/kW):GGH-Direct → GN-HAWK | 81.53 → 83.84 | 45.31 → 46.65 |
| 成本效率(token/s/千美元):GGH-Direct → GN-HAWK | 0.75 → 2.05 | 0.42 → 1.16 |
表 4:decode 侧换成 H100 后的对比。吞吐差距 6.5% 左右,能效基本打平(1.03 倍),成本效率仍有 2.73 倍和 2.76 倍的优势——因为 H100 的单价高。
五、这份工作的边界在哪里
结果很漂亮,但有几个地方需要读者自己打折扣:
第一,只有一种 NPU。 全部实验基于 Tenstorrent p150a,理由是"据作者所知,这是唯一提供开源软件栈、允许做底层修改的 NPU 平台"。这很坦诚,但也意味着:NPU 在 decode 上"利用率高、能效好"的结论,很大程度上绑定在这颗芯片的 dataflow 特性和它的 phase-aware 核分配策略上。论文自己也说其它 NPU 可能通过不同机制取得类似收益——这是推测,不是测量。
第二,功耗口径不完全对称。 GPU 侧报的是用 DCGM 采板级功耗、再用 NVBit trace 喂 AccelWattch 估算 ASIC 占比后折算出的 ASIC 功耗;NPU 侧只能拿到 core power(厂商监控接口只提供这个)。两边都尽量往"ASIC 功耗"靠,但一边是实测+建模、一边是直接读计数器,误差方向不可控。能效 1.26 倍这个数字,量级可信,"精确到小数点后两位"不可信。
第三,成本用的是市场价。 NPU 用厂商官价,GPU 用二手市场挂牌价,作者自己也声明"cost efficiency 仅作参考"。硬件价格波动很大,1.72 倍的成本优势会随采购渠道剧烈变化。
第四,场景覆盖窄。 只测了 Llama 3.1 70B、TP=4、单 prefill 实例 + 单 decode 实例、两种负载。没有 prefill/decode 实例配比扫描,没有多租户,没有 chunked prefill 与 PD 分离的组合。而真实集群里,"prefill 实例该配几个、decode 实例该配几个"恰恰是最影响收益的决策。
第五,性能差距有一部分不是传输造成的。 7.88% 的吞吐差距里,传输只占很小一块(传输延迟已接近 GPU 直连),大头是 NPU decode 本身略慢 + Tenstorrent 栈接进 vLLM 的成熟度。论文明确说 TTFT 的差距来自排队而非传输。所以更准确的表述是:"HAWK 把异构带来的额外开销压到了接近零,剩下的差距是硬件本身的差距"。
第六,代码还没放出来。 文中写的是"we plan to release our implementation as open source",目前没有仓库链接。对想复现的人,这意味着要自己实现 NPU 驱动的 peer memory client——而这恰恰是最难的部分。
六、对做推理系统的人意味着什么
抛开具体数字,这篇论文有三个可以带走的判断:
1. 异构推理的瓶颈通常不在算,而在"搬"和"摆"。 大家讨论异构时容易盯着"谁的 TOPS 高",但真正决定系统能不能跑起来的是:数据能不能直连、落地后能不能直接用。HAWK 花在驱动和 buffer 分配上的篇幅,比花在算法上的多得多。
2. Layout 不是格式问题,是容量问题。 单块连续 buffer 在 NPU 上不只是"慢一点",而是直接把内存搞碎到 OOM。这个结论值得所有做跨设备数据面的人记住:分配策略要跟着目标设备的物理布局走,否则会在最意想不到的地方炸。
3. 变换要拆开付账。 全在源头做,代价是 O(数据量) 的带宽;全在传输时做,代价是请求碎片化。把"能提前做的"放在带宽有富余的阶段(这里是 prefill),把"必须对齐的"塞进 DMA 写目标地址的过程,是这类问题的通用解法。
最后说一句选题判断:这篇论文的价值不在于刷新了某个 SLO 数字,而在于它把一个"大家都知道理论上可行、但没人真做出来"的系统跑通了,并且把工程细节(peer memory 回调、per-channel buffer、两步变换)写清楚了。对做国产加速器软件栈、做异构推理平台的人,这些细节比结论更有用。
本文转载自微信公众号「Arthur」,仅供学习交流使用。
觉得内容不错?我要