
大模型加速优化:KV Cache原理再探
本文来源: 程序员Owen(公众号:程序员Owen)
原文链接: https://mp.weixin.qq.com/s/KCXMPt9enbAJQSaqYyYqZA
发布时间: 2026-10-29 19:37
作者: 程序员Owen 发布时间: 2026-10-29 19:37
一、引言
本文换一个视角——从矩阵乘法出发——重新梳理一遍 KV Cache 的基本原理。以往我们介绍过,KV Cache 的思路其实并不复杂:把中间结果保存下来,下次直接复用,从而省去重复运算;可一旦落到细节,它又常让人犯迷糊。想要真正掌握 KV Cache,关键在于弄明白下面三个问题:
1. 究竟缓存了哪些内容?
2. 为何只缓存 K 与 V,而不把 Q 一并缓存?
3. 引入 KV Cache 会不会改变模型的输出结果?
只要把 attention 的运算过程放到矩阵乘法的视角下审视,上述三个疑问便不难解答。
二、自回归模型的特点
LLM 的推理之所以被称为自回归(autoregressive),是因为模型每一步的输出都会成为下一步的输入。以图中的动图为例,用户给出的 prompt 为“recite the first law $”,模型首先吐出 token“A”;这个“A”随即被拼接到原 prompt 之后,整体再次送入模型,于是又得到“robot”。如此循环往复,直到模型给出表示终止的结束符。
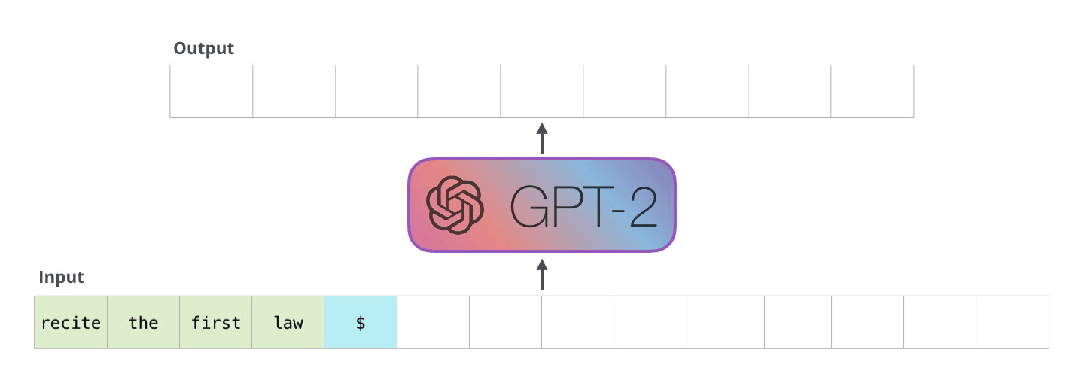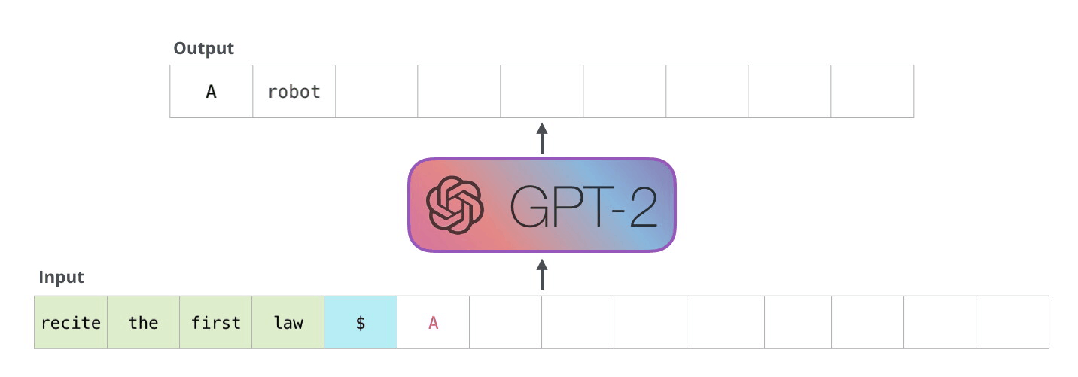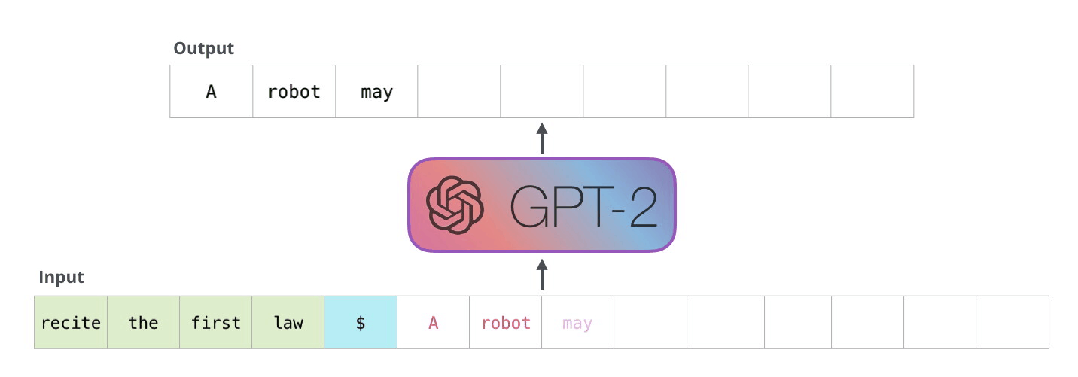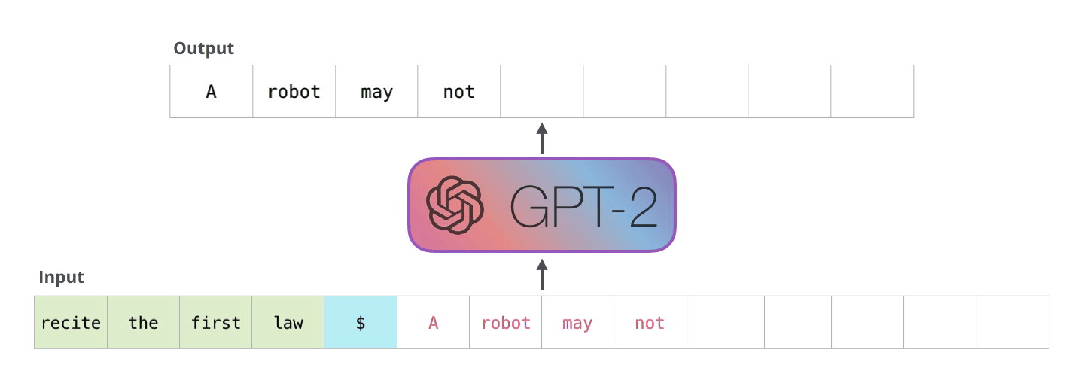
模型每完整跑一遍,我们称之为一个 step;而每一个 step 只产出一个新的token。
三、KV Cache的探索过程
接下来,我们从最原始、不加任何优化的推理方式起步,逐层推导,看看 KV Cache 这一优化手段是如何自然浮现的。为便于说明,这里假定模型只包含两个 attention 层。
不考虑任何Cache的推理
Step 0
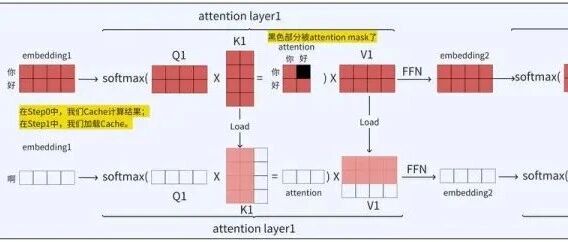
先完全抛开 Cache 不谈,看看推理是怎样进行的。如图 1 所示,我们把“你好”当作 prompt 喂给模型。embedding 层负责将 token 映射为向量(受篇幅所限,图 1 中没有画出这一层),由此得到一个 2×4 的矩阵 embedding1:第一行对应“你”的向量表示,第二行对应“好”的向量表示。
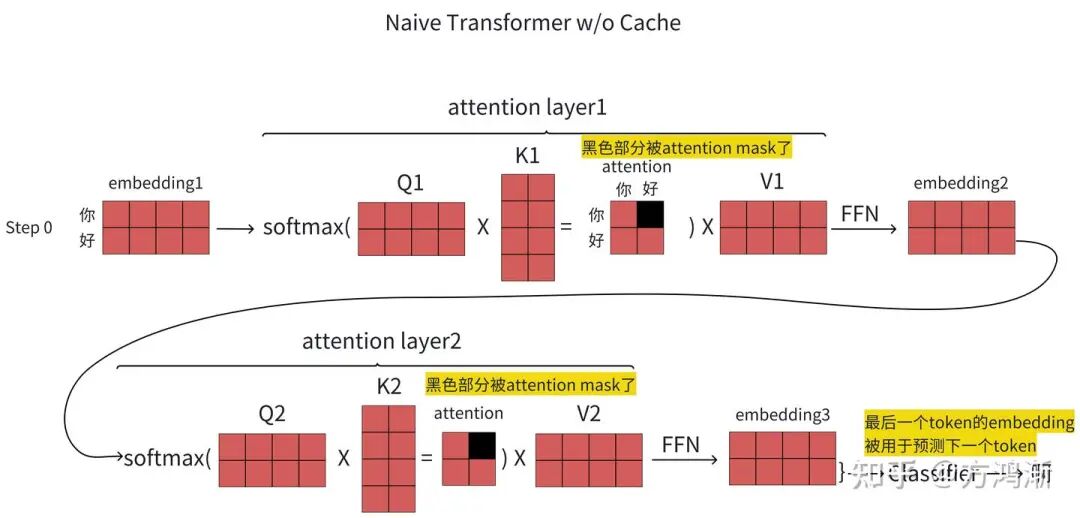
如图 1 之后,数据进入第一个 attention 层。在这里,embedding1 会分别与层内的三个权重矩阵做乘法,从而算出 Q、K、V 三个矩阵,见图 2。
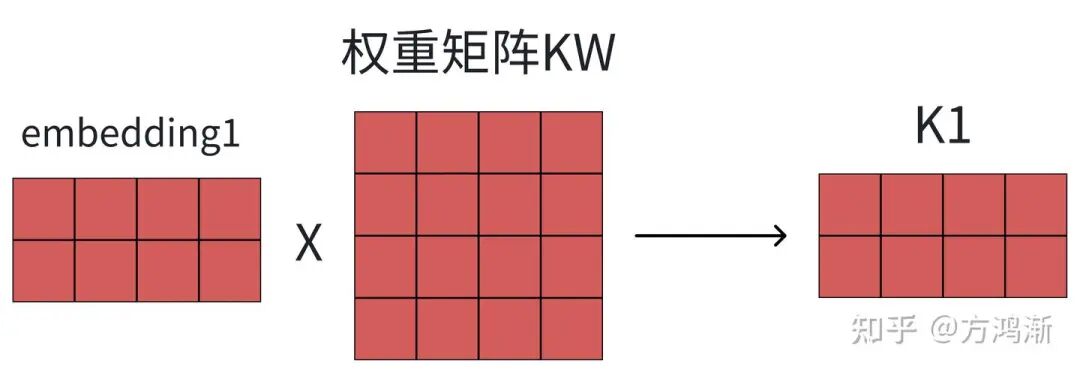
图2
在 attention layer 内部,我们按该层的公式对 Q、K、V 依次做运算。第一步是 Q 与 K 相乘,得到一张 attention 矩阵,矩阵中的每个元素代表两个词之间的注意力权重。举例来说,第二行第一列的数值就是“好”对“你”的注意力大小。这里有一点要特别强调:token“你”对“好”的注意力被 mask 掉了,也就是说,每个 token 只与它前面的 token 计算注意力,后面的 token 不参与。第二步是让 attention 矩阵与 V 矩阵相乘,结果再送入 FFN 层(FFN 与我们讨论的 KV Cache 无关,此处忽略),最终产出新的 embedding2。
第二个 attention 层的处理方式完全相同,最终给出 embedding3。
最后,只把 embedding3 的最后一行——也就是“好”所对应的向量——送进分类器去预测下一个 token,预测结果为“啊”。至此,第一个 token 被生成出来,step 0 宣告完成。
Step 1
拿到“啊”之后,我们把“你好啊”重新送入模型,如图 3 所示。与 Step 0 相比,除了 token 数由 2 增加到 3 之外,其余运算完全一致:输入经 embedding 与两层 attention 处理得到 embedding3,再取其最后一行交给分类器,预测出的 token 是“!”。
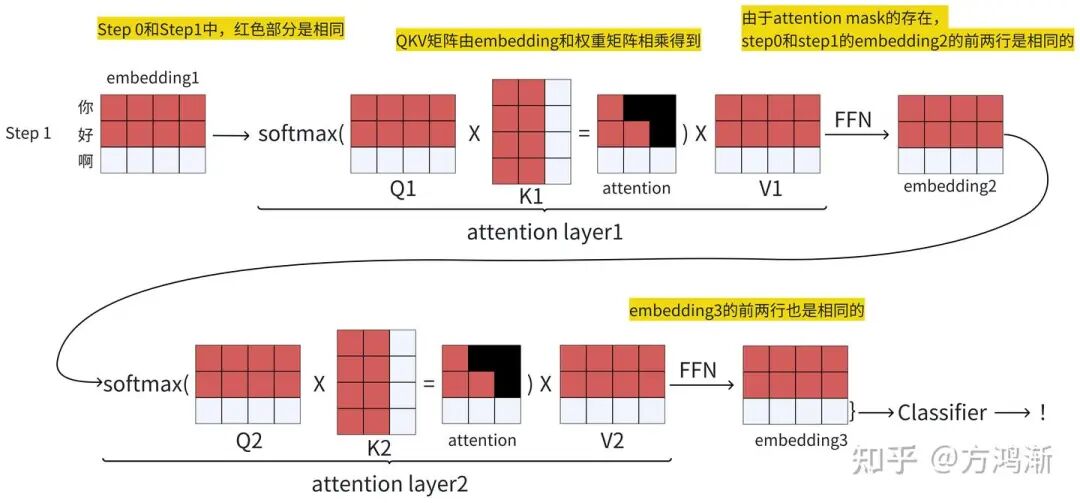
图 3 中隐藏着一个值得注意的细节:Step 1 与 Step 0 里红色标注的部分完全一致。以 K1 矩阵为例,Step 1 的前两行与 Step 0 的前两行毫无差别。原因在于 K1 是由 embedding1 与模型权重矩阵相乘而来,而两个 step 用的权重完全相同;唯一的区别只是 Step 1 的 embedding1 末尾多了一行。正因如此,两个 step 得到的 QKV 矩阵前两行才会一模一样,详见下图。
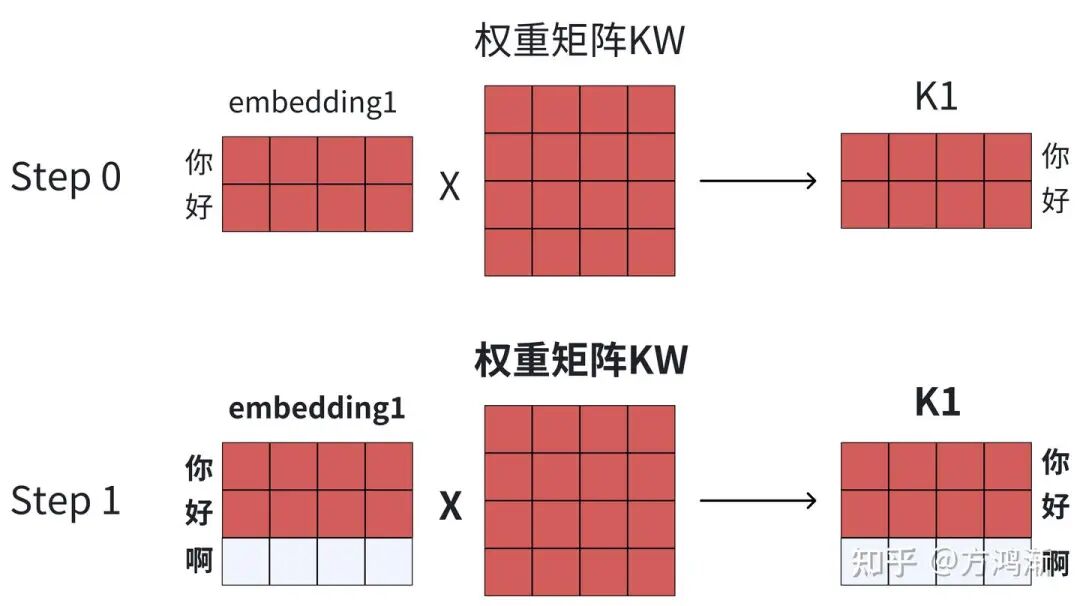
图4
删除无效计算
对照图 1 与图 3 不难看出,位于末端的 Classifier 只取 embedding3 的最后一行作为输入来给出预测。这说明一个事实:每个 embedding 矩阵里真正起作用的,仅仅是新输入 token 所在的那一行。以图 3 的 embedding3 为例,step 0 新生成的 token“啊”对应的第三行才有意义,前两行纯属多余。既然如此,把这些无效行裁掉,就能同时省下计算量与存储空间。
图 5 以 Step 1 的第一个 attention layer 为例做了演示。第一步,先把三个 embedding 矩阵中红色标注的行删去。由于 embedding2 与 embedding3 是由 attention 矩阵和 V1 相乘得到的,attention 矩阵中的冗余部分也必须一并删除;而 attention 矩阵又来自 Q 与 K 的乘积,于是 Q 矩阵里对应的重复行同样要清掉。
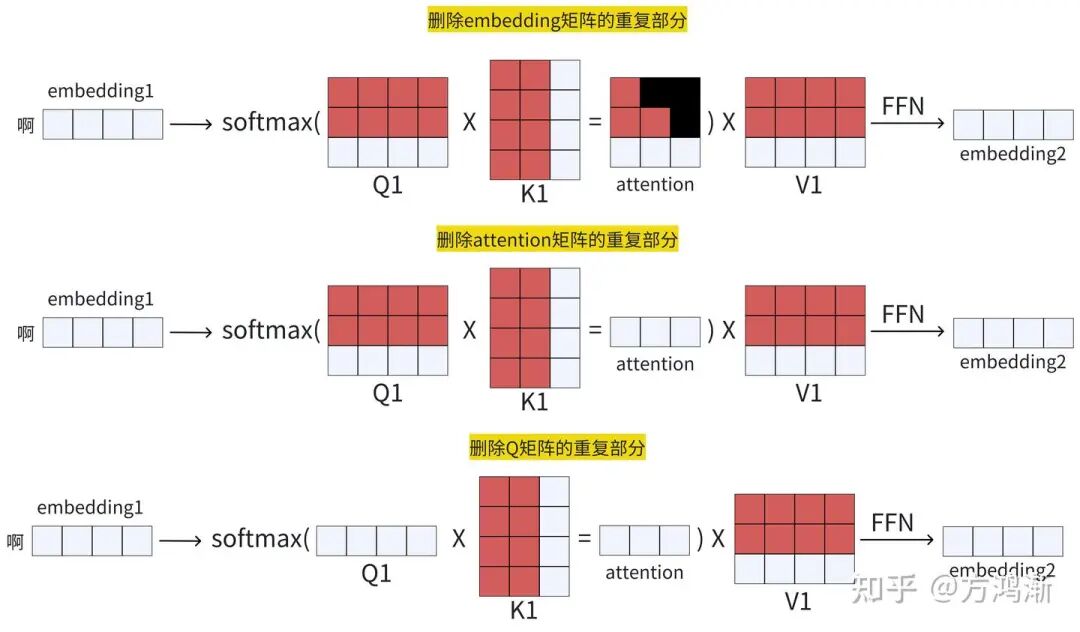
图5
完成上述无用计算的删减后,推理流程便可简化为图 6 所示。
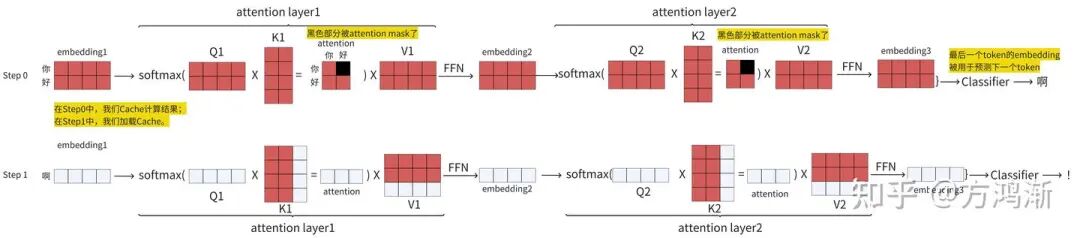
图6
缓存重复计算
再仔细看图 6,会发现 Step 1 与 Step 2 的红色区域一模一样,差别只落在白色区域。以 Q1、K1、V1 三个矩阵为例,Step 1 与 Step 0 的前两行完全相同。这就提示我们:完全可以在 Step 0 就把这些矩阵存进 Cache,等到 Step 1 时直接读回使用,从而省下大量重复运算。
加入缓存之后的计算过程如图 7 所示(建议放大查看)。
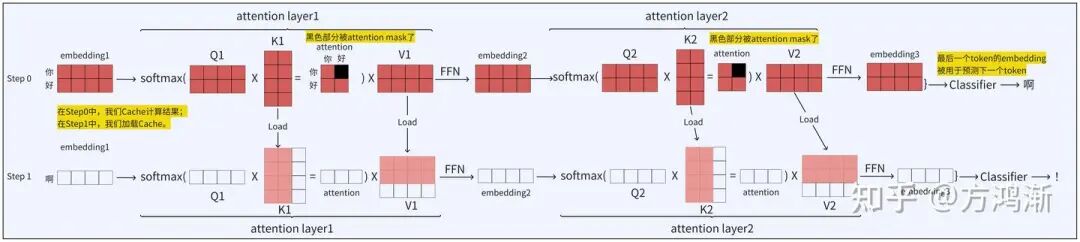
图7
具体做法是:Step 0 先把红色区域的数据写入 Cache,到 Step 1 时再把这些数据加载进来参与计算。在图 7 的 Step 1 中,红色区域全部来自历史缓存,白色区域才是本次新算出的内容。把两者按行拼接,就组成了新的矩阵。当然,Step 1 新产生的数据同样需要写入 Cache,供后续 step 复用。
四、总结
在 KV Cache 的语境下,第一个 step(即 Step 0)通常被称作 Prefill 阶段,原因在于它承担着“填充”KV Cache 的职责;其后的所有 step 则统一归为 Decode 阶段。进一步观察可知,Prefill 属于 Compute bound,也就是计算密集型——此时 embedding 矩阵规模庞大,需要完成海量矩阵乘法;Decode 则属于 Memory bound,即访存密集型——其开销主要来自从显存乃至内存中反复搬运 KV Cache。围绕这一机制,大模型推理系统通常需要应对以下几类问题:
1. 其一,怎样让 Prefill 阶段算得更快,例如当前已有不少研究借助预查找表来加速矩阵乘法。
2. 其二,如何化解 Decode 阶段的访存压力,例如部分工作尝试引入 CSD(Computational Storage Device)来缓解推理过程中的 Memory bound,进而提升吞吐率。
3. 其三,推理任务该如何调度。由于 LLM 采用自回归生成,我们无法预知一次推理究竟会跑多久;同时,输出越长,KV Cache 占用的存储空间就越大。因此,在多个服务器实例之间合理分配推理任务是一件相当棘手的事——阿里今年新发表的 Llumnix 论文,瞄准的正是 LLM 推理任务的调度难题。
基于以上分析,开头提出的三个问题现在可以逐一作答。
缓存的是什么?
被缓存下来的对象,是 K 矩阵与 V 矩阵。
为什么是KV Cache,而不是QKV Cache?
结合图 5 可知,既然只需保留 embedding 的最后一行,attention 的输出也只需最后一行,那么 Q 矩阵同样只有最后一行是必需的。
换言之,Q 矩阵之所以不进入 Cache,并非技术上做不到,而是没有缓存的必要——每次计算真正用到的只是它的最后一行。
KV Cache对模型的输出有任何的影响吗?
由于送入 Classifier 的 embedding 与未加缓存时完全一致,模型的最终输出自然也不会有丝毫改变。
五、Reference
https://medium.com/@joaolages/kv-caching-explained-276520203249
https://www.omrimallis.com/posts/techniques-for-kv-cache-optimization/
本文转载自微信公众号「程序员Owen」,仅供学习交流使用。
觉得内容不错?我要