
AMDMAX+395调优Qwen3.8-27B:写34.6 tok/s,提速2.9倍,读378 tok/s
本文来源: 社畜小宏(公众号:社畜小宏)
原文链接: https://mp.weixin.qq.com/s/gpY_arGaUSUi8jy-a26pvA
发布时间: 2026-10-28 08:30
作者: 社畜小宏 发布时间: 2026-10-28 08:30
看懂真正的 AI,从此不再焦虑
关注我,最新 AI 资讯和行业动态,挑重要的讲给你听。
我之前在上一篇里测过 Qwen3.8-27B,生成只有 11.8 tok/s。这次我在 AMD Ryzen AI Max+ 395 上把它重新调了一遍,结论是:降 AI 改写的生成速度从 11.9 提到 34.6 tok/s,是原来的 2.9 倍;10 组真实段落的总耗时从 218.1 秒降到 84.3 秒。质量基本没变,用我自己 60 篇推文测的困惑度从 12.60 变成 12.59。读入从 325 提到 378 tok/s,但它到不了 2000,原因是 27B 是稠密模型,每个 token 都要过全部参数,核显的 FP16 理论上限只有约 1090 tok/s。
0127B 在流水线里干什么
我的写稿流水线里,27B 只干一件事:降 AI 率改写。朱雀检测逐段判断,被判为 AI 的段落交给 27B,按「记者笔法」重写,最多两轮。近 3 天它被调用了 947 次。采样参数是温度 1.0、top_p 1.0、min_p 0.05。低温改出来的文字更像 AI,所以不用低温。改写时会并发发出几组段落(asyncio.gather)。
原来的配置是 Unsloth 的 UD-Q4_K_XL,文件 17.56GB,llama.cpp 用的是 b11527 预编译的 Vulkan 版,开 2 个槽位,不开投机解码。测试集是从我最近的推文里取出的 10 组真实段落,每组 3 段,251 到 605 字,用线上同一份降 AI 提示词逐组发送。另外我还测了两路并发。
02
先算账:卡在带宽上
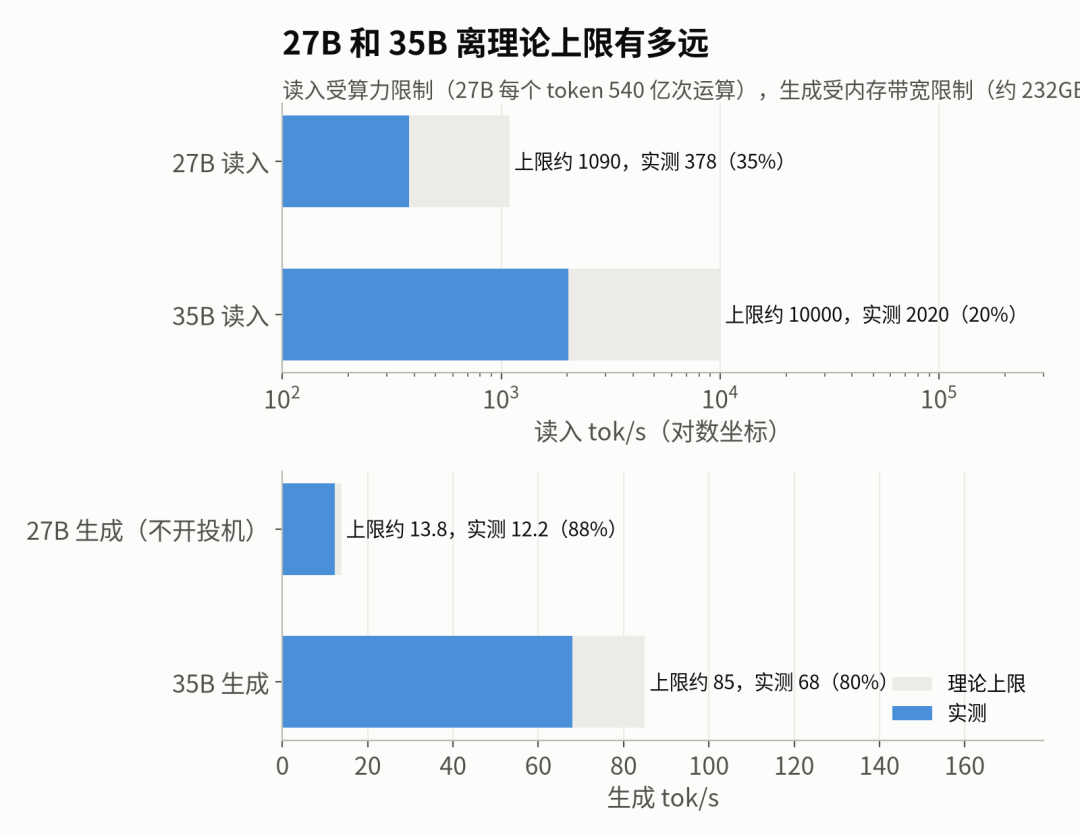
稠密模型每生成一个 token,全部参数都要参与计算。除去只查一行的词表,每出一个字,要从内存里读约 16.8GB 权重。这台机器的矩阵乘实测最高约 232GB/s,换算下来生成上限约 13.8 tok/s。我实测 12.0,已经用到带宽的约九成(87%)。所以再去抠计算核心,几乎没有空间了。
既然带宽已经用满,生成要变快,就只能想办法一步多出几个字,这就是投机解码。打个比方:小助手先猜几个字,大模型一次核对,猜对的直接用,猜错的从那里重来。稠密模型做投机特别划算,一次验证 4 到 6 个字,读的权重和只出 1 个字几乎一样。
读入的情况不一样。每个 token 大约要做 540 亿次运算(2 乘以 270 亿参数),核显 FP16 峰值约 59 TFLOPS,理论上限约 1090 tok/s。我实测 378,大约用到峰值的三分之一。同一台机器上的 35B-A3B 能读到 2000,是因为它每个 token 只激活 30 亿参数,运算量约是 27B 的九分之一。所以 27B 的读入到不了 2000,不是我的配置没调好,而是稠密模型的算力上限就在那里。
03提速过程
下面按时间顺序讲九步。每一步我都先说想法,再给数字,最后说它有用还是没用。数字如无特别说明,都是降 AI 改写的生成速度(tok/s,10 组真实段落)。每一步都是在前一步的基础上改,不是各自单独试。
第一步,先测原版。 想法很简单:找个基线。原版生成 11.9 tok/s,10 组共 218.1 秒。llama-bench 下读入 pp2048 是 325,生成 12.04,后面所有对比都从这里算起。
第二步,换 halo-box 社区分支。 我换成 strix-llama.cpp 的 rdna35-perf-folded 分支,也就是 35B 那篇已经上线的版本。这一步主要提的是读入:从 325 提到 378(+16%),生成 12.04 到 12.22,基本没变。
第三步,试 ngram 投机。 想法是:文本里经常重复出现的片段,直接从上下文里匹配出来猜。35B 的润色靠它从 52 提到了 93,我在 27B 上也试了一下。结果生成只到 12.2,猜中率只有 11%。原因在于降 AI 改写的目的就是换说法,和原文重合得少,温度又是 1.0,ngram 很难猜中。所以这条路基本没用。
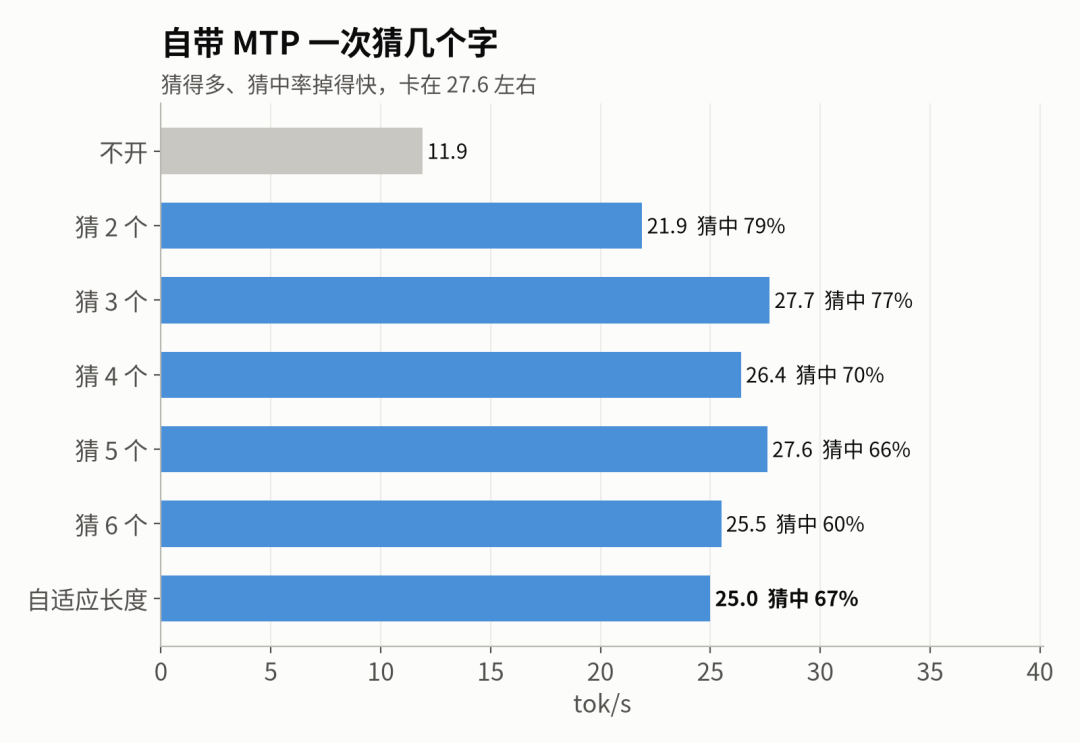
第四步,改用模型自带的 MTP。 想法是:Qwen 的 GGUF 里有 nextn 层,也就是模型自带的「多 token 预测」(MTP),直接用模型自己的这一层来猜后面的字。我把一次猜的数量从 2 测到 6:猜 2 个 21.9(猜中 79%),猜 3 个 27.7(77%),猜 4 个 26.4(70%),猜 5 个 27.6(66%),猜 6 个 25.5(60%),自适应长度是 25.0。速度卡在 27.6 左右,猜得越多,猜中率掉得越快,多猜的收益追不上猜错的损失。
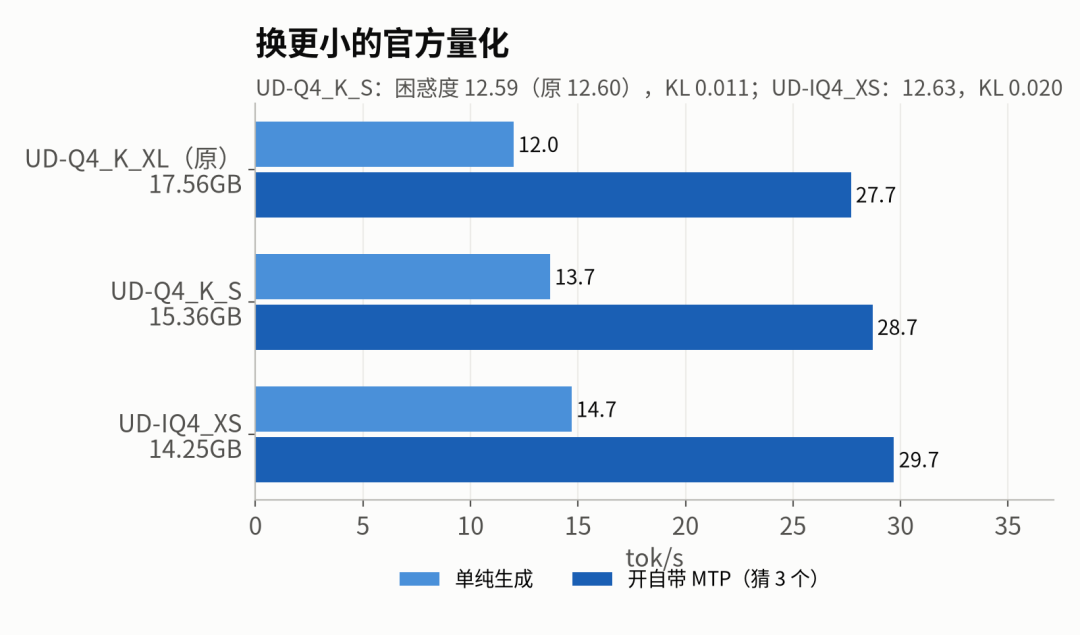
第五步,换更小的官方量化。 想法是:权重小一点,每个 token 读的字节就少一点。我从 ModelScope 下载了 Unsloth 用校准数据从原始权重量化的版本,对比如下:
| 版本 | 大小 | 单纯生成 | 开 MTP(猜 3 个) | 困惑度 | KL 散度 | 首选一致 |
|---|---|---|---|---|---|---|
| UD-Q4_K_XL(原) | 17.56GB | 12.0 | 27.7 | 12.60 | — | — |
| UD-Q4_K_S | 15.36GB | 13.7 | 28.7 | 12.59 | 0.011 | 93.5% |
| UD-IQ4_XS | 14.25GB | 14.7 | 29.7 | 12.63 | 0.020 | 90.4% |
困惑度是用我自己的 60 篇推文测的,KL 散度是相对原版 UD-Q4_K_XL 的。换量化之后速度确实上去了,但单看这张表,IQ4_XS 最快,质量指标也比 Q4_K_S 差一些。
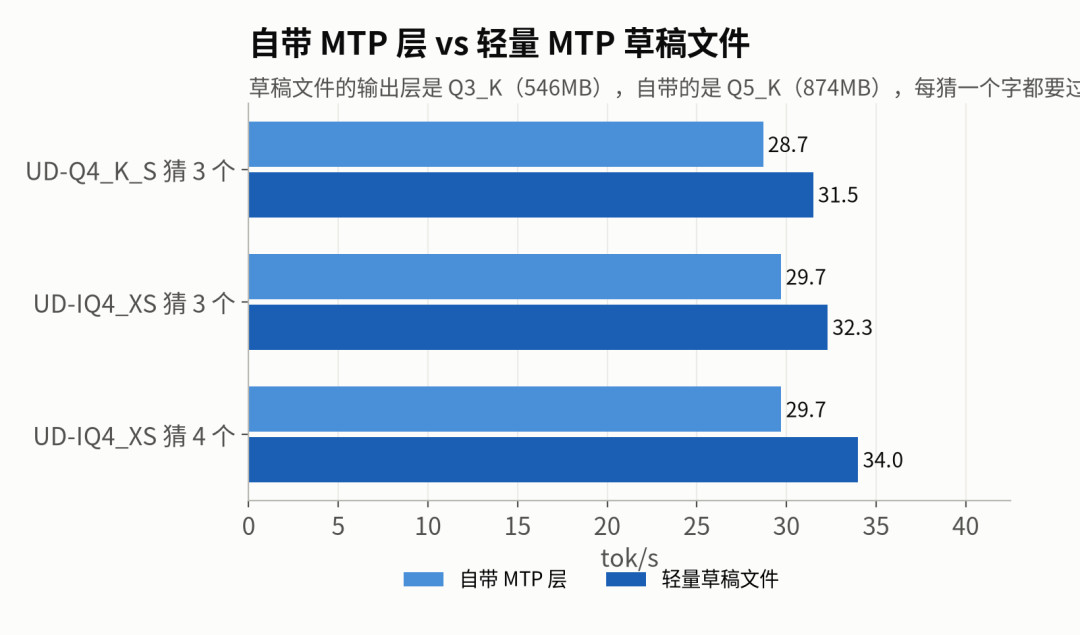
第六步,换轻量 MTP 草稿文件。 这是整个过程的关键一步。想法来自一个发现:模型自带的 MTP 每猜一个字,都要过一遍 24.8 万词表的输出层。主模型里这一层是 Q5_K,874MB。猜 3 到 5 个字,就要多读 3 到 4GB,相当于主模型权重的五分之一,草稿本身就拖慢了速度。Unsloth 仓库里有一个单独的 mtp-Qwen3.8-27B-Q4_0 文件,只有 1.37GB,输出层换成 Q3_K(546MB),MTP 层也从 Q6_K 降到 Q4_K。
为什么草稿精度低一点没关系?投机只是「先猜后验」,最终输出哪个字由主模型决定,所以草稿精度低一点不影响输出质量。数字是这样的:UD-IQ4_XS 加轻量草稿,猜 3 个 32.3,猜 4 个 34.0,猜 5 个 33.7;UD-Q4_K_S 加轻量草稿,猜 3 个 31.5,猜 4 个 32.2。
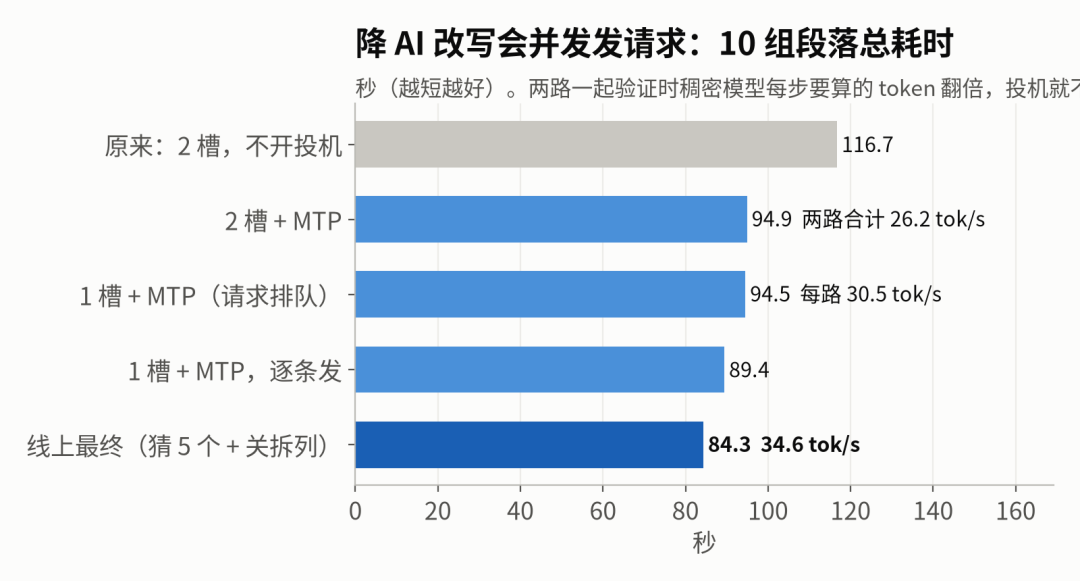
第七步,调并发槽位。 这一步改的不是模型,而是怎么用这几个槽位。想法是:线上改写会并发发请求,那就要看两路同时跑时怎么配,槽位数和投机是不是要一起考虑。线上原来开 2 个槽位。2 槽不开投机,两路合计 21.0,10 组共 116.7 秒;2 槽加 MTP,合计 26.2,10 组共 94.9 秒。2 槽加 MTP 只比不开投机多 25%,原因是两路一起验证,稠密模型每一步要算的 token 翻倍,投机省下的读取就不白送了。1 槽加 MTP,请求排队,每路 30.5,10 组共 94.5 秒;如果逐条发,是 89.4 秒。所以我把线上改成 1 个槽位。单槽开 MTP,比两槽不开投机快。
第八步,关掉分支的「拆列」。 想法是:找出分支里让我拖后腿的逻辑。halo-box 分支为了避开 RADV 在 3、5、6 列时的慢路径,会把批量矩阵向量乘拆成快的列数。问题是,猜 4 个字时要验证 5 个 token,被拆成两次,权重就要读两遍。我用环境变量 GGML_VK_MMV_NO_SPLIT=1 把拆列关掉。这一步的数字是:猜 4 个,32.2 提到 33.6(+4%);猜 3 个时验证 4 列本来就不拆,开关前后都是 32.6;猜 5 个再关掉拆列,是 34.5。32.2 就是前面 Q4_K_S 加轻量草稿猜 4 个的结果。
这一步我固定了随机种子做对比。原因是温度 1.0 下每次采样都不一样,猜中率在 64% 到 78% 之间跳,同一个配置跑两次,速度能差 2 tok/s。不固定种子,就分不清是配置的效果还是运气。
第九步,定最终线上配置。 最终写进 start-writer-27b.sh 的是:UD-Q4_K_S,加轻量 MTP 草稿猜 5 个,关掉拆列,开 1 个槽位。用线上启动脚本实测,生成 34.6 tok/s,猜中率 66%,10 组共 84.3 秒。
04最终配置和结果
| 项目 | 原配置 | 最终线上配置 |
|---|---|---|
| 模型 | UD-Q4_K_XL(17.56GB) | UD-Q4_K_S(15.36GB) |
| llama.cpp | b11527 预编译 Vulkan | halo-box rdna35-perf-folded |
| 投机解码 | 不开 | 轻量 MTP 草稿,猜 5 个 |
| 拆列 | — | 关闭(GGML_VK_MMV_NO_SPLIT=1) |
| 槽位 | 2 | 1 |
| 降 AI 改写生成 | 11.9 tok/s | 34.6 tok/s |
| 10 组段落总耗时 | 218.1 秒 | 84.3 秒 |
| 困惑度(60 篇推文) | 12.60 | 12.59 |
| 读入(pp2048) | 325 tok/s | 378 tok/s |
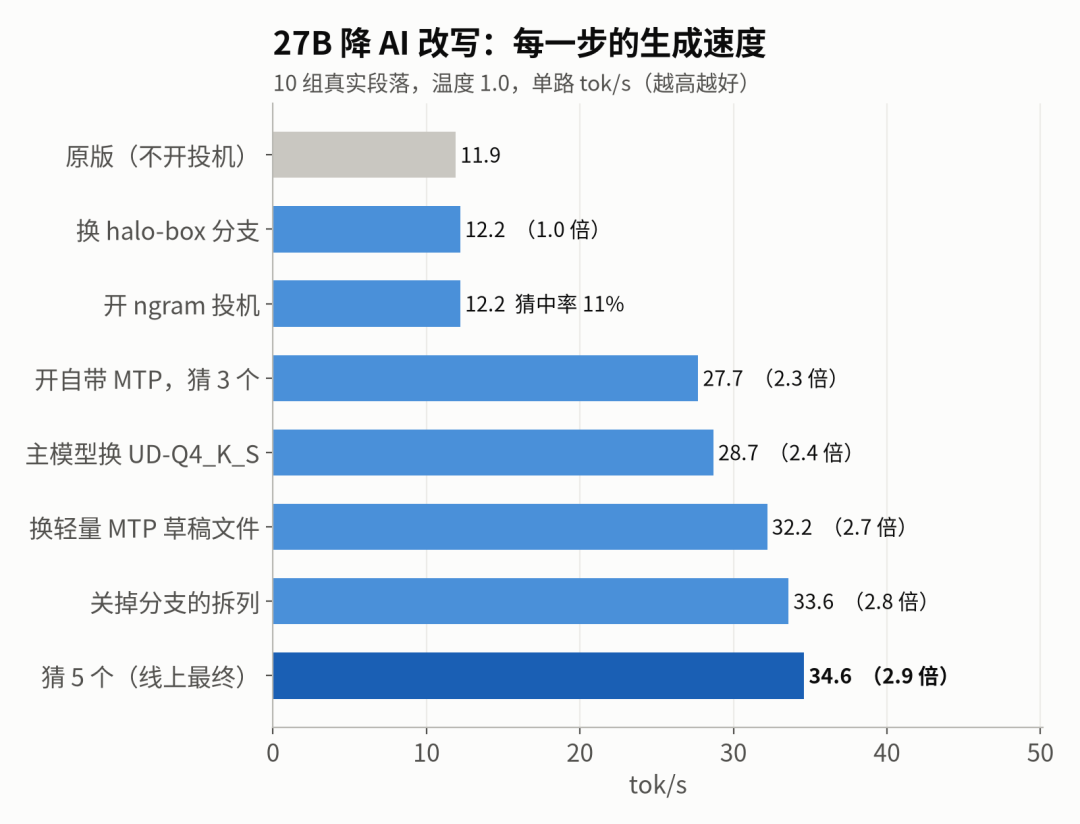
生成速度提升 2.9 倍,总耗时减少 61%。这两个数字都是在线上改写的那组测试段落上测的,不是 llama-bench 的跑分。对流水线来说,10 组段落的总耗时直接对应改写要等多久,所以我把它和单路速度放在一起看。把各步串起来看:原版 11.9;只换自带 MTP、猜 3 个,到 27.7(这时还是 UD-Q4_K_XL);换成 Q4_K_S 后同样猜 3 个,到 28.7;再换轻量草稿,Q4_K_S 猜 4 个到 32.2;关掉拆列后猜 4 个到 33.6;最后猜 5 个、开 1 个槽,到 34.6。
质量方面,主模型从 UD-Q4_K_XL 换成 UD-Q4_K_S 后,困惑度是 12.60 到 12.59,KL 散度是 0.011。投机解码本身不改变输出分布,因为每个字都由主模型验证。读入从 325 提到 378,理论上限约 1090,2000 是不可能的。
05
为什么选 Q4_K_S,不选更快的 IQ4_XS
IQ4_XS 确实更快。同样是猜 4 个,IQ4_XS 是 34.0,Q4_K_S 是 32.2。但我选了 Q4_K_S,理由是质量。它的 KL 散度是 0.011,IQ4_XS 是 0.020,质量损失只有 IQ4_XS 的一半。27B 在我这里的活就是写字,所以我把质量放在速度前面。
06试过没用的
—
ngram 投机:猜中率只有 11%,基本没用,因为改写本来就是要换说法。
—
MTP 猜得越多越好? 不是。猜 3 个之后,猜中率掉得比收益快。
—
自适应猜测长度(--spec-draft-adaptive):速度 25.0,不如固定猜 3 个的 27.7。
—
2 槽加 MTP:两路一起验证,收益只剩 25%,所以最后我改成了 1 个槽位。
07给用 395 跑稠密模型的朋友的建议
第一,先算带宽上限。把每个 token 要读的权重字节数,除以实测带宽,就能知道生成速度的天花板。我这里是 232 除以 16.8,约 13.8 tok/s,实测 12.0 已经很接近了。这时候再去抠计算,效果有限,应该转去想投机。
第二,稠密模型做投机值得试,但草稿的成本要算清楚。自带 MTP 的输出层很大,每猜一个字都要读一遍,猜得多了反而拖慢速度。换成轻量草稿文件之后,同为 UD-IQ4_XS 猜 3 个,速度从 29.7 提到 32.3。
第三,投机之前先测猜中率。改写这类任务换说法多,ngram 基本猜不中,别在上面花时间。
第四,猜几个字要自己测,别默认越多越好。我的 MTP 在猜 3 个之后猜中率就掉得比收益快;但在关掉拆列、固定种子的对比里,猜 5 个是 34.5,是那组对比里最高的。最优点要结合你自己的配置测。
第五,两路并发的收益会被摊薄。我的数据里,2 槽加 MTP 只比不开投机多 25%,而单槽开 MTP 比两槽不开投机还快。并发配置要按你的实际请求方式实测。
第六,对比实验固定随机种子。温度 1.0 下同一配置两次能差 2 tok/s,不固定种子,很难分清是配置还是运气。
第七,量化要看三个指标:生成速度、困惑度和 KL 散度。只看速度,IQ4_XS 比 Q4_K_S 快;加上 KL 散度,IQ4_XS 是 0.020,Q4_K_S 是 0.011,这个差别只看速度是看不出来的。
本文转载自微信公众号「社畜小宏」,仅供学习交流使用。
觉得内容不错?我要