
图解六种 KV cache 量化方法
本文来源: 小木块lambda(公众号:小木块lambda)
原文链接: https://mp.weixin.qq.com/s/gR1ps-6IFUq3PpBujBk4Jg
发布时间: 2026-11-03 11:17
作者: 小木块lambda 发布时间: 2026-11-03 11:17
小木块lambda
你的专属 AI FDE。全球最新 AI,我替你读完,告诉你能不能用、怎么用。
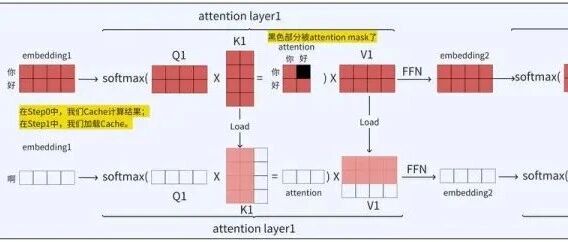
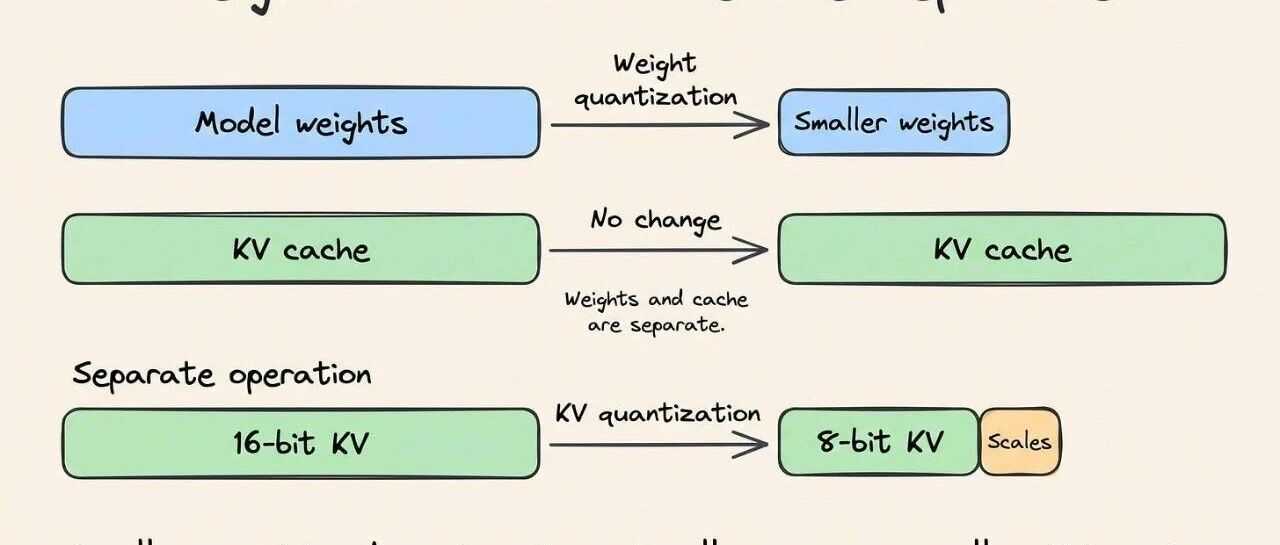
量化模型权重,不会自动缩小 KV cache(键值缓存)。
权重保存的是模型学到的参数。KV cache 保存的是处理请求时计算出来的 key 和 value,也就是键和值。降低其中一类数据的精度,不会自动改变另一类数据的精度。
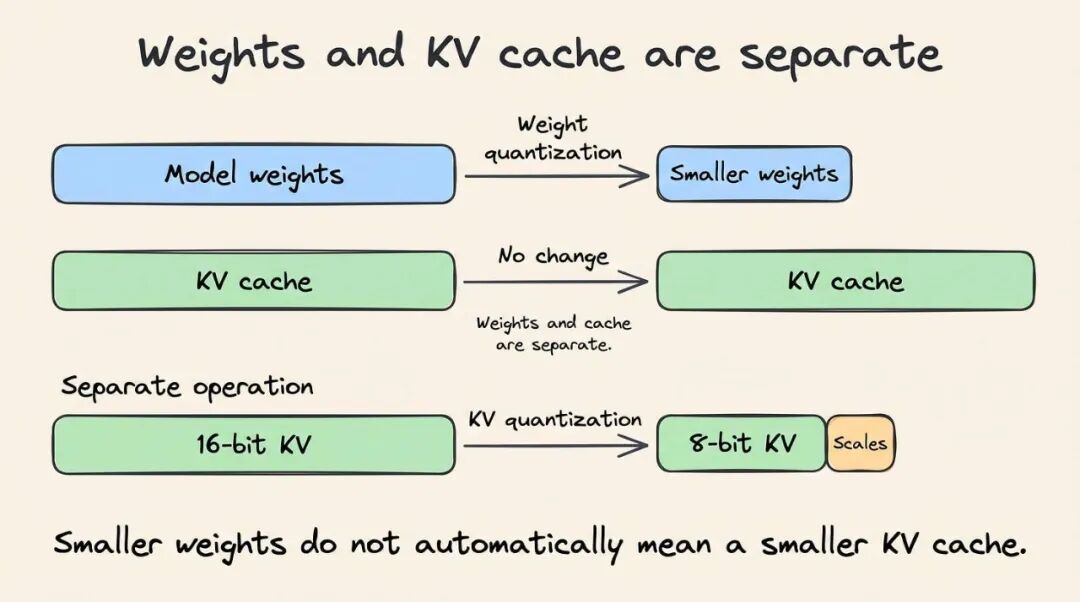
一个请求保留的 token 越多,缓存就越大。多个请求并发运行的时候,每个请求也需要空间保存自己的缓存条目。KV 量化减少的是保存这些条目所需的字节数。
比如,从 16 位改为 8 位,原始 KV 数据的空间就减少了一半。不过,算上缩放因子、其他元数据以及高精度缓冲区,总体节省比例会更小。
下面六种方法描述了 KV 量化中的不同选择,其中一些可以组合使用,比如 4 位整数、小规模量化分组,以及用于保存近期 token 的高精度缓冲区。
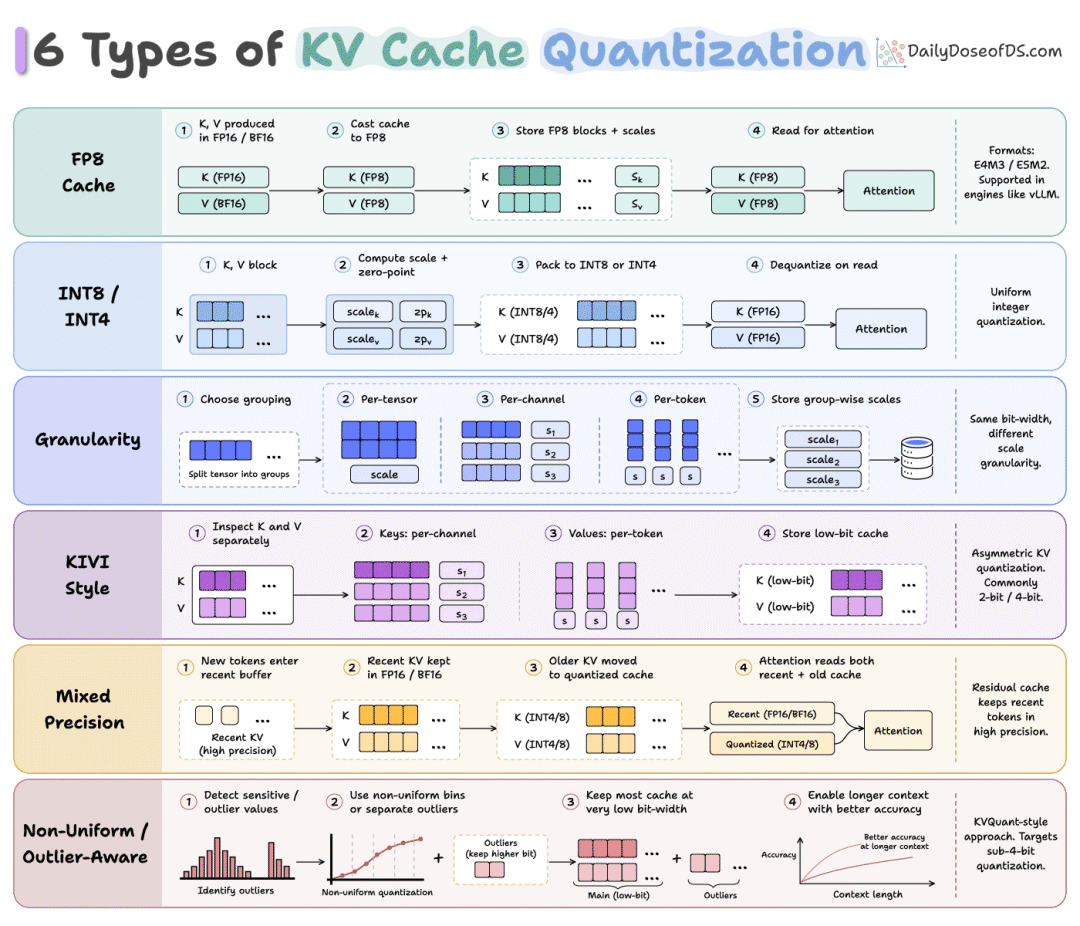
1. FP8 缓存
FP16 或 BF16 缓存使用 16 位保存一个数值。FP8 使用 8 位,所以保存相同数量的条目,原始存储空间只需要一半。
缩放因子会调整数值,使其适应 FP8 的表示范围。系统需要同时保存这个缩放因子,让执行注意力计算的 attention kernel(注意力计算内核)能够正确解释缓存中的数值。
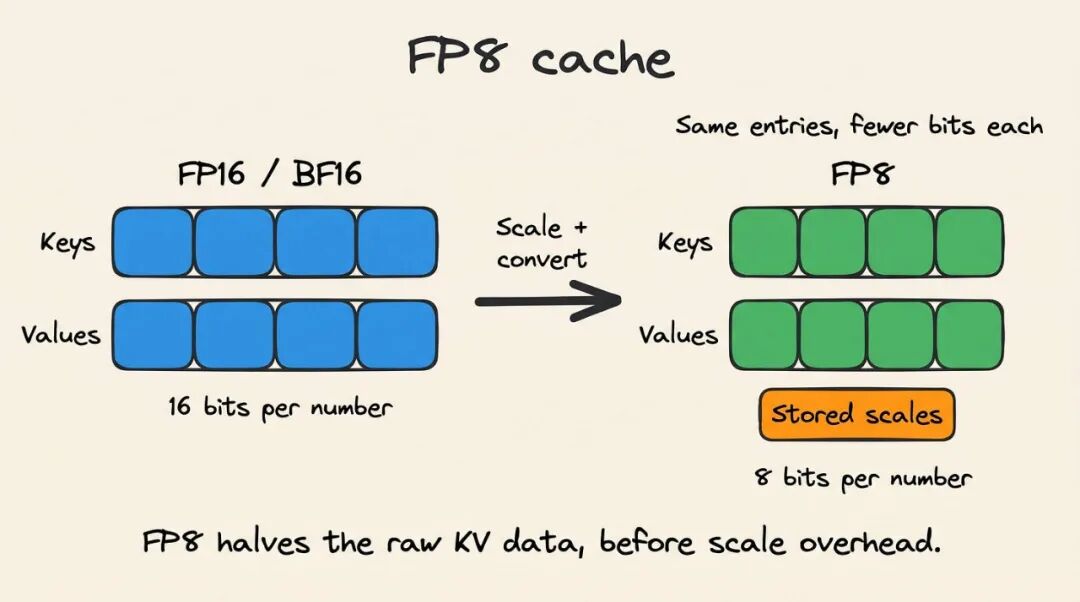
比如,不计缩放因子和其他开销,1 GiB 的 16 位 KV 数据会变成 512 MiB 的 FP8 数据。模型权重占用的空间保持不变,除非另外对权重进行量化。
推理服务引擎与 GPU 需要支持兼容的注意力计算内核。只采用 FP8 存储,无法直接判断内核的运行速度。
2. INT8 / INT4 缓存
这两种方法使用 8 位或 4 位整数表示缓存数值。缩放因子,有时还包括 zero-point(零点),用于说明如何把整数映射回近似的原始数值。
INT8 有 256 个可表示的整数级别,INT4 有 16 个。INT4 占用的空间更少,但数值舍入的时候,可选择的级别也更少。
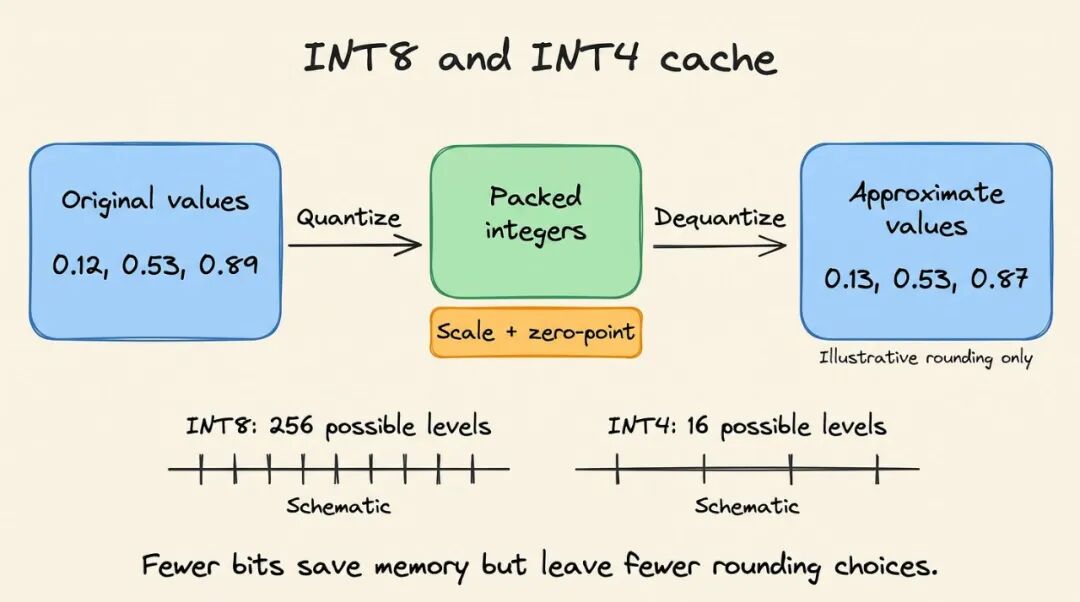
比如,两个相近的数值,可能在 INT4 中被舍入到同一个级别。还原以后,注意力计算就无法精确区分这两个数值了。
内核需要解包并反量化缓存条目,供注意力计算使用。这些操作往往直接在注意力计算中完成,也会抵消一部分减少读取字节数带来的收益。
3. 量化粒度
量化粒度决定多少个数值共享一个缩放因子。可以让整个张量共享一个缩放因子,也可以按通道、token 或更小的分组分别设置。
假设一组数值大部分位于 0 到 1 之间,其中有一个是 20。为了容纳 20,共享的缩放范围需要扩大,留给较小数值的舍入级别就可能减少。
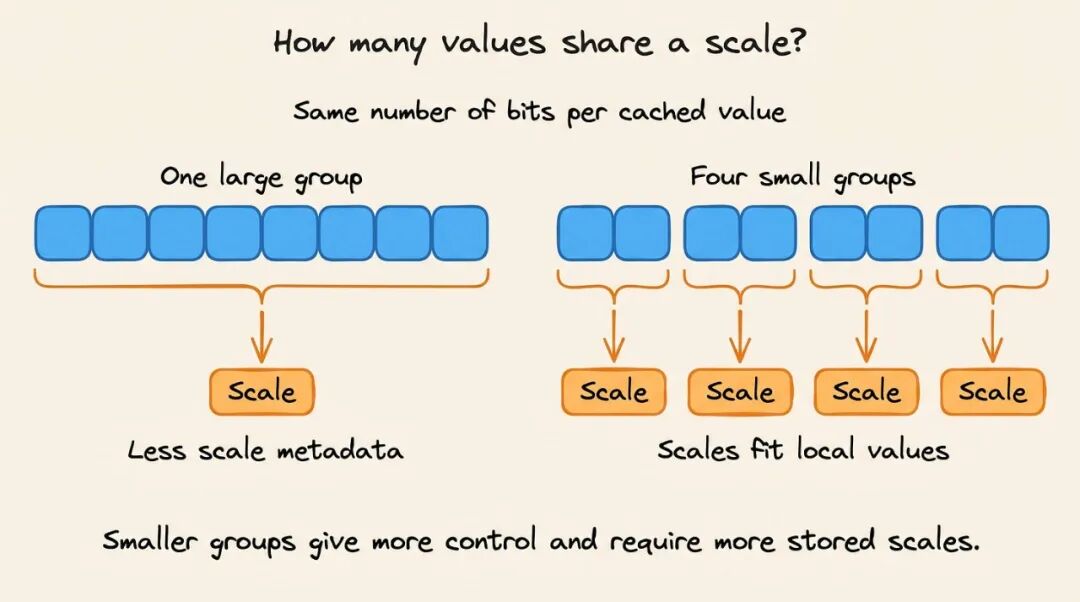
缩小分组,可以减少这个异常值影响的其他数值数量。但每个分组都需要自己的缩放因子,这些因子也会占用显存。
即使两种实现都使用 4 位数值,共享缩放因子的方式不同,总显存占用和准确率也可能不同。
4. KIVI 式量化
KIVI 是一种为 key 和 value 采用不同分组规则的 KV 量化方法。其分析发现,key 中异常大的数值往往集中在特定通道,而 value 呈现出不同的分布模式。
通道就是 key 或 value 向量中的一个坐标。KIVI 会在一组 token 内,把同一通道的 key 数值分成一组,为该通道在这组 token 内设置独立的缩放因子。
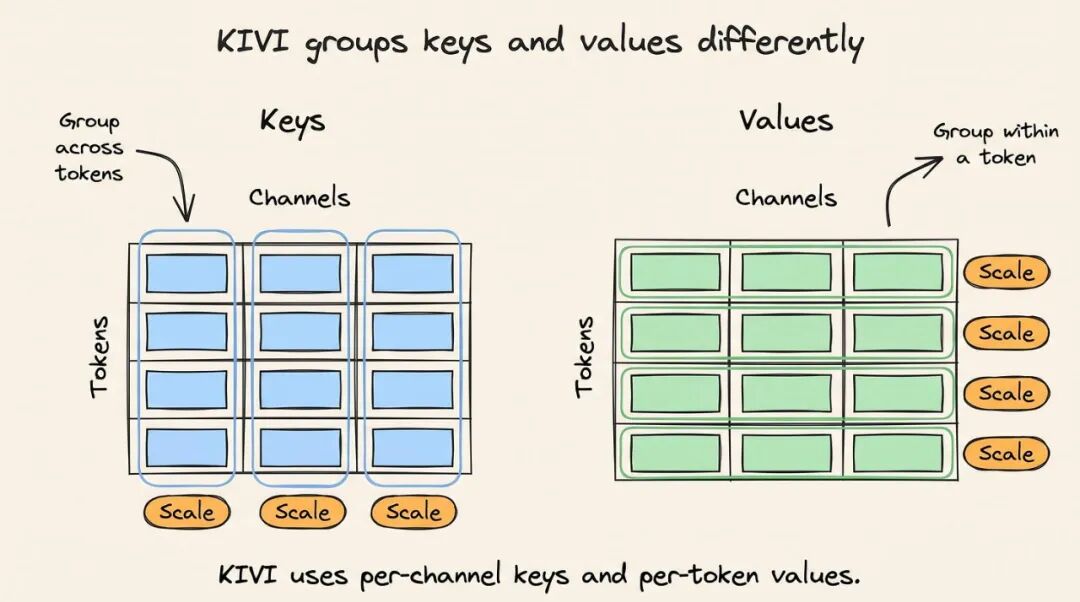
对于 value,KIVI 则在每个 token 内部分组。这样,一个 token 的 value 范围就不会决定其他所有 token 的缩放因子。
原始方法的目标是在不微调模型的情况下,使用 2 位 KV 存储。分组规则有助于控制舍入误差,但准确率仍然需要在实际使用的模型与服务负载上检查。
5. 混合精度
一种混合精度方法,会把近期的 key 和 value 保存在高精度缓冲区中,把较早的条目保存在量化缓存中。
新条目首先进入缓冲区。随着缓冲区逐渐填满,系统会将一组条目量化,再移动到压缩存储部分。
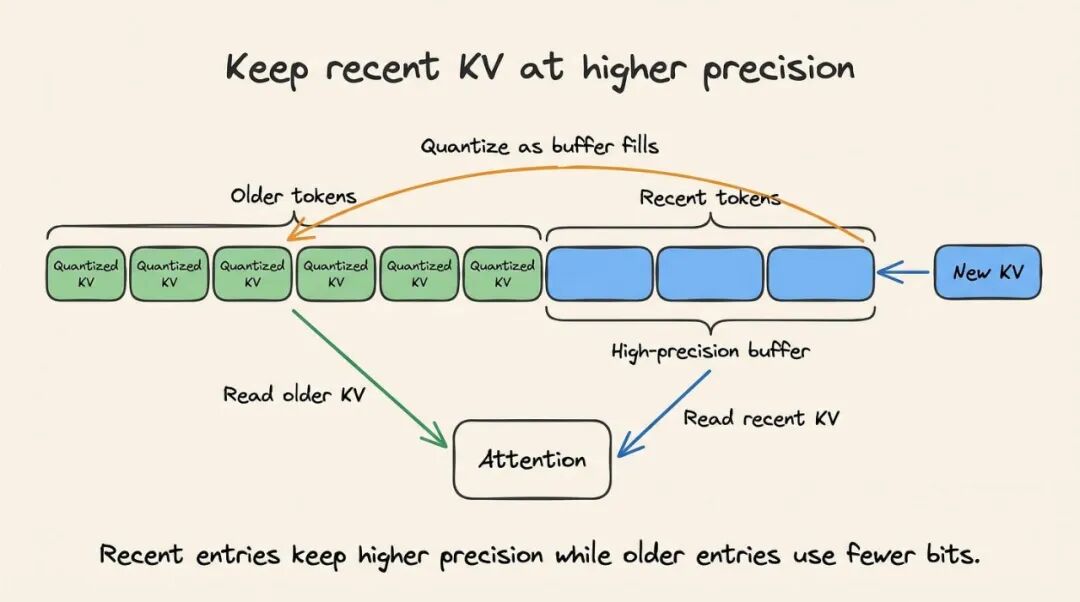
解码的时候,注意力计算会读取这两部分。近期条目留在高精度缓冲区期间,可以避免量化误差。
缓冲区越大,能够保持高精度的条目就越多,但显存节省也越少。这种方法还可以积累足够多的 token,支持像 KIVI 那样按块量化 key。
6. 非均匀量化与异常值感知量化
均匀量化把数值舍入到间隔相等的级别。非均匀量化会改变这些级别之间的间距,使其更好地适应数值分布,或者保留敏感数值。
比如,很多数值集中在零附近的时候,可以在这里安排更多级别,避免把所有级别均匀分散到很宽的范围中。
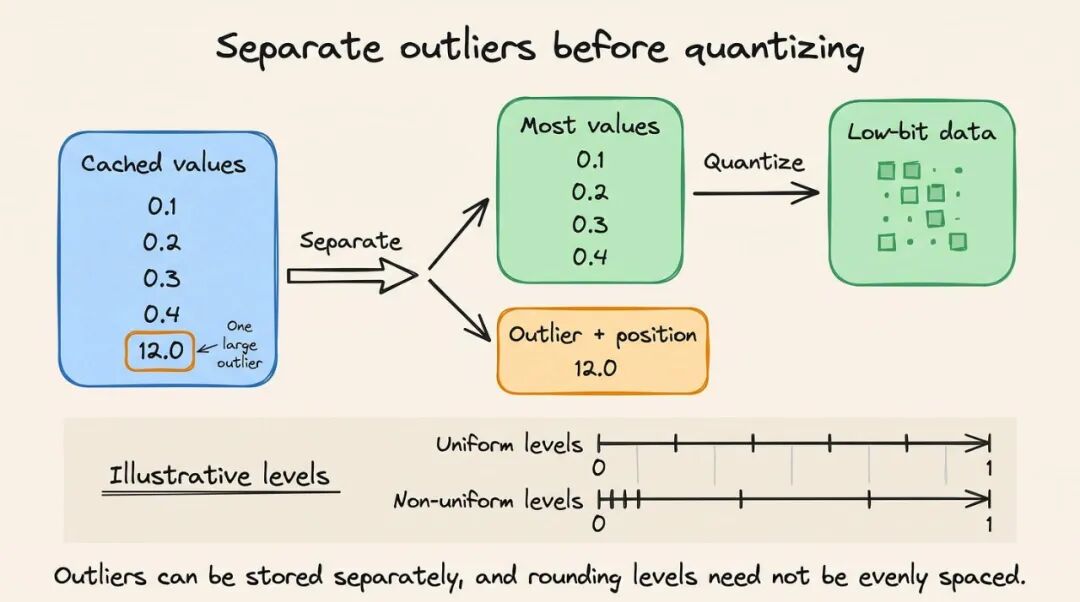
异常值处理解决的是一个相关问题。KVQuant 是一种 KV 量化方法,会把异常大的数值单独放入稀疏存储,同时保存它们的位置,让内核在注意力计算中能够计入这些数值。
其余数值就可以使用更窄的表示范围。不过,单独保存的异常值及其位置也有开销,所以显存成本需要包含低位宽数据之外的部分。
检查节省与开销
缓存缩小以后,同一张 GPU 可以容纳更长的上下文,或者处理更多请求。解码能否加速,取决于减少内存传输带来的收益,能否超过额外量化操作的开销。
比较的时候,需要使用相同的模型、提示词、输出长度和并发数,以未量化缓存作为基准。检查总显存占用、解码延迟,以及应用真正关心的长上下文任务中的回答质量。
更多知识学习,尽在 https://www.dailydoseofds.com/
部署工具推荐
Zeabur:少折腾服务器,把时间留给产品
前端全栈、小程序后台,还是 OpenClaw、Claude Code 这类 AI 应用,它都能让你跳过配置服务器的琐事,push 完代码就上线。
正好要部署项目,或者想购买服务器和 AI Hub 额度,结账填写推荐码 xiaomukuaier(“小木块儿”的全拼),你可以立省 20%,我也能拿到佣金继续更新硬核内容。
Zeabur:https://zeabur.com/zh-CN/templates
推荐码:xiaomukuaier(立省 20%)
小木块lambda
业务合作 / Agent 落地
我正在承接 Agent 相关的定制与落地合作。
如果你在企业生产、运营、市场、投研、数据处理、内容处理或其他业务流程里,有希望用 Agent 自动化的环节,欢迎加我微信交流。
不需要你已经想清楚方案。只要你有真实流程、真实问题或真实需求,我可以一起判断 Agent 能不能解决、怎么做。
今天这篇要是帮到你了,可以点个赞 + 在看,转给同样在追 AI 的朋友;有想法欢迎留言聊两句。
顺手关注「小木块lambda」,新的拆解我第一时间发你。
大模型 #AI编程 #Agent #人工智能 #干货
本文转载自微信公众号「小木块lambda」,仅供学习交流使用。
觉得内容不错?我要