
大模型加速优化:搞懂KV Cache基本原理
本文来源: 程序员Owen(公众号:程序员Owen)
原文链接: https://mp.weixin.qq.com/s/LQZE3QWQ7AEETc-nyKMmYA
发布时间: 2026-10-26 08:45
作者: 程序员Owen 发布时间: 2026-10-26 08:45
一、从一个简单例子看大模型推理
想弄清楚大模型推理内部到底走了哪些环节,不妨先做一个简化假设:每次只让模型处理一条文本,也就是暂且把 batch size 当作 1。举例如下:
● 模型的输入为“What color is the sky”,在推理语境下,这段输入通常被称作 prompt
● 模型的输出为“The sky is blue.”,相应地,这段输出常被称为 completion
以基于 transformer 架构的大模型为例,由这段 prompt 得到 completion,大致会经过以下几个环节:
● 第1步,先把模型的权重读入 GPU 显存
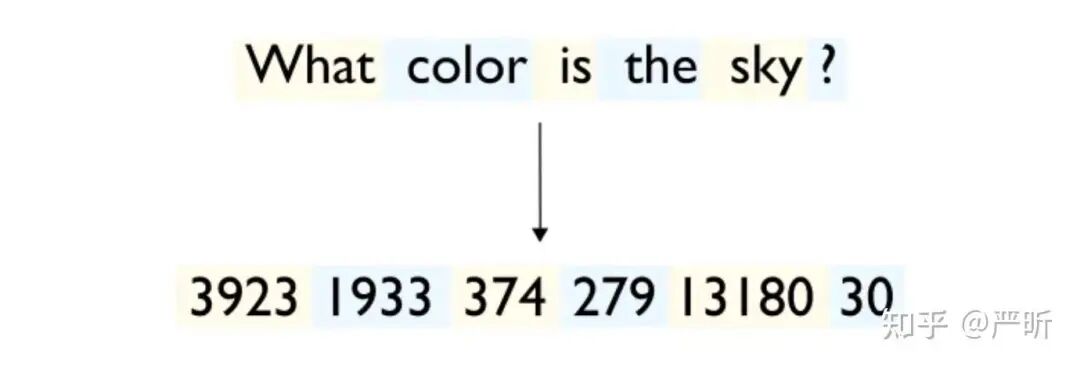
● 第2步,由 CPU 完成 prompt 的 tokenization(分词),再把 token 对应的张量形式 token_ids 从内存搬到 GPU 显存:
● 第3步,把 token_ids 送进网络完整跑一遍,得到输出的首个 token:
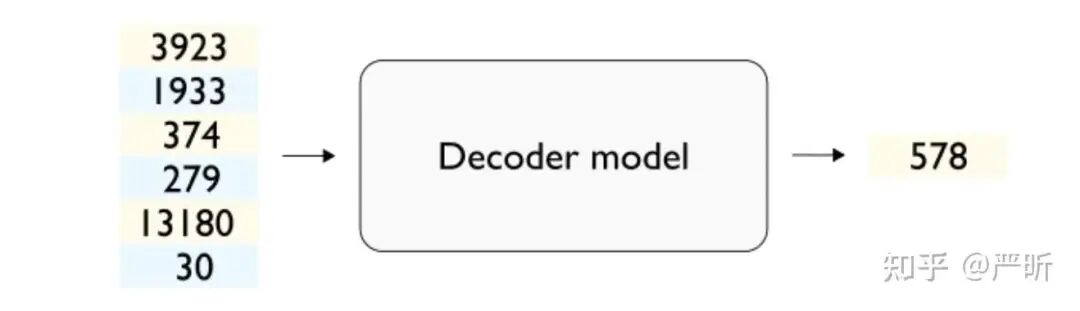
由于网络只需前向执行一次,这一步通常被称作 prefill(预填充)阶段。
● 第4步,把刚生成的 token 追加到已有序列末尾,组成新的输入,据此预测下一个 token;如此循环往复,直到产出终止符 token,或达到设定的最大生成长度为止。这个终止符 token 又叫 end-of-sequence(EOS)token。
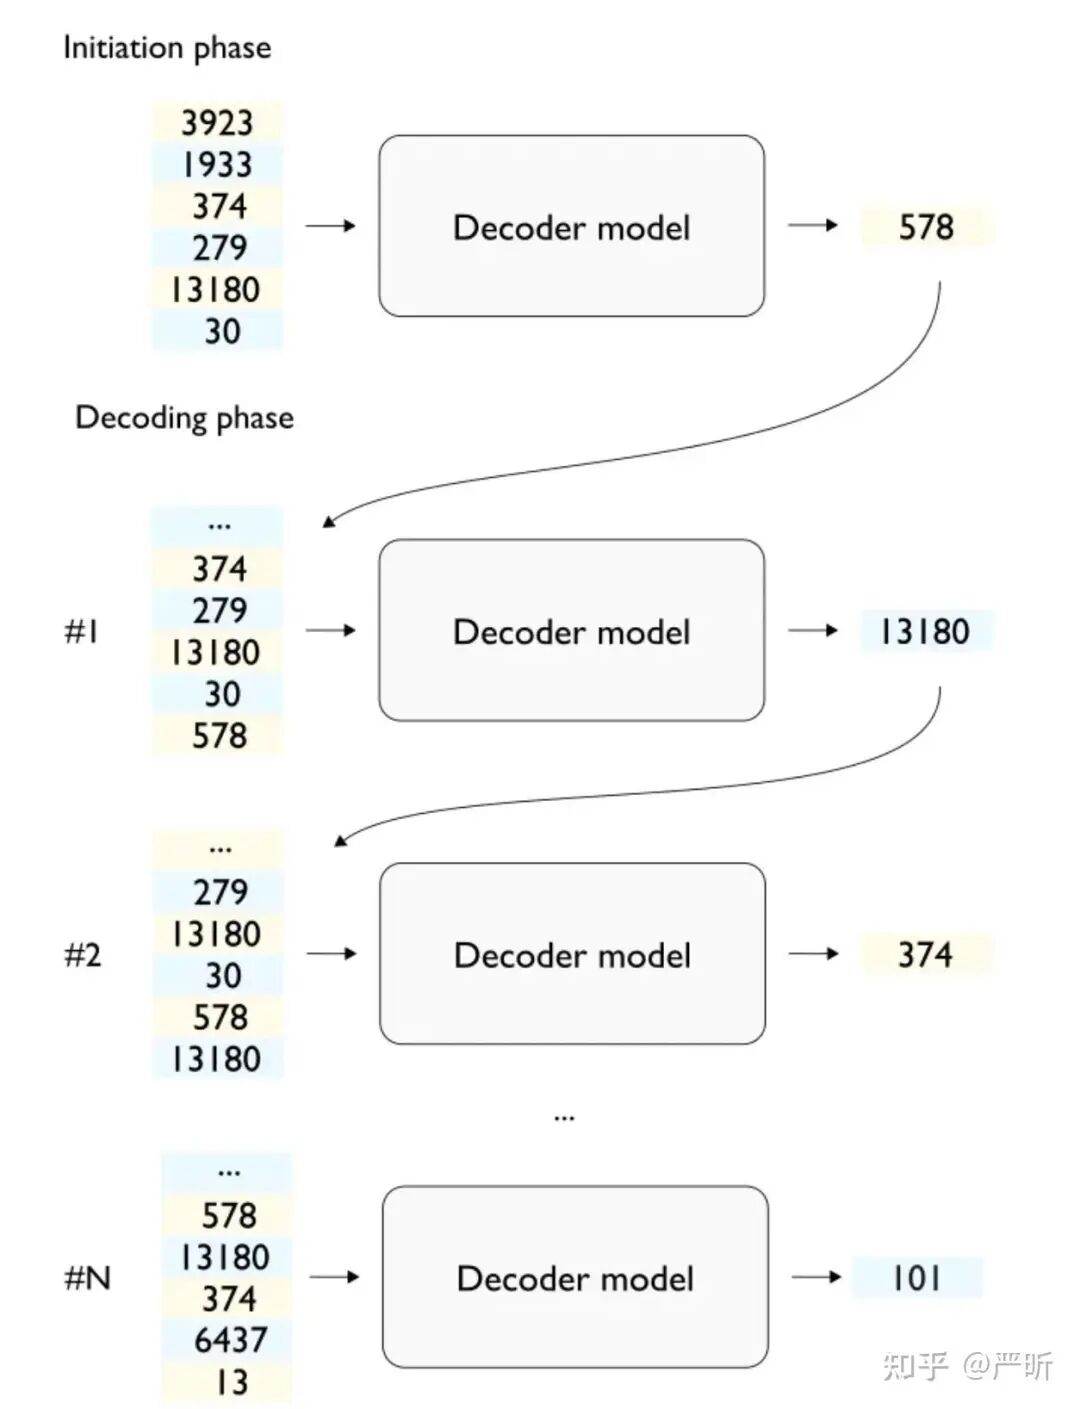
因为网络需要一次次重复前向计算,这一步被称为 decoding(解码)阶段。
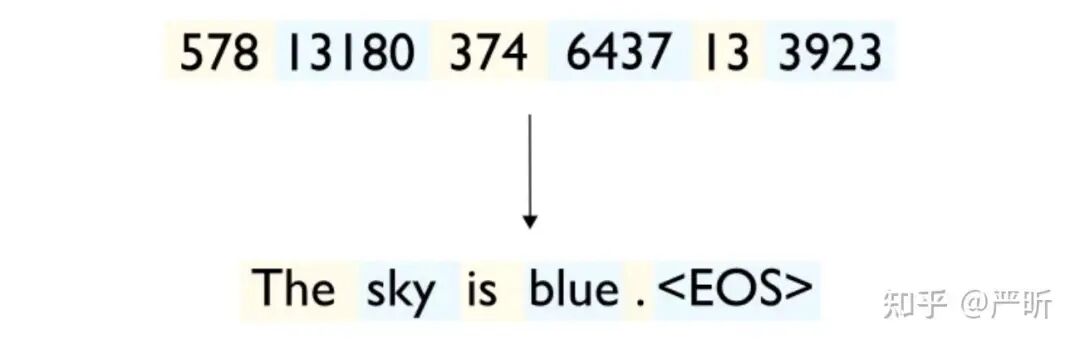
● 第5步,把生成的全部 token 从 GPU 显存搬回 CPU,再由 CPU 将这些 id 还原成文字,就得到了最终的 completion:
二、推理过程的PD两阶段
概括而言,整个推理流程可以拆成两个阶段:
● 预填充(prefill)阶段:模型一次性读完整个 prompt 并完成前向计算,目标是吐出第一个输出 token,也就是整段响应的起点。
● 解码(decoding)阶段:prefill 结束之后,模型转入逐 token 生成,把剩余响应内容一个一个补全。
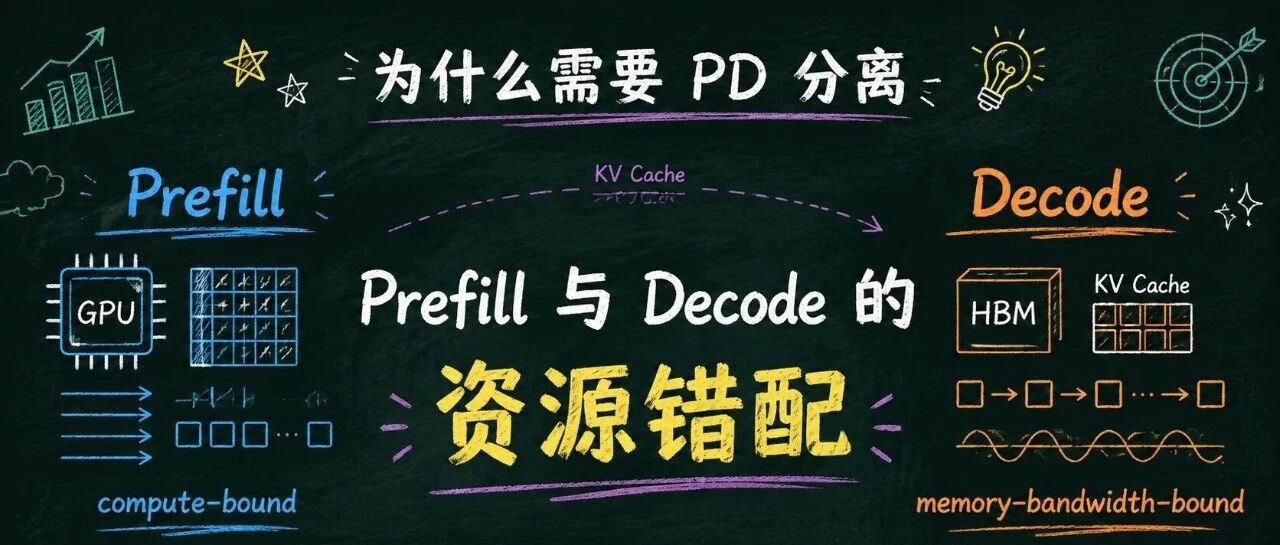
从上面的图示看,两个阶段都要跑一遍神经网络的前向计算,单论逻辑并无本质差别。之所以要把它们拆开,是因为二者在资源消耗和优化手段上存在根本差异——这一点后文还会展开。预填充属于计算密集型,能较充分地吃满 GPU 的并行算力;解码则偏向内存密集型,容易卡在显存带宽上。此外,预填充一旦完成,就可以脱离解码单独执行,系统因此能更灵活地调度资源、提升处理效率。
这两个阶段的更多细节不在本文讨论范围内,这里先认识衡量它们性能的两个指标,后文的实验会直接用到。
● 衡量预填充阶段的核心指标是 TTFT(Time To First Token),也就是产出首个 token 所花的时间。
● 衡量解码阶段的核心指标是 TPOT(Time Per Output Token),即平均每产出一个响应 token 需要的时间。
要评估乃至优化大模型推理性能,这两个指标是绕不开的抓手。
三、引入 KV Cache
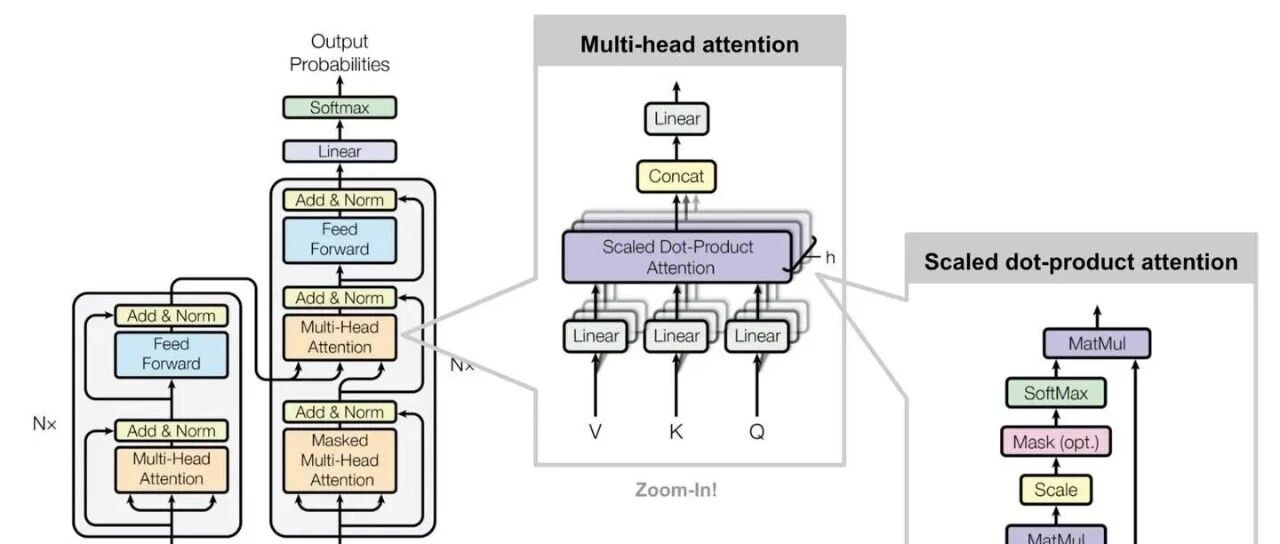
KV Cache 是专门为解码阶段设计的加速手段。其中的 K 与 V,取自 transformer 的 Self-Attention 层在计算 scaled dot-product attention 时所用的 Key 和 Value 向量,如下图所示(图片来自(图片来自 https://lilianweng.github.io/posts/2018-06-24-attention/#full-architecture):
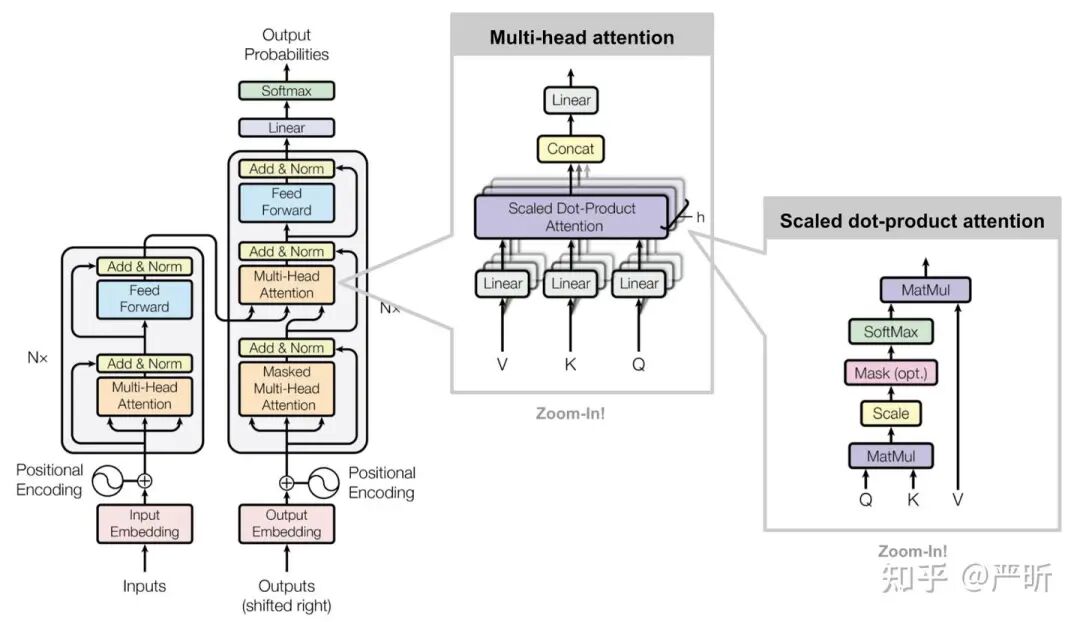
图中 Multi-Head Attention 的输出,等价于若干独立单头注意力结果的拼接。设输入的(行)向量序列为:
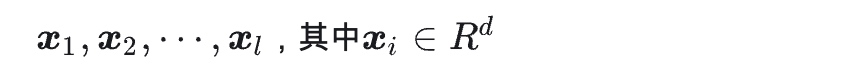
则 Multi-Head Attention 的输出可形式化写作:
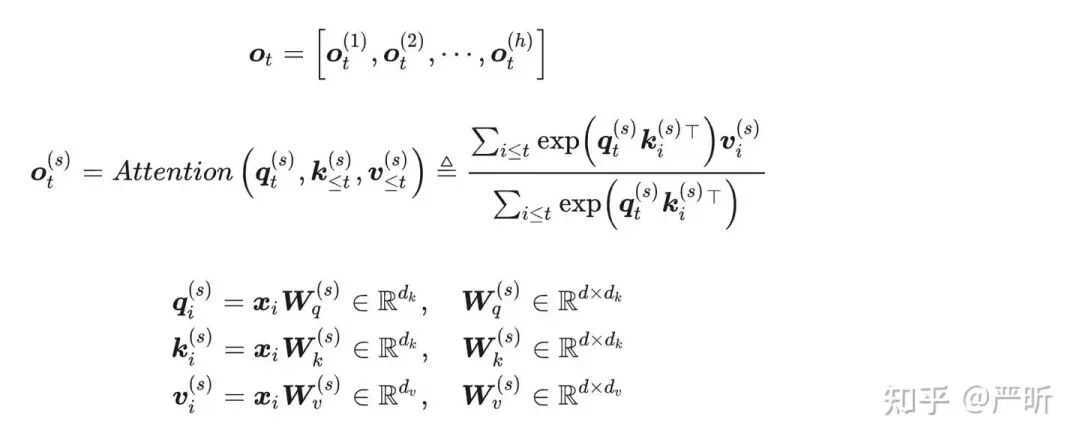
为书写简便,此处略去 Attention 矩阵的缩放因子。从上式不难看出:解码阶段逐个产出 token 时,新预测出的第 t+1 个 token 并不会改变此前已经算好的
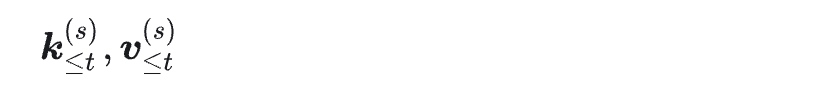
既然如此,这部分结果完全可以存下来供后续步骤复用,省掉重复运算——这正是 KV Cache 的思路。
引入 KV Cache 之后,Multi-Head Attention 的计算过程可表述如下:
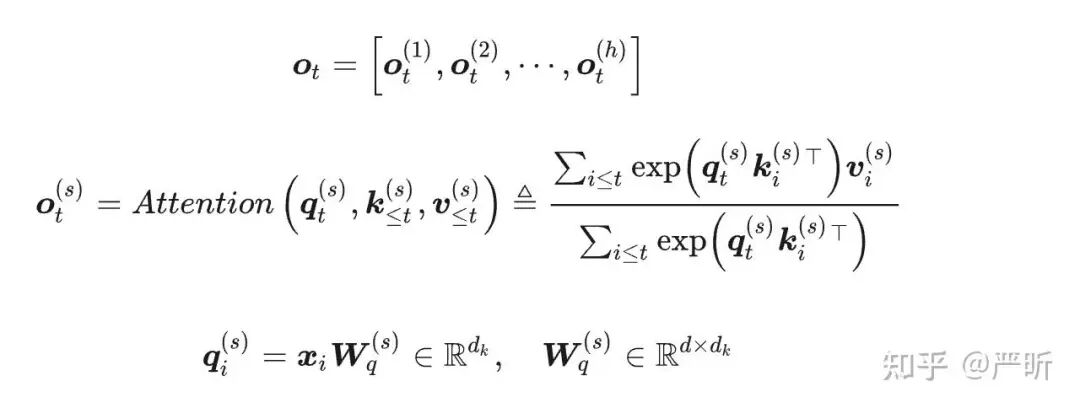
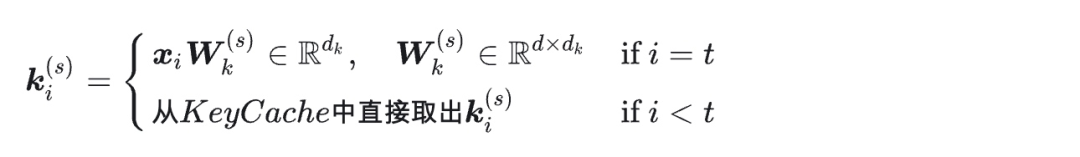
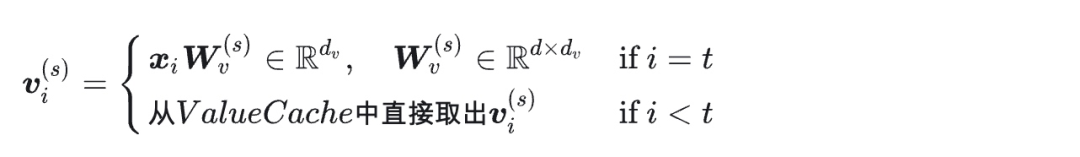
四、用图示理解 KV Cache
如果上面的形式化推导显得过于抽象,可以借助下面这篇博客来理解 KV Cache 的实现思路:
Transformers KV Caching Explained
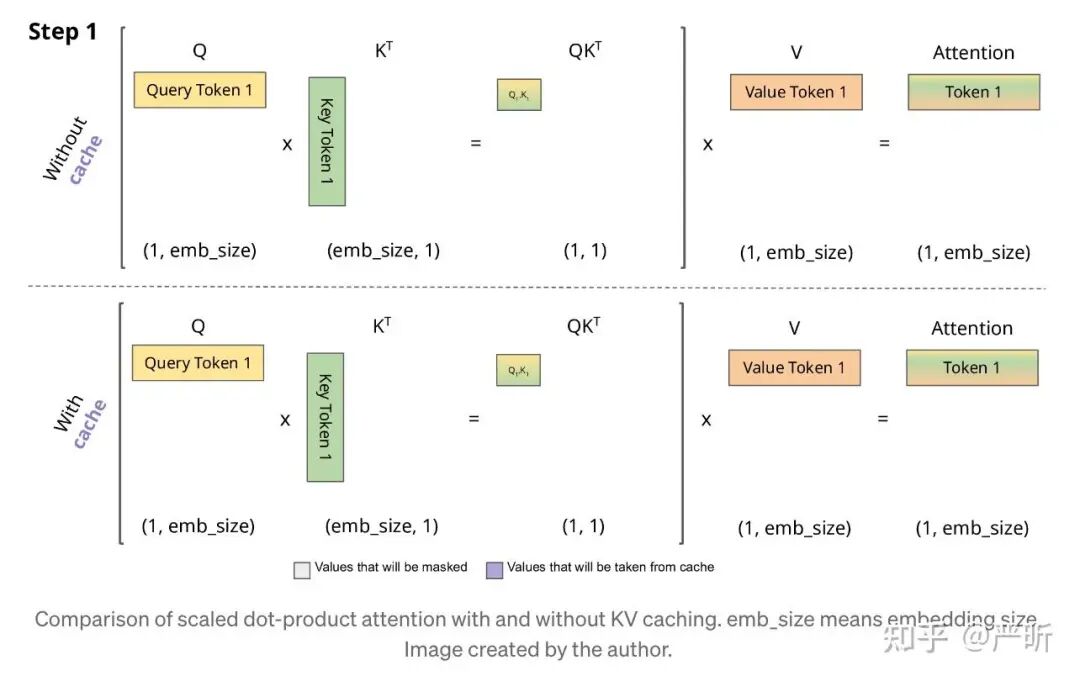
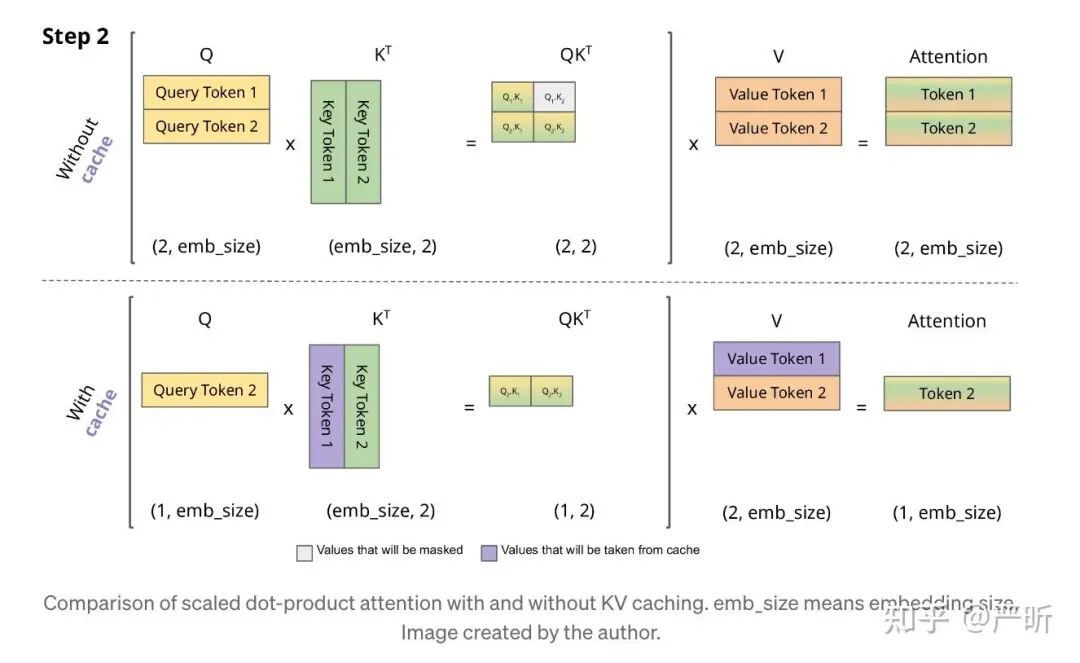
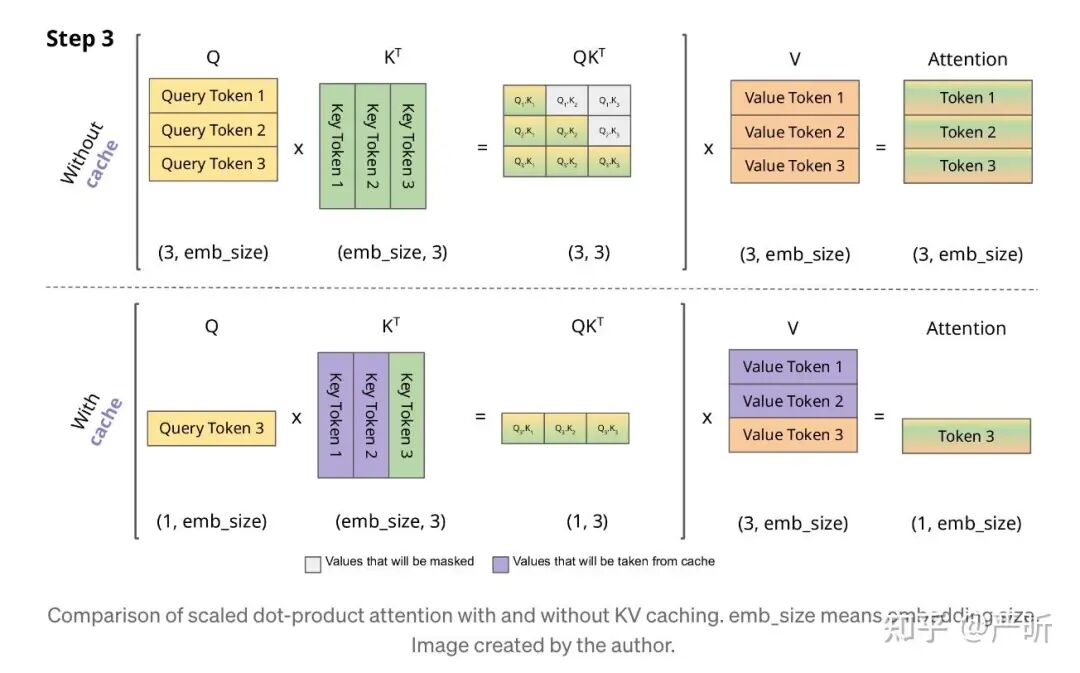
下面 Step1–4 的对比图取自“Transformers KV Caching Explained”,分别展示不用 KV Cache 与使用 KV Cache 时的情形:
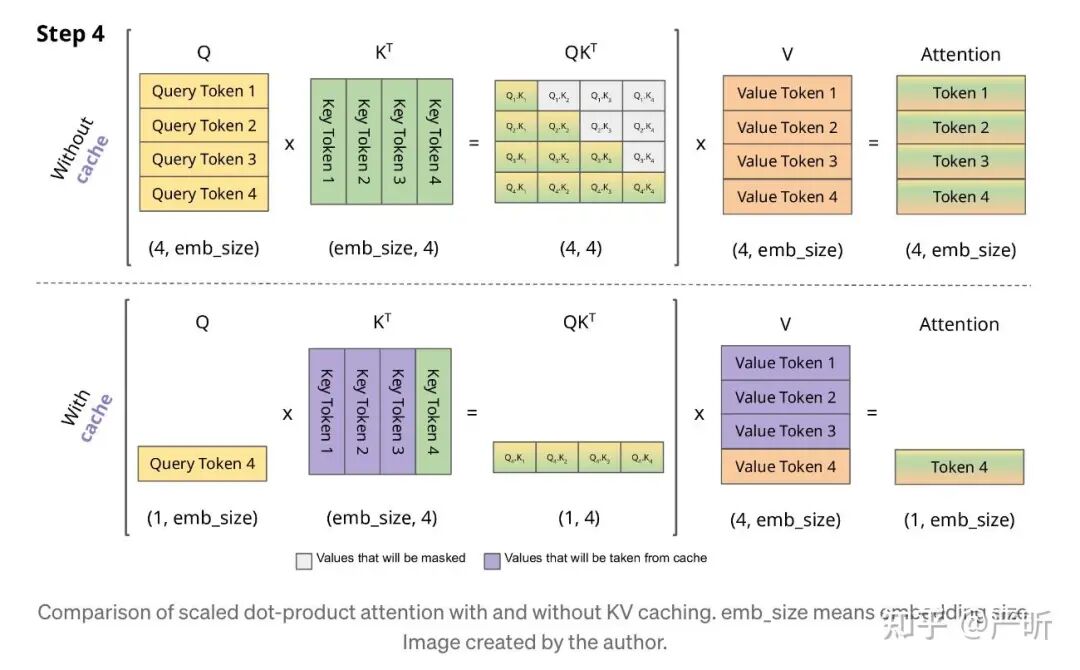
五、KV Cache 能带来多少提速
接下来借助 transformers 库实测 KV Cache 对推理速度的影响。该库的 generate 方法通过 use_cache 参数控制是否启用 KV Cache,相关说明见:
What is the purpose of ‘use_cache’ in decoder?discuss.huggingface.co/t/what-is-the-purpose-of-use-cache-in-decoder/958
测试脚本如下:
import numpy as np
import time
from transformers import AutoModelForCausalLM, AutoTokenizer

checkpoint ="distilgpt2"

tokenizer = AutoTokenizer.from_pretrained(checkpoint)
model = AutoModelForCausalLM.from_pretrained(checkpoint)

for use_cache in(True,False):
    times =[]
for _ inrange(10):# measuring 10 generations
        start = time.time()
        model.generate(**tokenizer("What is KV caching?", return_tensors="pt"),
                   use_cache=use_cache,
                   max_new_tokens=20)
        times.append(time.time()- start)
print(f"TPOT {'with' if use_cache else 'without'} KV caching: "
f"{round(np.mean(times), 3)} +- {round(np.std(times), 3)} seconds")

for use_cache in(True,False):
    times =[]
for _ inrange(10):# measuring 10 generations
        start = time.time()
        model.generate(**tokenizer("What is KV caching?", return_tensors="pt"),
                       use_cache=use_cache,
                       max_new_tokens=1)
        times.append(time.time()- start)
print(
f"TTFT {'with' if use_cache else 'without'} KV caching: "
f"{round(np.mean(times), 3)} +- {round(np.std(times), 3)} seconds")
在Mac M1 笔记本上跑出的结果如下:
TPOT with KV caching: 0.331 +- 0.011 seconds
TPOT without KV caching: 2.037 +- 0.056 seconds
TTFT with KV caching: 0.047 +- 0.002 seconds
TTFT without KV caching: 0.05 +- 0.005 seconds
可以看出,KV Cache 对解码阶段的 TPOT(Time Per Output Token)改善明显,而对预填充阶段的 TTFT(Time To First Token)几乎没有影响。
六、KV Cache 的代价
本质上,KV Cache 是用空间换时间,代价是随之而来的一些新问题:
● 第一,在 GPU 上跑大模型推理时,开启 KV Cache 往往意味着更高的显存占用。显存被占得多,一方面压低了单条序列能容纳的总长度,也就限制了上下文窗口的上限;另一方面也压缩了一次可并行处理的序列数量(即 batch_size),系统吞吐随之受到影响。
● 第二,KV Cache 虽然削减了单次推理的计算量,却在读取缓存上耗费了更多时间。一般而言,把 1MB 数据搬进 GPU 核内的耗时,会超过在核内对这 1MB 数据做一次计算;因此开启 KV Cache 后 GPU 的利用率可能偏低,从成本角度看并不划算。
针对这两点,不少大模型推理框架都在系统层面做优化,思路大致集中在压缩 KV Cache 体积、缓解其碎片化、提高访存效率等方向。
七、参考资料
● The basics of LLM inference
● LLM Inference Series: 2. The two-phase process behind LLMs’ responses
● Transformers KV Caching Explained
● LLM Inference Series: 3. KV caching explained
● The basics of LLM inference
● 缓存与效果的极限拉扯:从MHA、MQA、GQA到MLA
本文转载自微信公众号「程序员Owen」,仅供学习交流使用。
觉得内容不错?我要