
为什么说 KV Cache 复用率是推理系统的核心指标
本文来源: 疯狂的兔子tommy(公众号:疯狂的兔子tommy)
原文链接: https://mp.weixin.qq.com/s/OW7wNQ1wMolqY4oEuNHTow
发布时间: 2026-10-15 08:05
作者: 疯狂的兔子tommy 发布时间: 2026-10-15 08:05
这里是「算力网络架构手记」北京
- 专注 AI 集群网络架构与性能优化
- 深入 GPU×RoCE×NCCL×K8s 跨层瓶颈
- 只拆真实问题,不写概念科普
👇 试听内容
00 少生成,多复用
同一套推理集群。
GPU数量没变。
模型没变。
并发也差不多。
昨天TTFT只有800毫秒,今天却涨到3秒。
第一反应通常是:
- GPU是不是降频了?
- 网络是不是拥塞了?
- Batch是不是没调好?
这些都有可能。
但还有一个更容易被忽视的变量:
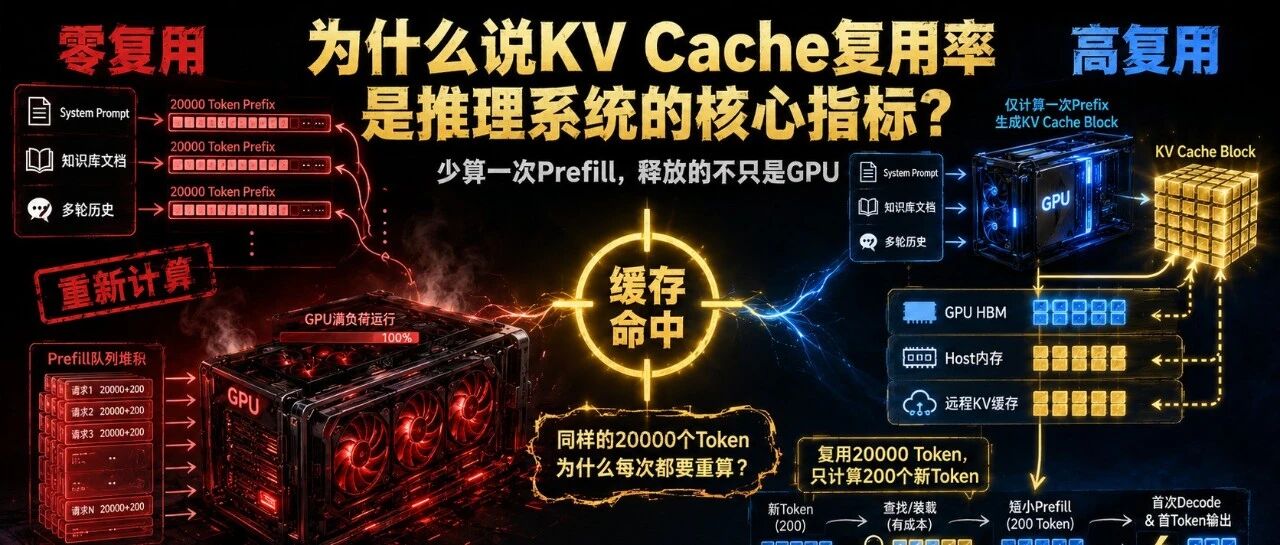
昨天,大量请求复用了已有KV Cache;今天,这些请求全部重新做了一遍Prefill。
例如,一个智能客服请求包含:
8000 Token的系统提示词
12000 Token的知识库内容
200 Token的用户问题
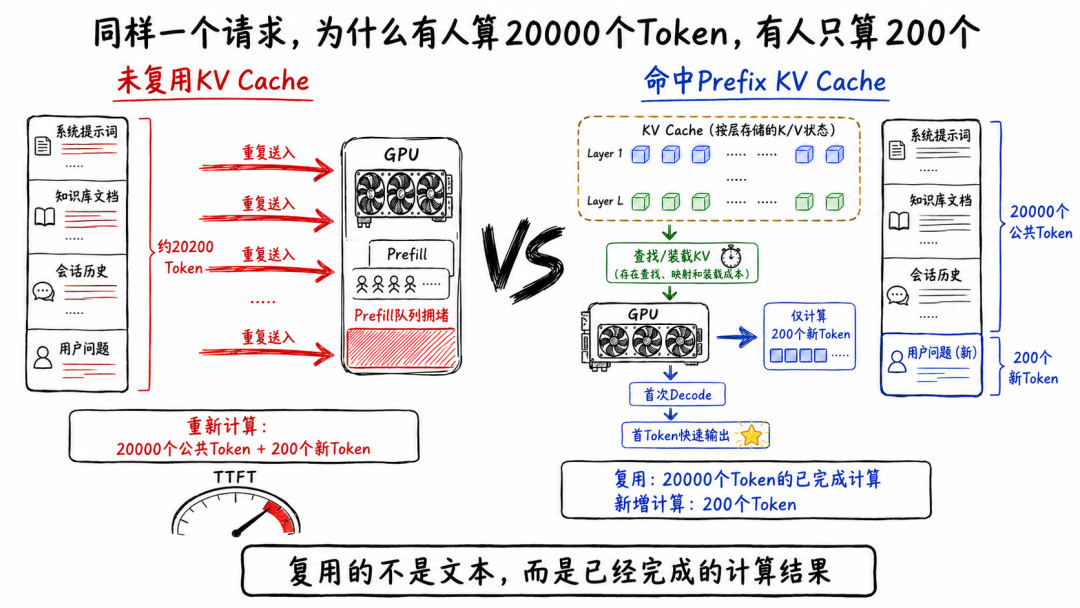
如果每次请求都重新处理前面的20000个Token,GPU就要反复完成几乎相同的Prefill计算。
但如果这些公共前缀对应的KV Cache已经存在,新请求只需要处理最后变化的200个Token。
从业务视角看,只是“缓存命中了一次”。
从系统视角看,却意味着:
- 少算了20000个Token
- 少占用了一次Prefill Batch
- 少执行了大量跨GPU通信
- 少等待了一轮调度
- 更早进入Decode
于是,TTFT下降。
GPU资源释放。
QPM上升。
单位时间处理的Token增加。
甚至Prefill集群、算力网络和电力成本都可能同时下降。
KV Cache复用率衡量的不是“缓存好不好看”,而是推理系统有多少重复计算真正被消灭了。
这就是为什么,在长上下文、RAG、多轮对话、Agent和P/D分离场景下,KV Cache复用率正在成为推理系统最核心的指标之一。
01 先说清楚:KV Cache复用,到底复用的是什么
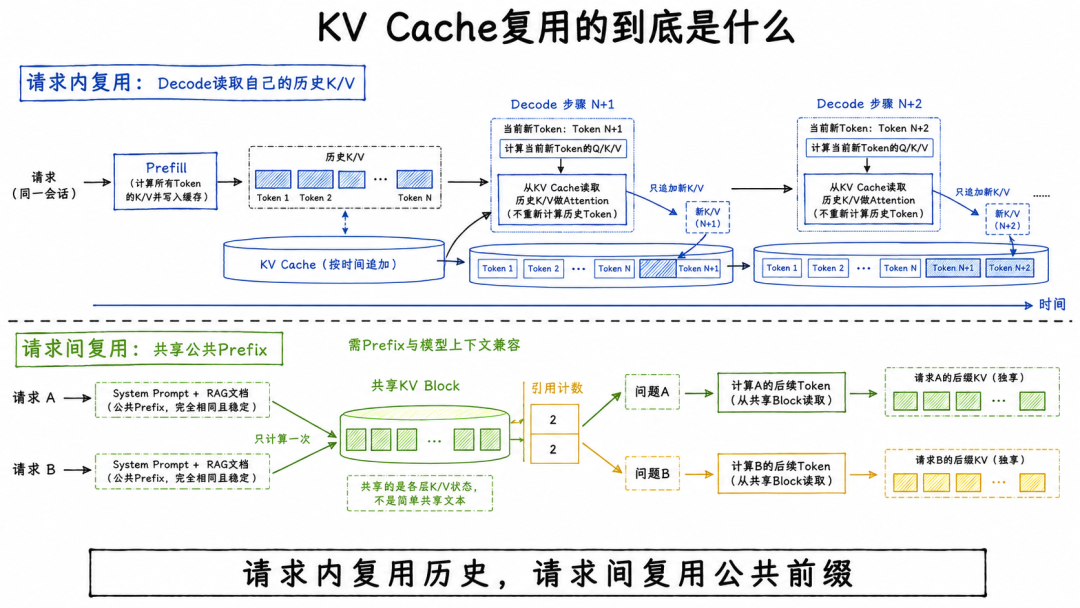
Transformer生成下一个Token时,需要让当前Query与历史Token对应的Key、Value参与注意力计算。
如果没有KV Cache,每生成一个新Token,都要重新计算全部历史Token的Key和Value。
有了KV Cache,同一个请求在Decode过程中可以直接读取历史K、V,只计算新Token产生的那一小部分。
这是请求内复用。
但生产系统讨论“KV Cache复用率”时,通常更关心另一层:
请求之间的Prefix KV复用。
例如,两个请求分别是:
- 请求A:系统提示词 + 同一份文档 + 问题A
- 请求B:系统提示词 + 同一份文档 + 问题B
它们前面的大段Token完全一致。
请求A完成Prefill后,这段公共前缀对应的各层K、V已经计算出来。请求B到达时,如果模型、Token序列和相关缓存身份一致,就可以直接复用这部分KV,只计算新的问题。
vLLM的Automatic Prefix Caching采用按Block哈希匹配的方式,Block身份不仅与当前Block的Token有关,也与之前的Prefix、LoRA、部分多模态身份及隔离盐等有关;而且通常只复用完整匹配的Block。所以,KV复用不是:
两段话意思差不多,就能复用而是:
- Token化后的前缀确实一致
- 缓存身份兼容
- 对应KV Block仍然存在
- 请求被路由到可以访问这些Block的位置
KV Cache复用复用的是确定前缀已经算出的注意力状态,不是对自然语言“意思相近”的模糊匹配。
02 为什么复用率比GPU利用率更接近问题本质
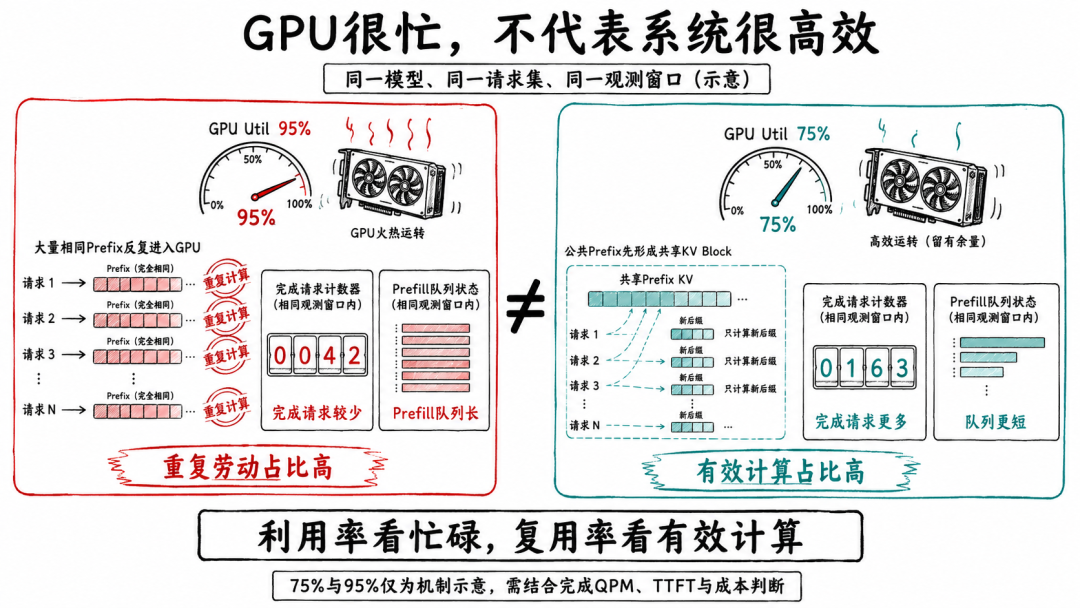
GPU利用率只能告诉你GPU在忙。
它不告诉你GPU忙得是否有价值。
假设一组Prefill GPU利用率长期保持95%。
看起来资源吃得很满。
但如果其中60%的工作都是重复处理相同系统提示词、相同知识库文档和相同多轮对话历史,那么这95%的GPU利用率,本质上包含大量重复劳动。
另一套系统GPU利用率只有75%,却通过KV复用完成了更多请求。
哪套系统效率更高?
显然是后者。
因为推理系统真正关心的不是:
GPU有没有一直工作而是:
每消耗一秒GPU时间
完成了多少新的、不可复用的计算
KV复用率恰好揭示了这件事。
它把“输入Token很多”进一步拆成:
- 真正需要计算的Token
- 已经计算过、可以复用的Token
只有把这两类Token分开,才能判断Prefill吞吐、GPU利用率和单位请求成本是否真实。
GPU利用率描述设备忙不忙,KV Cache复用率描述这些忙碌中有多少本可以避免。
03 一个“复用率”其实至少有三种口径
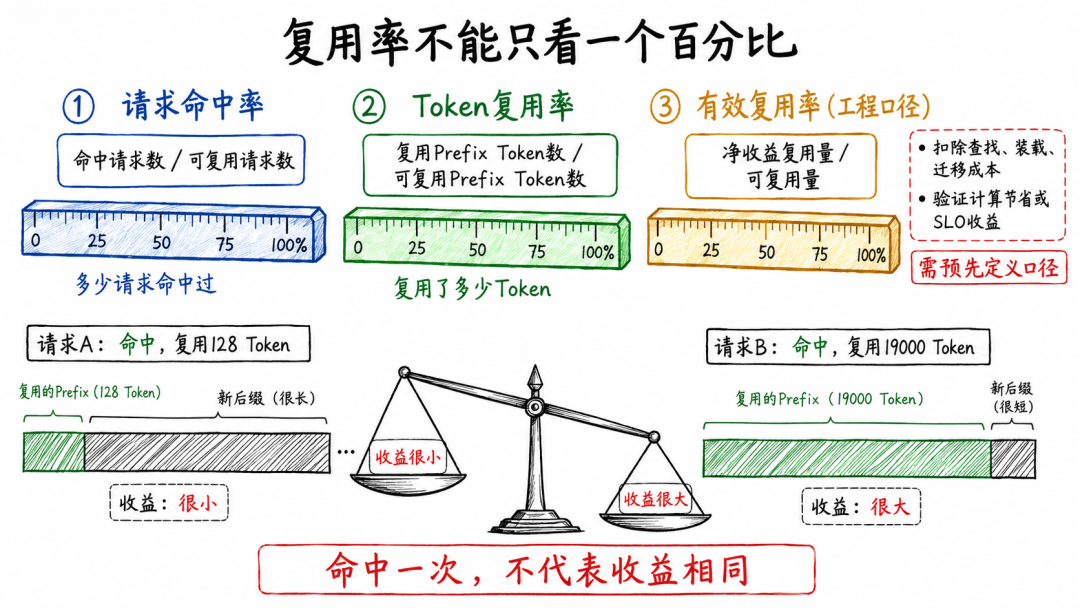
最简单的是请求命中率:
请求命中率
= 命中过KV Cache的请求数
÷ 总请求数
但这个指标非常容易虚高。
请求A有20000个输入Token,只复用了前128个Token,也可以算一次“命中”。
它和复用19000个Token的请求,在请求命中率里没有区别。
因此,更有价值的是Token复用率:
Token复用率
= 被复用的Prefix Token数
÷ 总输入Token数
如果100个请求总共输入100万个Token,其中60万个Token直接复用了已有KV,那么Token复用率是60%。
第三种,也是最接近业务价值的指标,是有效复用率。
因为从远端存储加载KV也有成本。
可以把它理解为:
有效收益
= 重新Prefill所需时间
- 查找、传输、恢复和等待KV的时间
如果重新计算需要200毫秒,而从远端加载KV需要50毫秒,这次复用很有价值。
如果重新计算只需5毫秒,远端读取却花了20毫秒,那么虽然“命中了”,系统反而更慢。
请求命中率回答“有没有命中”,Token复用率回答“省了多少计算”,有效复用率回答“最终到底省没省时间”。
04 复用率为什么首先影响TTFT
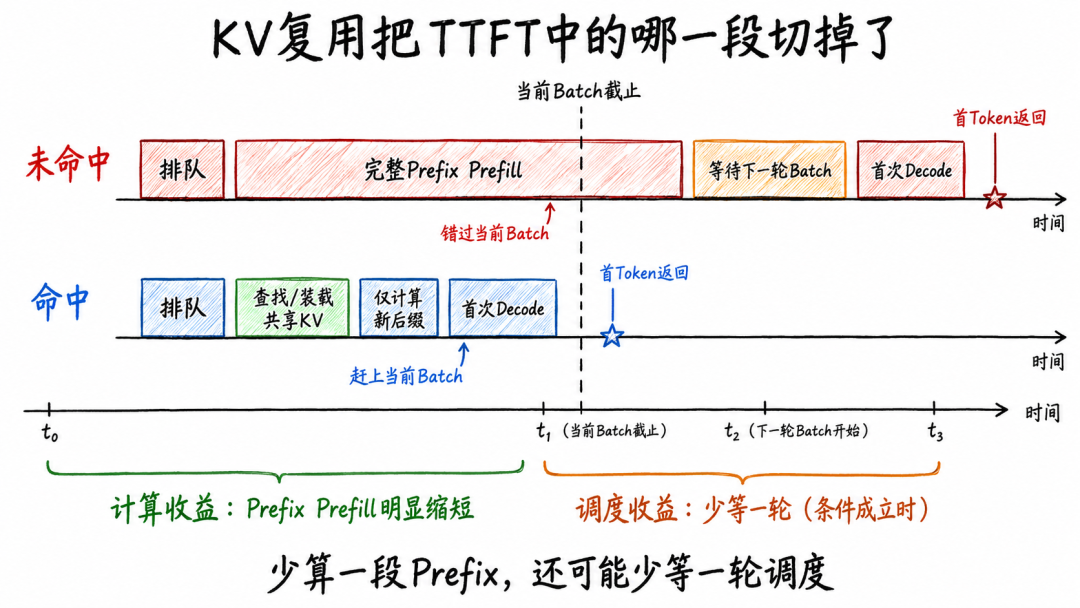
TTFT通常可以拆成:
请求传输
+ 排队
+ 调度
+ Prefill
+ KV转移
+ 首次Decode
+ 首Token返回
KV Cache复用主要缩短其中的Prefill部分。
假设请求共有20000个输入Token,命中18000个Prefix Token,那么Prefill只需处理剩余2000个Token。
这不仅减少计算时间,还可能让请求更容易被塞进当前调度轮次。
如果完全不复用,长Prompt可能因为所需KV Block、Token Budget或Batch空间不足,被推迟到下一轮。
因此,复用带来的TTFT收益往往包括两部分:
少计算的时间
+
少排队、少错过调度窗口的时间
vLLM官方文档也明确指出,Prefix Caching主要减少Query的Prefill计算,对重复查询长文档和多轮会话尤其有效;但它不会直接减少新Token的Decode时间。所以,如果业务是:
超长Prompt + 短回答复用率对TTFT影响非常大。
如果是:
短Prompt + 超长回答复用收益则可能被漫长Decode稀释。
KV复用最先拯救的是“回答什么时候开始”,而不是“回答开始后每个Token生成多快”。
05 复用率为什么会继续影响QPM、TPS和TPM
KV复用看起来只是减少了一次Prefill。
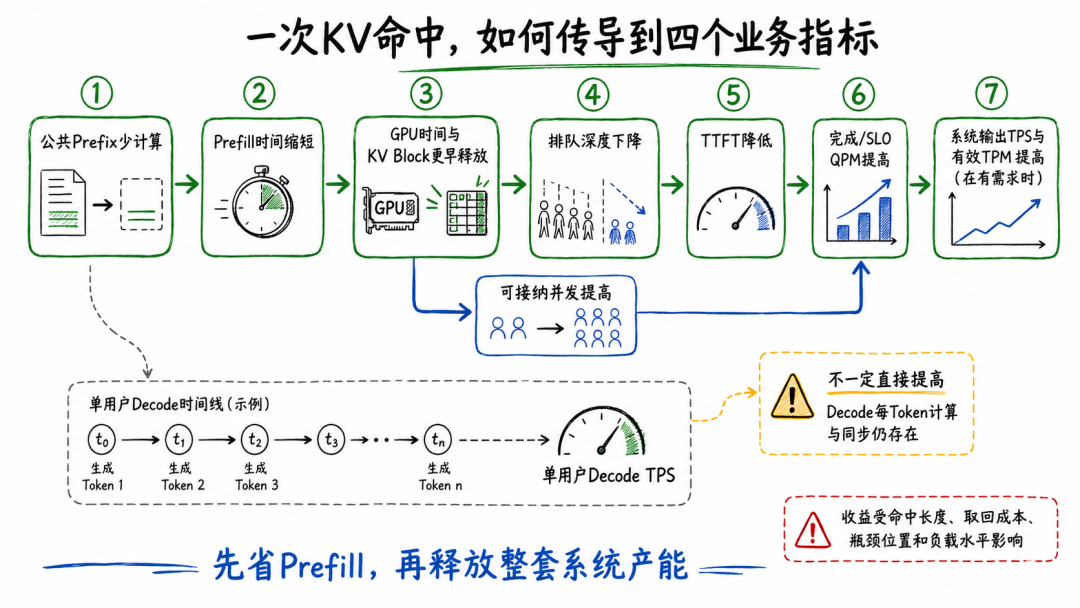
但Prefill资源被释放后,会产生连锁反应:
单个请求Prefill时间下降
→ GPU更快释放计算资源
→ Batch能够接纳更多请求
→ 等待队列缩短
→ 完成QPM提高
对系统总TPS和TPM也是如此。
当Prefill占用较少GPU时间,系统可以把更多时间片和显存空间留给Decode,或者在相同时间内处理更多输入Token。
不过要注意:
KV复用不一定直接提高单用户Decode TPS。
如果瓶颈位于显存带宽、Decode Batch过大、Tensor Parallel通信或慢Expert,复用只会让请求更早开始生成,不一定让生成过程本身更快。
因此更准确的因果关系是:
高复用率
→ Prefill工作量下降
→ TTFT改善
→ 排队减少
→ 系统QPM、总TPS和TPM提高
而不是:
高复用率
→ 所有性能指标无条件变好
KV复用率提高的是整套系统的有效产能;它最直接优化Prefill,随后通过资源释放改善吞吐。
06 高复用率还能减少多少显存浪费
KV Cache不仅消耗计算,也消耗容量。
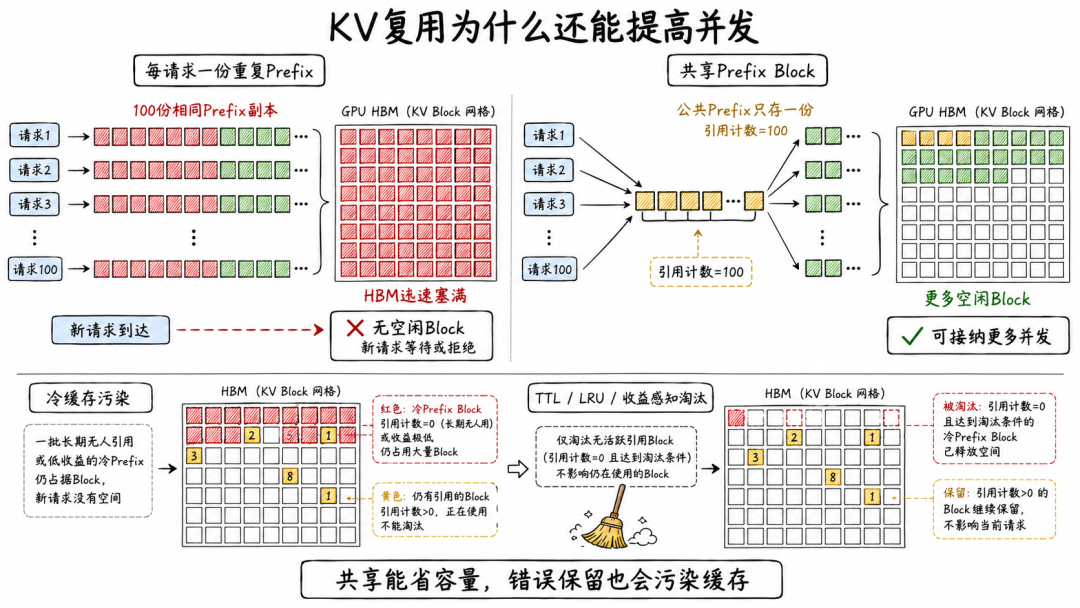
如果100个并发请求都携带相同的10000 Token系统前缀,却各自保存一份独立KV,那么大量HBM会被相同内容占据。
采用Block级共享和引用计数后,多个请求可以共同引用相同Prefix Block,只为各自不同的后缀分配新Block。
这会带来三层收益:
相同KV少存几份
→ 可用KV容量增加
→ 能容纳更多并发Sequence
→ 因容量不足导致的抢占、重计算和排队减少
但缓存也不是越多越好。
被缓存的Block仍然占空间。
如果系统保留了大量只使用一次的冷Prefix,就会挤压活跃请求的Decode KV。
结果可能是:
- 缓存命中率没有明显提高
- GPU KV使用率却接近上限
- 新请求难以分配Block
- 旧请求发生抢占或重计算
所以必须同时观察:
复用次数
Block驻留时间
最后一次访问到淘汰的间隔
淘汰率
活跃KV与可复用KV的容量占比
vLLM也提供KV Block生命周期、复用间隔和淘汰前空闲时间等指标,用于识别长期占位却不再复用的缓存。好的缓存不是“尽量不删”,而是让最可能再次使用的KV留在最快、最贵的存储层。
07 为什么有缓存,还必须做KV-Aware Routing
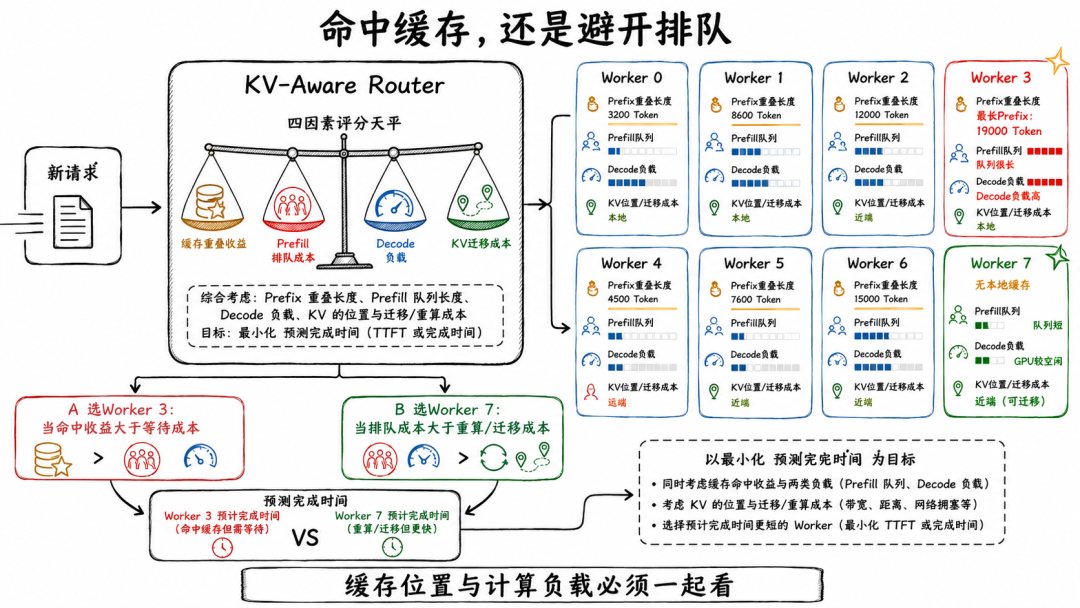
假设集群有8个推理Worker。
某个Prefix的KV只存在Worker 3上。
新请求到达时,如果负载均衡器采用随机、轮询或只看GPU利用率,可能把它发到Worker 7。
对Worker 7来说,这次请求等于完全未命中。
它只能:
重新做Prefill
或者从Worker 3搬运KV
所以,缓存复用率不是缓存系统单方面决定的。
它还取决于Router能否回答:
- 哪个Worker拥有最长Prefix?
- 哪个Worker当前排队最少?
- 去缓存所在Worker是否值得?
- 搬KV和重算哪个更快?
这也是KV-Aware Routing存在的原因。
但只追求缓存命中同样会出问题。
如果大量热门请求都命中Worker 3,Router把它们全部发向Worker 3,就可能出现:
Worker 3缓存命中率很高
但队列越来越长
其他Worker相对空闲
全局TTFT反而恶化
因此,Dynamo的路由思想并不是只看KV重叠,而是把可复用Prefix与Prefill、Decode等活动负载一起计入成本。
最优路由不是“永远追着缓存走”,而是在复用收益与排队代价之间做选择。
08 本地命中、同机命中、远程命中,价值完全不同
“KV命中了”还不够。
必须继续问:
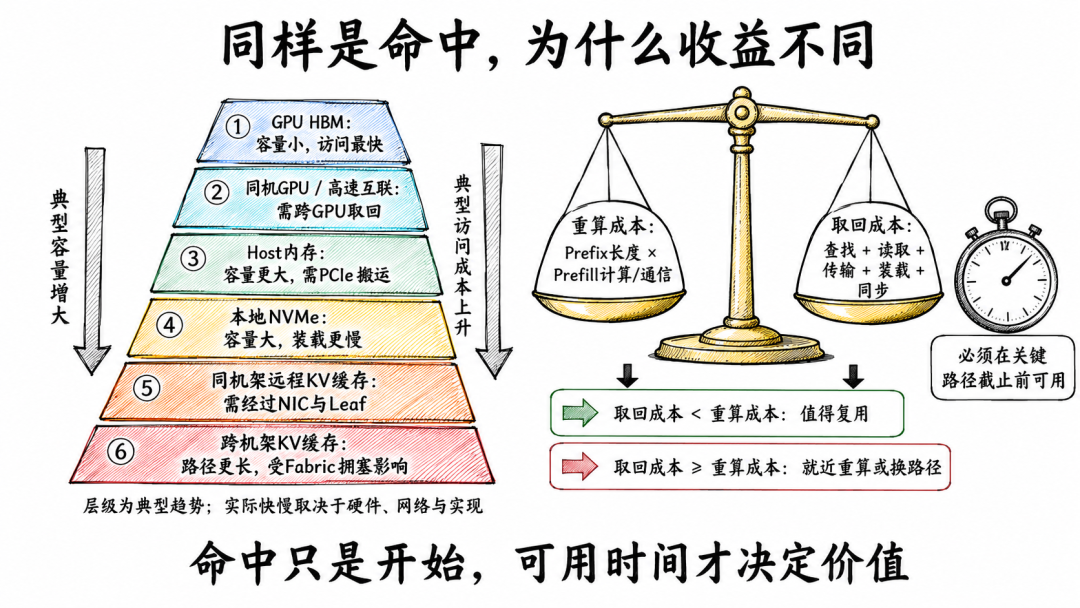
命中的KV在哪里?
典型KV层级可能包括:
本GPU HBM
→ 同机其他GPU
→ Host内存
→ 同机NVMe
→ 同机架远程GPU或缓存节点
→ 跨机架远程存储
本GPU HBM中的KV可以直接进入计算路径,价值最高。
同机其他GPU可能经过NVLink、NVSwitch或PCIe。
Host内存需要把KV重新搬回GPU。
远程缓存则要经过NIC、交换机和远端内存系统。
因此,“远程命中”不等于“立刻可用”。
真正有意义的判断应该是:
重新Prefill耗时
>
KV查找 + 排队 + 网络传输 + GPU可见性同步耗时
如果不满足这个条件,命中只是统计意义上的命中。
NVIDIA的KVBM等方案把KV扩展到CPU和存储层,但官方文档也特别提醒:层级容量配置不当会造成频繁上卸载和缓存抖动,甚至导致性能下降。缓存命中的价值,由“省下多少计算”减去“为了取回缓存付出多少代价”决定。
09 P/D分离之后,复用率为什么直接变成网络指标
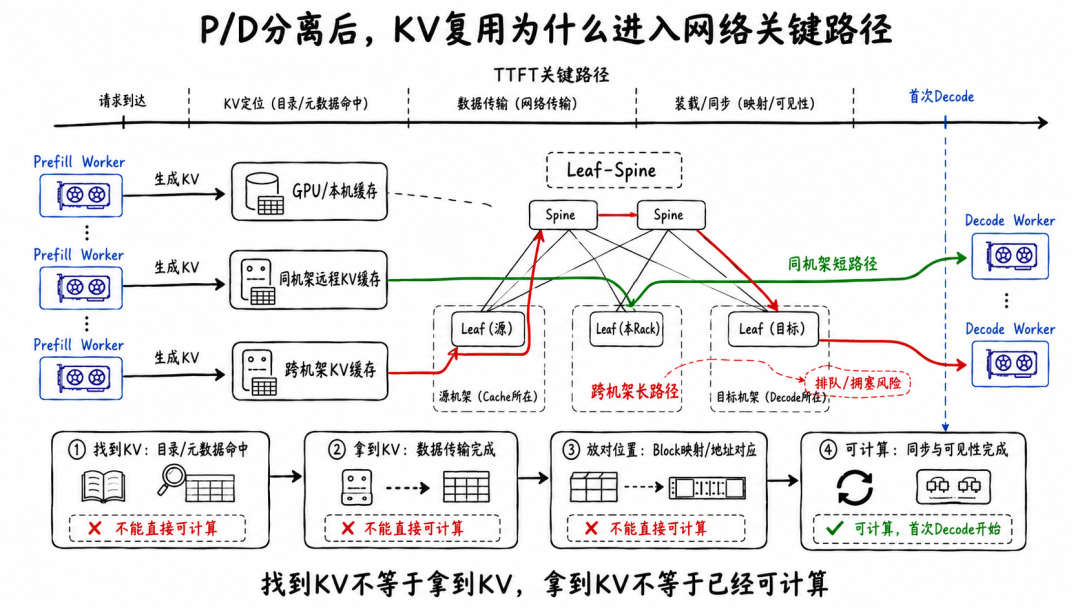
在P/D分离架构中,Prefill和Decode运行在不同Worker。
一次请求可能经历:
Router选择Prefill Worker
→ 查询Prefix KV
→ 计算未命中部分
→ 把完整KV交给Decode Worker
→ Decode开始生成
如果Prefix已经存在于Decode Worker本地,那么可以减少Prefill计算,也减少KV迁移。
如果KV存在另一台机器上,就必须决定:
远程读取KV
还是重新Prefill
这时,KV复用率已经不只是缓存指标。
它会与以下网络指标绑定:
KV传输带宽
传输P95/P99
GPU-NIC亲和性
GPUDirect RDMA是否生效
是否回退TCP
跨Leaf或跨机架路径
接收端处理能力
最理想的情况不是“全局任何地方都能找到KV”,而是:
热门KV尽量靠近消费它的Decode Worker
请求尽量路由到KV所在拓扑域
远程迁移只在收益大于代价时发生
拓扑感知KV路由的价值就在这里:尽量把Prefill与Decode之间的KV访问限制在更近的机架或拓扑域,减少不必要的慢路径。
P/D分离让KV从GPU内部状态,变成了需要被定位、传输和调度的分布式数据。
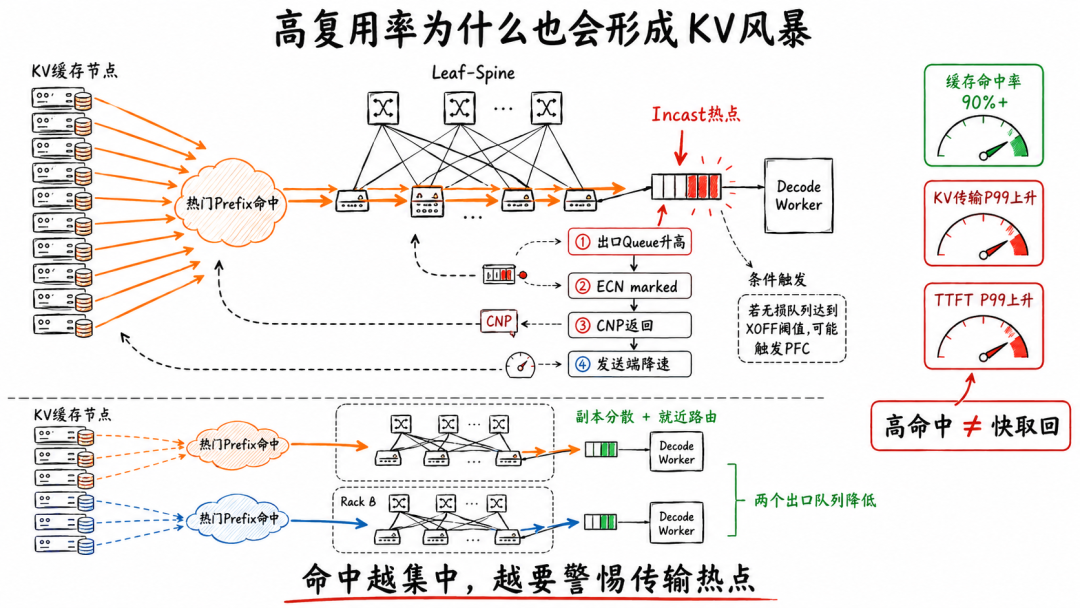
10 高复用率为什么也可能制造Incast
这是一个很反直觉的现象。
KV复用率越高,理论上重复计算越少。
但如果大量请求同时从少数缓存节点读取热门KV,就可能出现:
多个Decode Worker
→ 同时请求同一批KV
→ 缓存节点向多个方向集中发送
或者:
多个缓存节点
→ 同时向一个Decode Worker恢复KV
→ Decode侧入口形成Incast
在RoCE网络中,突发KV流量可能推高交换机队列。
达到ECN阈值后,报文被标记CE,接收端产生CNP,发送端通过DCQCN等机制降速。
如果队列继续上升并触发PFC,Pause还可能沿上游传播。
最终发生:
- 缓存命中率很高
- KV恢复却很慢
- TTFT P99升高
- Decode Worker等待数据
所以,不能只观察一分钟平均KV带宽。
更应该看:
- 微秒级队列峰值
- KV传输P99
- 热点缓存节点出口
- 同一时刻的ECN/CNP/PFC增量
- 各Rail流量是否均衡
缓存消灭了计算流量,却可能集中制造数据搬运流量;热点从GPU转移到了网络,并不等于热点消失。
11 KV复用与NCCL是什么关系
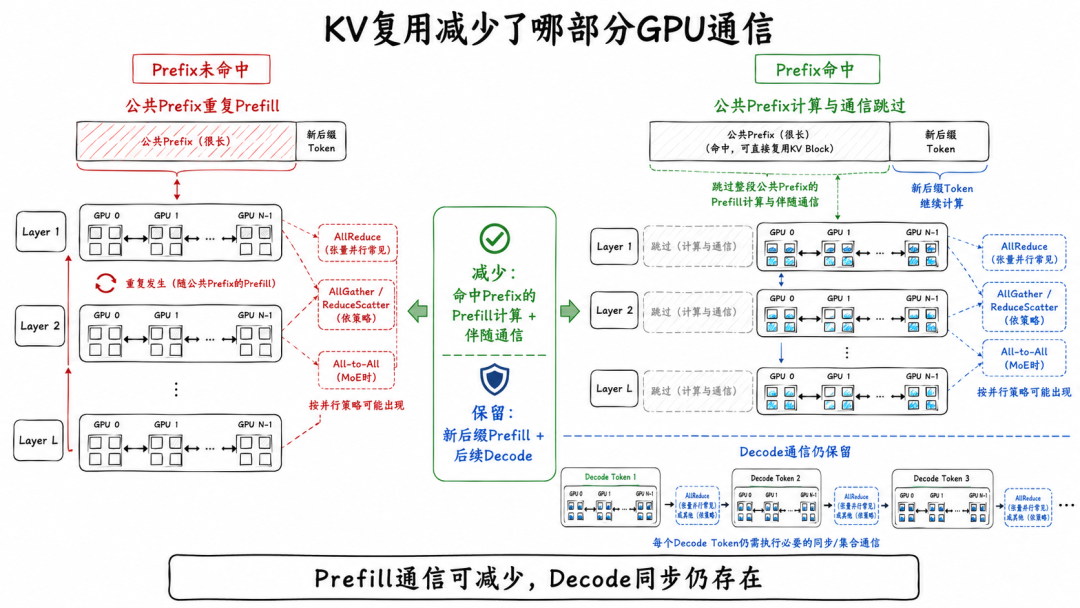
KV Prefix Caching本身不是NCCL集合通信。
缓存查询、Block管理和远程KV搬运,也不一定使用AllReduce。
但在多GPU模型并行中,重新Prefill需要让输入经过模型的每一层。
Tensor Parallel可能触发AllReduce、AllGather或ReduceScatter;Pipeline Parallel需要传递中间激活;MoE的Expert Parallel可能触发All-to-All式Dispatch与Combine。
如果大段Prefix能够直接复用,就等于跳过了这部分Token对应的大量Prefill计算,也连带避免了相关的跨GPU通信。
因果关系是:
Prefix Token命中
→ 对应Prefill计算被跳过
→ 相关TP/PP/EP通信减少
→ GPU与Fabric资源释放
但进入Decode以后,新Token仍要经过正常模型计算。
如果Decode使用跨节点Tensor Parallel,相关NCCL或其他通信不会因为Prefix命中而消失。
所以,KV复用可以减少Prefill阶段的通信压力,却不能替代对Decode网络时延和slow rank的优化。
KV复用减少的是“本不必再次发生的Prefill通信”,不是让整个分布式推理从此不再需要NCCL。
12 为什么复用率很高,TTFT却不一定低
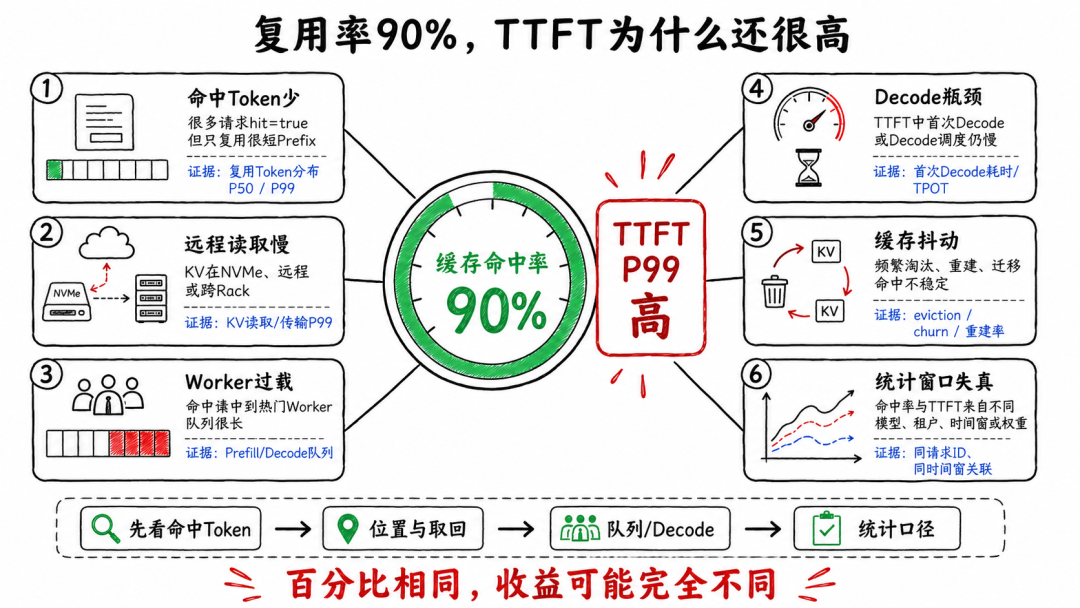
第一种情况:复用的Token太少
大量请求只命中几十个Token,命中率很高,Token复用率却很低。
第二种情况:KV在远端
省下100毫秒Prefill,却花了150毫秒取回KV。
第三种情况:缓存所在Worker已经过载
命中虽然完整,但排队时间远大于重算时间。
第四种情况:Decode才是瓶颈
长输出、高并发或跨节点TP导致TPOT很高,Prefill优化无法解决生成慢。
第五种情况:工作集大于缓存容量
热门KV刚被写入就被淘汰,需要时又重新计算,形成Cache Thrashing。
第六种情况:统计窗口掩盖了变化
全天平均复用率很高,但业务高峰、模型发布或实例扩容后的冷启动阶段,复用率突然下降。
因此,复用率必须与以下指标一起看:
- 命中Token数分布
- 本地/远程命中比例
- KV查询与传输时延
- Prefill计算时延
- 请求排队时间
- 淘汰率
- TTFT P95/P99
复用率是核心指标,但不是单指标真相;只有与位置、成本和业务时延结合,才能解释真实收益。
13 哪些业务天然适合KV复用
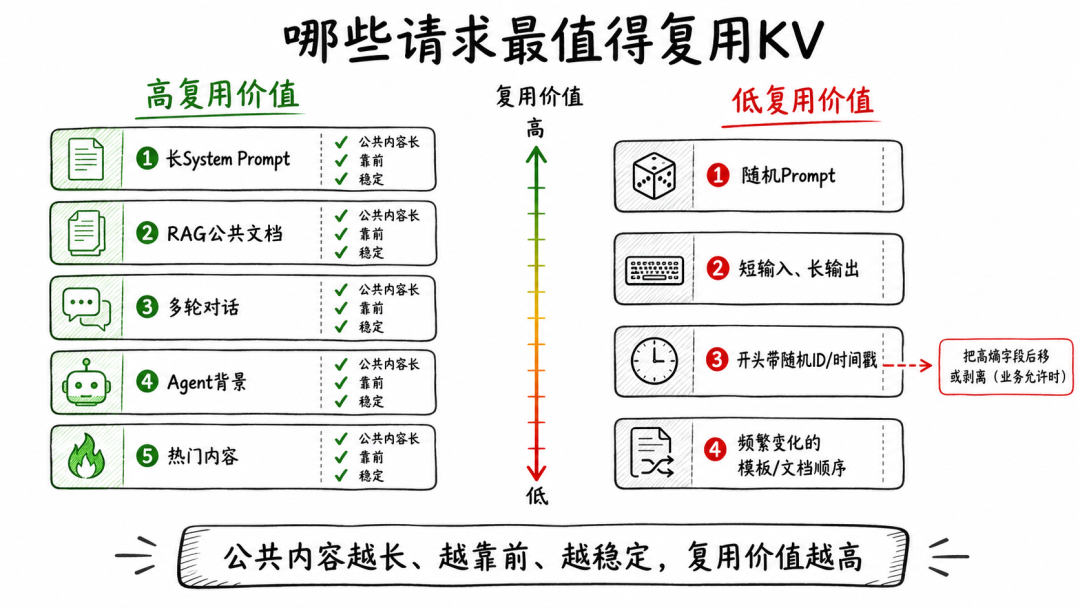
第一类是超长固定System Prompt
例如统一的安全规则、角色设定、输出格式和企业知识。
第二类是RAG
多个用户可能反复查询同一份合同、手册、代码库或产品文档。
第三类是多轮对话
每一轮请求都会携带前面的完整会话历史,越往后可复用Prefix越长。
第四类是Agent工作流
多个步骤共享相同工具说明、任务背景和上下文。
第五类是热门内容服务
大量用户在短时间内查询相同事件、课程资料或知识库。
但以下业务复用潜力较低:
每个Prompt都高度随机
公共前缀很短
输入很短、输出很长
模板把时间戳或随机ID放在最前面
请求被无规则地打散到大量Worker
尤其要注意Prompt结构。
如果每次请求都把随机字段放在最前面,即使后面99%的内容相同,标准Prefix Cache也可能从开头就无法继续匹配。
复用率不只是推理引擎问题,它从Prompt模板、Token顺序和业务路由设计时就已经被决定。
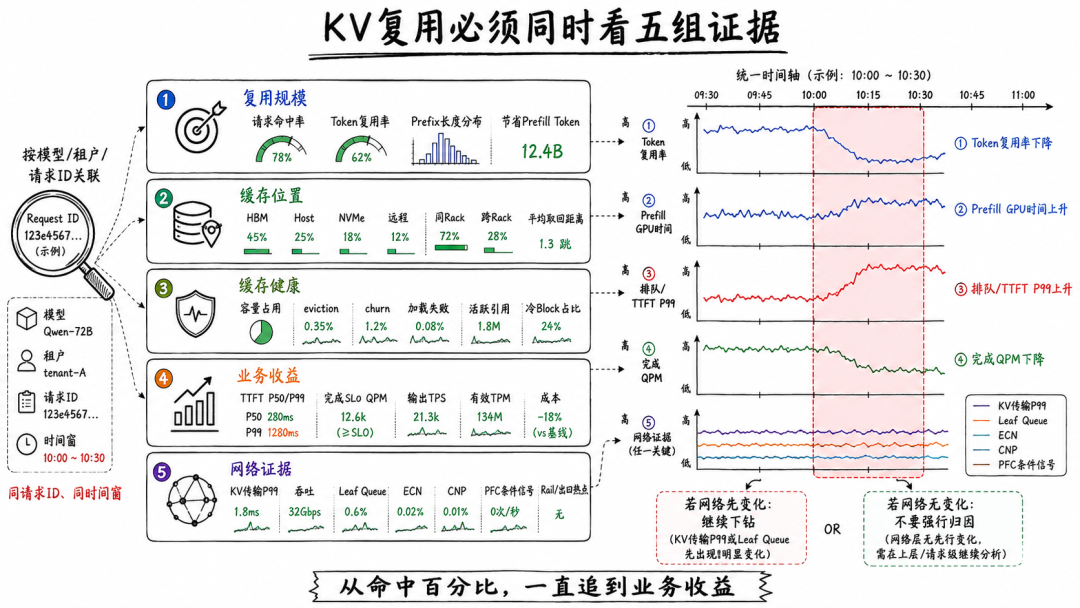
14 生产环境应该怎样建立KV复用仪表板
第一组是复用规模:
Prefix查询Token总数
命中Token总数
Token复用率
每请求命中Token分布
完全命中、部分命中、未命中比例
第二组是缓存位置:
GPU HBM命中率
Host内存命中率
本地NVMe命中率
远程缓存命中率
跨机架命中比例
第三组是缓存健康:
GPU KV使用率
Block分配失败
淘汰速率
Block复用次数
驻留时间
复用间隔
缓存写入与加载带宽
第四组是业务收益:
命中与未命中的TTFT对比
实际Prefill Token数
节省的Prefill Token数
KV加载时间
等待队列长度
完成QPM
满足SLO的有效TPM
第五组是网络证据:
KV传输P50/P95/P99
各缓存节点吞吐
各Rail流量
交换机队列
ECN、CNP、PFC增量
RDMA错误与TCP回退
最关键的一张图,是把“复用率、KV加载时延、Prefill时延、TTFT和网络拥塞”对齐到同一时间轴。
这样才能回答:
- 到底是缓存没命中?
- 还是命中了,但取回太慢?
复用仪表板的终点不是展示一个Hit Rate,而是证明每次命中究竟节省了多少时间、算力、显存和网络成本。
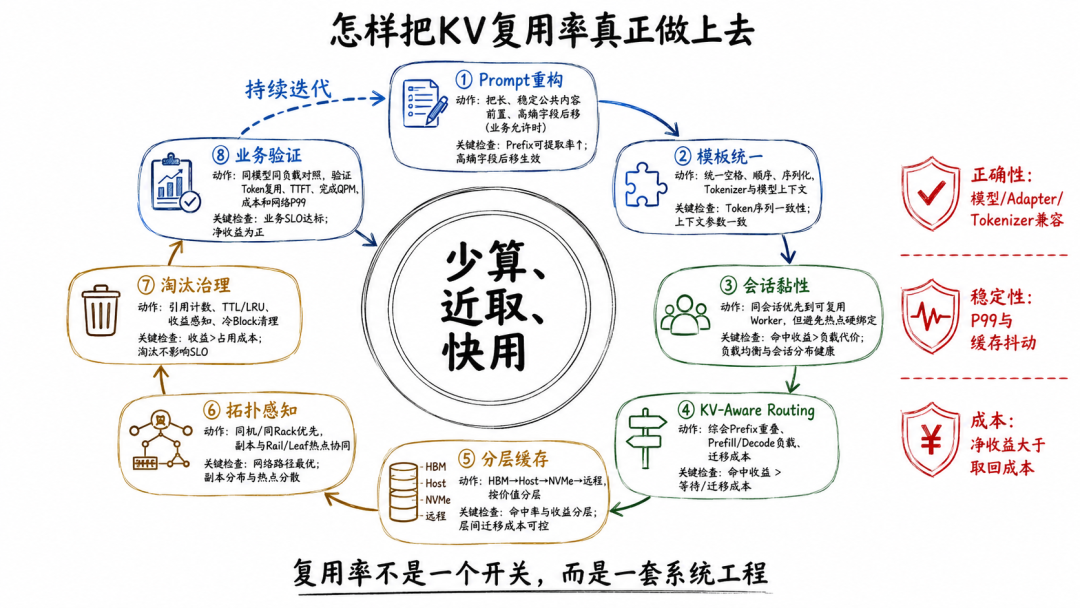
15 如何真正提高KV Cache复用率
第一,重构Prompt
把稳定、共享的内容尽量放在前面,把用户ID、时间戳、随机数和动态字段放在后面。
第二,统一模板
看起来相同的提示词,如果空格、换行、工具列表顺序或序列化方式不同,Token序列就可能不同。
第三,做会话黏性
多轮对话尽量路由到仍持有其Prefix KV的Worker。
第四,使用KV-Aware Routing
同时考虑Prefix重叠、Worker排队、Decode负载和迁移成本,不能只看命中率。
第五,设计分层缓存
热门KV留在HBM,温数据进入Host内存或本地NVMe,冷数据是否进入远端缓存,要根据重算与取回成本决定。
第六,做拓扑感知
优先本机、同机架和同拓扑域复用,控制不必要的跨机架KV迁移。
第七,避免缓存污染
根据复用间隔、热度和容量选择淘汰策略,而不是把所有KV长期保存。
第八,用真实业务验证
固定模型、输入长度、输出长度和并发,对比:
- 关闭复用
- 仅本地复用
- 分层复用
- KV-Aware Routing
最终观察的不是Hit Rate峰值,而是TTFT、完成QPM、有效TPM和单位请求成本。
提高复用率的正确路径,是让业务模板、Router、缓存层级与算力网络共同围绕“少算、近取、快用”设计。
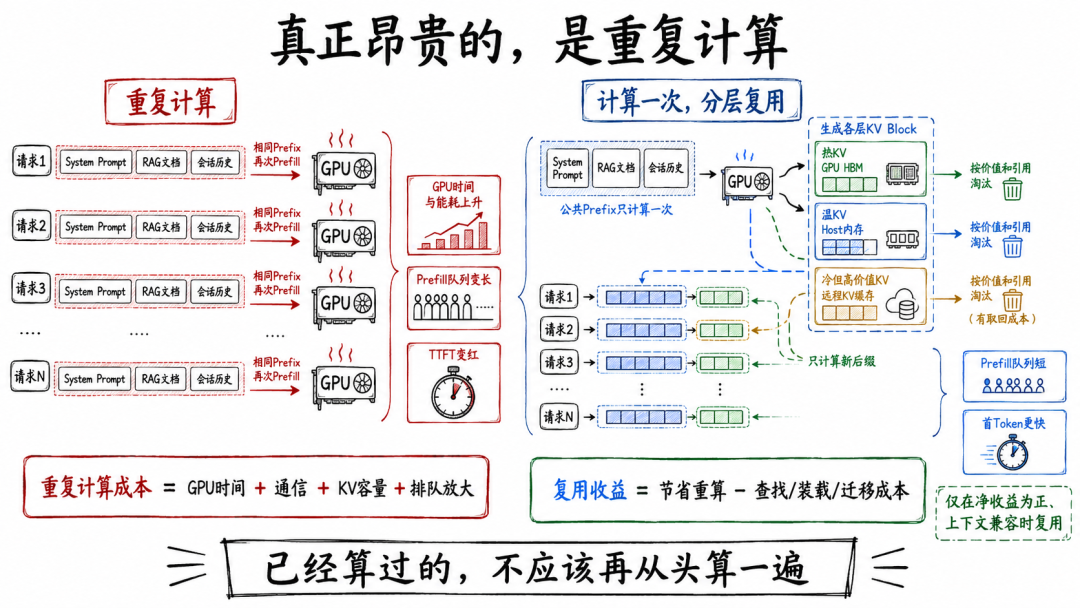
16 真正昂贵的不是计算,而是重复计算
大模型推理为什么贵?
因为参数量大。
因为GPU贵。
因为显存有限。
因为多机通信复杂。
这些都对。
但在大量真实业务里,还有一种更隐蔽的浪费:
同一段上下文,被一遍又一遍重新Prefill。
同样的System Prompt。
同样的知识库。
同样的会话历史。
同样的Agent工具说明。
请求每来一次,GPU就从头算一次。
GPU利用率很高。
Prefill吞吐很高。
算力账单也很高。
但其中相当一部分工作,本来可以只做一次。
KV Cache复用改变的,就是这个问题。
它把推理系统从:
每个请求都从零开始变成:
已经算过的公共前缀继续使用
只为真正新增的Token付费
这不仅降低TTFT。
还减少排队。
释放GPU。
节省显存。
降低跨GPUPrefill通信。
提高完成QPM与有效TPM。
但复用率也不能被神化。
命中在哪里,决定取回成本。
命中多少Token,决定节省规模。
Router把请求送到哪里,决定缓存能否真正被使用。
远程KV是否跨机架,决定网络会不会把复用收益重新吃掉。
缓存是否频繁淘汰,决定命中率能不能持续。
所以,生产系统真正应该追求的,不是一个漂亮的“90% Hit Rate”。
而是:
高Token复用率
+
高本地命中比例
+
低KV取回时延
+
低缓存抖动
+
更低TTFT
+
更高SLO内有效吞吐
KV Cache复用率之所以是核心指标,是因为它直接回答了一个最关键的问题:你的GPU究竟在计算新知识,还是在重复昨天已经做过的工作。
当推理进入长上下文、RAG、Agent、P/D分离和分布式KV时代,决定系统效率的,不再只是GPU能算多快。
还包括:
- 算过的结果,能不能留下。
- 留下的结果,能不能找到。
- 找到的结果,能不能就近、及时地交给下一次请求。
未来推理系统的竞争,不只是“谁算得更快”,更是“谁更少重复计算”。
👉 AI 训练网络全路径拆解 → 私信:AI网络
👉 AI 推理网络全路径拆解 → 私信:推理
👉 AI 算力网络架构系统(真机实验环境) → 私信:系统
👉AI 算力网络架构专家(真机实验环境)→ 私信:专家
👉AI 网络架构工程指南手册→ 私信:工程指南**
👉 日常工作1对1答疑 → 私信:答疑
如果你也在做 AI 集群架构 欢迎关注「算力网络架构手记」 长期拆解真实算力网络问题
本文转载自微信公众号「疯狂的兔子tommy」,仅供学习交流使用。
觉得内容不错?我要