
Ollama 是如何工作的?
本文来源: AI灰鲸(公众号:AI灰鲸)
原文链接: https://mp.weixin.qq.com/s/JkXJROtRgXX4DzVBjD4kHw
发布时间: 2026-10-19 07:01
作者: AI灰鲸 发布时间: 2026-10-19 07:01
Ollama 是一款免费工具,只需一条简单命令,就能在自己的电脑上下载并运行大语言模型。它会在后台启动一个轻量服务,下载压缩后的模型文件,将其加载到内存,再通过高效的推理引擎,根据输入的提示词生成文本。
本文将介绍 Ollama 的工作原理:模型文件为什么要先缩小才能放进笔记本电脑,客户端与服务端如何通信,执行一条命令后会依次发生什么,模型怎样下载、存储并加载到 CPU 和 GPU,Modelfile 有什么用,其他应用如何通过 API 调用 Ollama,以及它适合和不适合哪些场景。
01本地运行大语言模型意味着什么?
了解 Ollama 之前,先弄清楚“在本地运行大语言模型”的含义。
大语言模型(LLM,Large Language Model)会读取提示词,再一点一点地生成回复。这些小块文本称为词元(token),一个词元通常是一个单词,或一个单词的一部分。
在网站上使用大语言模型时,模型通常并不运行在自己的电脑上。消息通过互联网发送到服务商的大型计算机,模型在那里完成计算,再把回复传回来。
本地运行则意味着:模型就在自己的电脑上执行,消息也留在本机。
可以拿吃饭打个比方。使用在线大模型像去餐厅点餐,本地运行则像在家做饭。自己做饭需要准备厨房和食材,但整个过程由自己掌控,别人看不到吃了什么,即使餐厅关门也照样能开火。
因此,本地运行带来的好处包括:
- 隐私:数据留在自己的电脑上。
- 离线使用:模型下载完成后,无需联网也能运行。
- 没有按次调用费用:不必为每条请求付费。
- 自主控制:自行选择运行哪个模型,以及怎样运行。
不过,过去在本地运行大模型并不轻松:需要找到合适的模型文件、安装各种库、配置 GPU,还要编写代码。Ollama 正是为简化这些工作而来。
02Ollama 是什么?
Ollama 是一款开源工具,让下载、运行和管理本地大语言模型变得更简单。
可以把它理解为模型的“应用商店”:只需指定想用的模型,Ollama 就会负责下载、配置和运行。
安装 Ollama 后,只需一条命令,就能开始与模型对话:
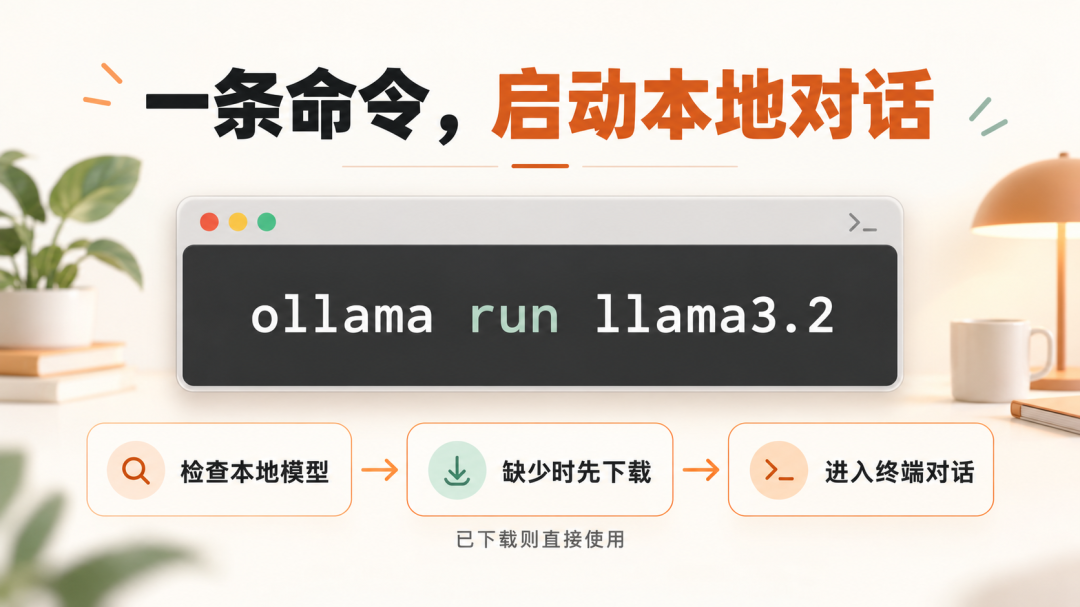
其中,ollama run 表示运行一个模型,llama3.2 是模型名称。如果本机还没有这个模型,Ollama 会先下载它,然后直接在终端中开启对话。
Ollama 支持 macOS、Windows 和 Linux。下面看看,这条简单命令背后发生了什么。
03首要难题:模型太大了
大语言模型由数十亿个称为“权重”的数字组成。这些权重承载了模型在训练过程中学到的内容。
通常,每个权重用 16 位存储,也就是 2 字节。
以一个包含 80 亿个权重的模型为例:
80 亿个权重 × 2 字节 = 16 GB
仅仅存放权重,这样一个中等规模的模型就需要 16 GB。许多笔记本电脑总共只有 8 GB 或 16 GB 内存,而操作系统和其他应用也要占用其中一部分。
此外,每生成一个词元,计算机都需要读取这些权重。因此,需要读取的数据越多,生成回复就越慢。
怎样才能把模型放进普通笔记本电脑?办法是让存储这些数字所需的空间变小。
04量化与 GGUF 文件格式
量化(Quantization)就是用更少的位数存储每个权重,例如用 4 位代替 16 位。
这有点像对价格取整:把 49.97 写成 50。虽然损失了一点细节,数字的表示却更简短了。
仍以这个 80 亿权重的模型为例,再算一次:
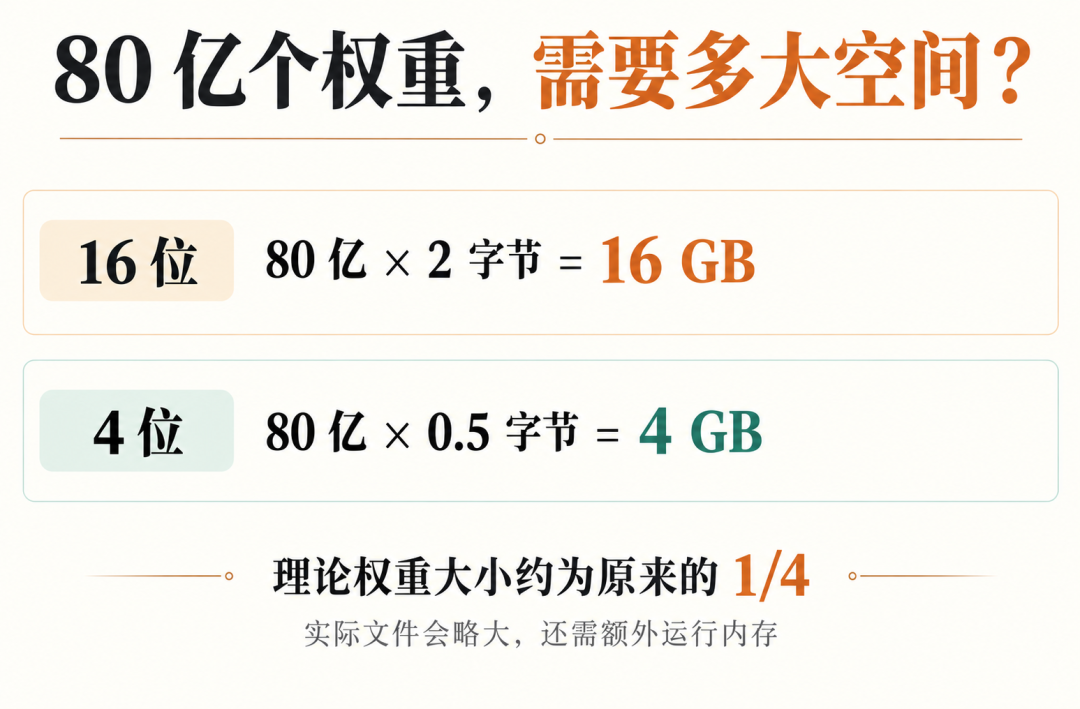
4 位版本的权重大小约为原来的四分之一,更容易装进笔记本电脑。每生成一个词元时需要读取的数据也更少,因此运行速度会更快,代价是回答质量会有少量下降。
Ollama 默认下载的许多模型,已经量化到约 4 位。
这些缩小后的模型可以保存在 GGUF 格式的文件中。GGUF 用于存储由 GGML 运行的模型;GGML 是一个帮助大语言模型高效运行的库。一个 GGUF 文件会把模型所需的多种内容封装在一起:
- 量化后的权重。
- 模型架构信息,例如模型有多少层。
- 分词器(tokenizer),负责把文本拆成词元,并把词元转换回文本。
GGUF 出自 llama.cpp 项目。llama.cpp 是一个用 C 和 C++ 编写的开源程序,能够在普通计算机上高效运行大语言模型,也支持没有强大 GPU 的设备。Ollama 构建在 llama.cpp 及其底层 GGML 库之上;较新的版本还为部分模型提供了同样基于 GGML 的自有引擎。
模型运行时繁重的数学计算,由这些引擎完成。运行训练好的模型并生成答案的程序,称为推理引擎(inference engine)。Ollama 则在上层处理模型管理、加载和调用等工作。
05整体架构:客户端与服务端
接下来看看 Ollama 的组成。
Ollama 主要分成两部分:
- 服务端:在后台运行,负责管理模型、将模型加载到内存并执行推理。可以用
ollama serve启动;使用桌面应用时,应用会自动启动服务。 - 客户端:向服务端发送请求。终端里执行的
ollama命令就是客户端,其他应用也可以充当客户端。
两者通过 HTTP 通信。服务端默认监听 http://localhost:11434。其中,localhost 表示“本机”,11434 是端口号,可以把它想成服务端等待请求的一扇门的门牌号。
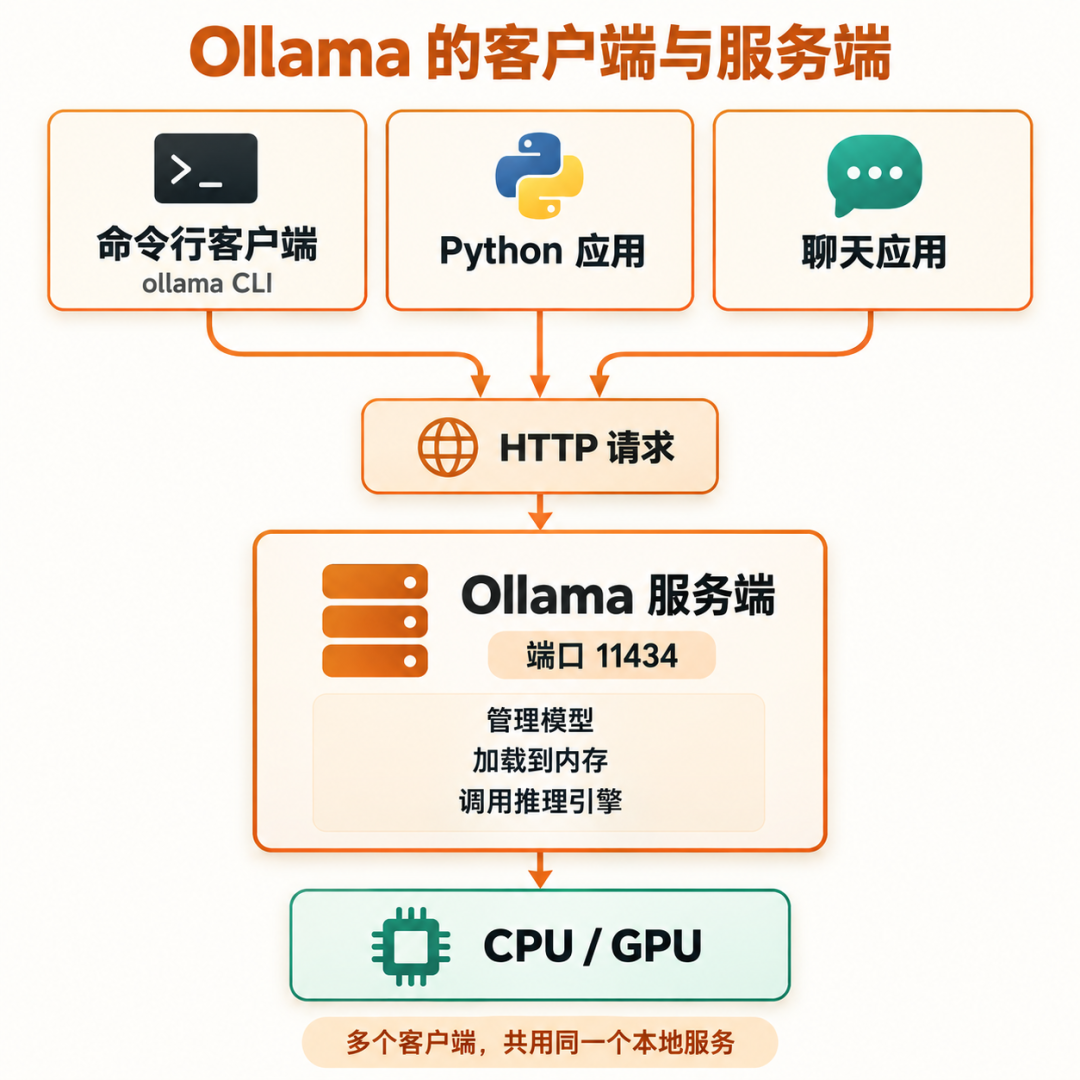
不同的客户端可以共用同一个 Ollama 服务端。模型统一存放、统一管理,本机上的多个应用都能调用。
06运行模型时,会依次发生什么?
以执行 ollama run llama3.2,然后提出一个问题为例,整个过程可以分成八步。
第 1 步:客户端联系服务端。ollama 命令向 localhost:11434 上的服务端发送请求。
第 2 步:检查磁盘上是否已有模型。如果没有,就从互联网上的 Ollama 模型库下载。下一节会展开介绍下载机制。
第 3 步:把模型加载到内存。服务端读取 GGUF 文件,将权重放入 GPU 显存、系统内存,或者同时分布在两者中。这可能需要几秒钟。
第 4 步:准备提示词。不同模型要求的对话格式不同,需要用特定标记区分系统指令、用户消息和助手回复的起始位置。这种格式称为聊天模板(chat template)。Ollama 会自动使用适合当前模型的模板包装消息。
第 5 步:将提示词转换为词元。分词器把文本拆成词元,再将每个词元映射为数字。
第 6 步:生成回复。推理引擎运行模型,预测下一个词元,将它追加到文本中,然后重复这个过程,直到回复完成。
第 7 步:流式返回结果。新词元一生成,就会发送给客户端。因此,屏幕上的文字会逐步出现,而不必等整段回复全部生成后再显示。
第 8 步:让模型在内存中保留一段时间。回复结束后,模型不会马上卸载。默认情况下,Ollama 会继续保留模型 5 分钟。在此期间再次提问,就能跳过第 3 步,省去重新加载的等待。如果 5 分钟内没有新请求,模型会被卸载,以释放内存。这个时间可以通过 keep_alive 设置调整。
一条简单命令,就这样变成了一次完整的本地大模型对话。
07模型如何下载和存储?
下面进一步看看第 2 步的工作方式。
Ollama 提供在线模型库。每个模型都有名称和标签,例如 llama3.2:3b、qwen2.5:7b。标签通常表示模型规模或版本;如果没有指定标签,Ollama 会使用默认的 latest。
也可以只下载模型,暂时不运行:
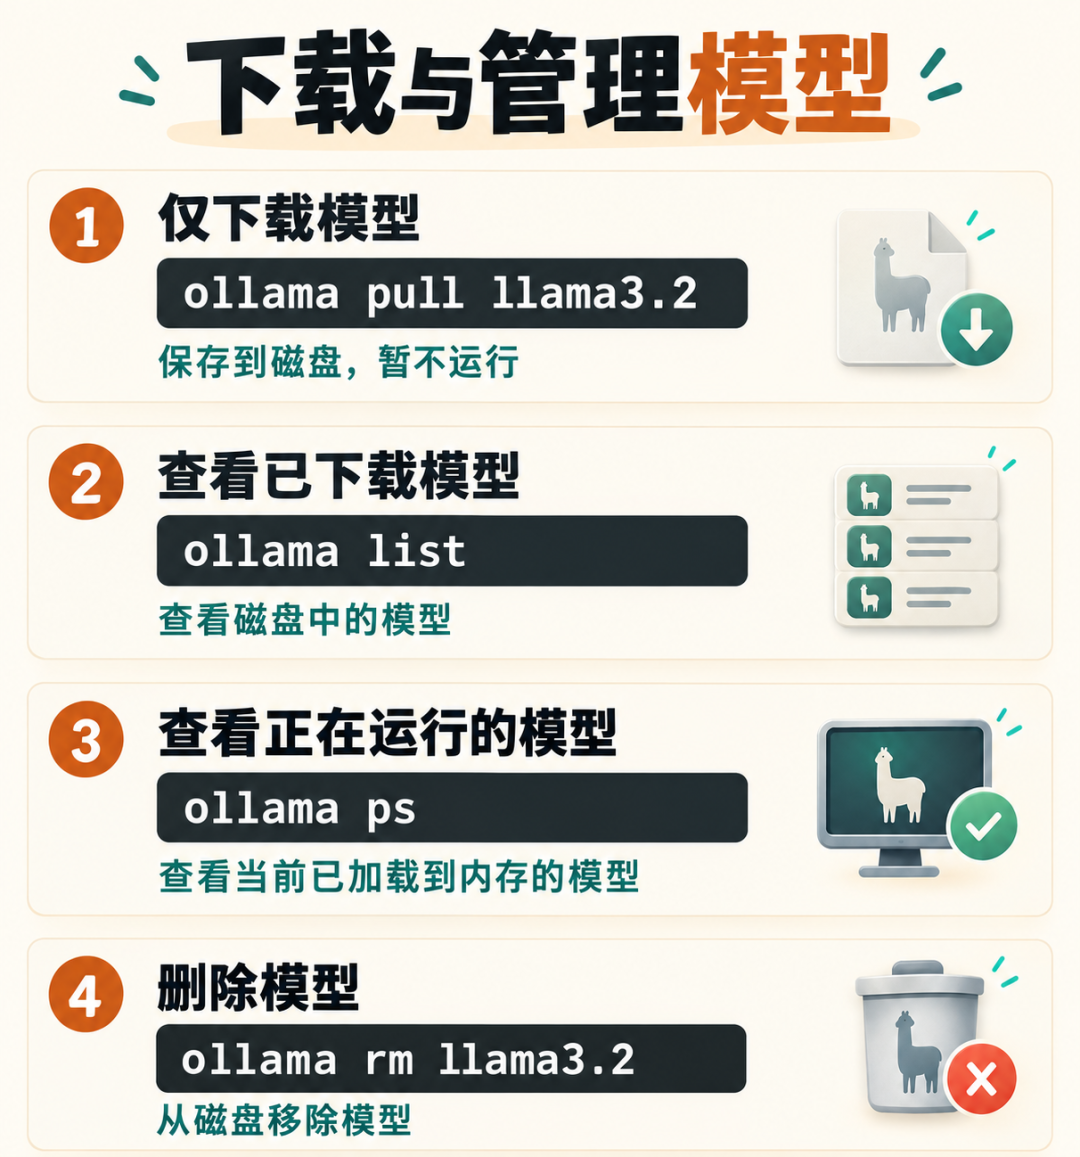
pull 会把模型下载并保存到本机,方便之后使用。
在 Ollama 中,一个模型并不是简单地存成一个带名称的独立文件,而是由若干个称为“层(layer)”的部分组成。其中一个较大的层是 GGUF 权重文件,其他较小的层存放聊天模板、默认设置和许可证等内容。
此外,还有一个较小的清单文件(manifest),列出构成该模型的各个层。
每一层的存储名称来自其内容的哈希值(hash)。哈希值可以理解为根据文件内容计算出的指纹;相同内容会产生相同的指纹。
这样做有什么用?假设为同一个基础模型创建两个定制版本,只是系统指令不同,两者就可以使用完全相同的权重文件。由于权重层的哈希值相同,Ollama 只需保存一份权重,单独存储那些有差异的小文件即可,从而节省大量磁盘空间。
例如,在 Mac 上,这些文件默认保存在用户主目录下的 .ollama/models 文件夹中,也就是 ~/.ollama/models。
日常管理模型,只需要几条简单命令:
查看已下载模型:ollama list。
查看当前已加载的模型:ollama ps。
从磁盘删除模型:ollama rm llama3.2。
list 查看磁盘中已有的模型,ps 查看当前已加载到内存的模型,rm 则用于移除不再需要的模型。
08模型如何在 CPU 和 GPU 上运行?
接下来的问题是:实际的计算发生在哪里?
模型可以在 CPU 上运行,也可以在 GPU 上运行。GPU 擅长同时执行大量计算,而大语言模型正需要这类计算能力,因此使用 GPU 通常能显著加速。
Ollama 启动时会检测电脑上的 GPU。它支持 NVIDIA GPU、许多 AMD GPU,以及 Mac 上的 Apple Silicon 芯片。Apple Silicon 的 CPU 和 GPU 共享同一套内存,这对运行大语言模型很有帮助。
大语言模型由多个依次堆叠的层构成。这里的“层”指模型计算的一个阶段,与前面讨论的存储层不同。输入会依次经过第一层、第二层,一直传递到最后一层。
Ollama 会判断 GPU 显存中能放下多少个模型层:
- 整个模型都放得下:所有层都交给 GPU 运行,速度最快。
- 只能放下一部分:部分层放到 GPU,其余层保留在系统内存中,由 CPU 运行。这称为部分卸载(partial offloading)。
- 没有可用 GPU:全部由 CPU 运行。
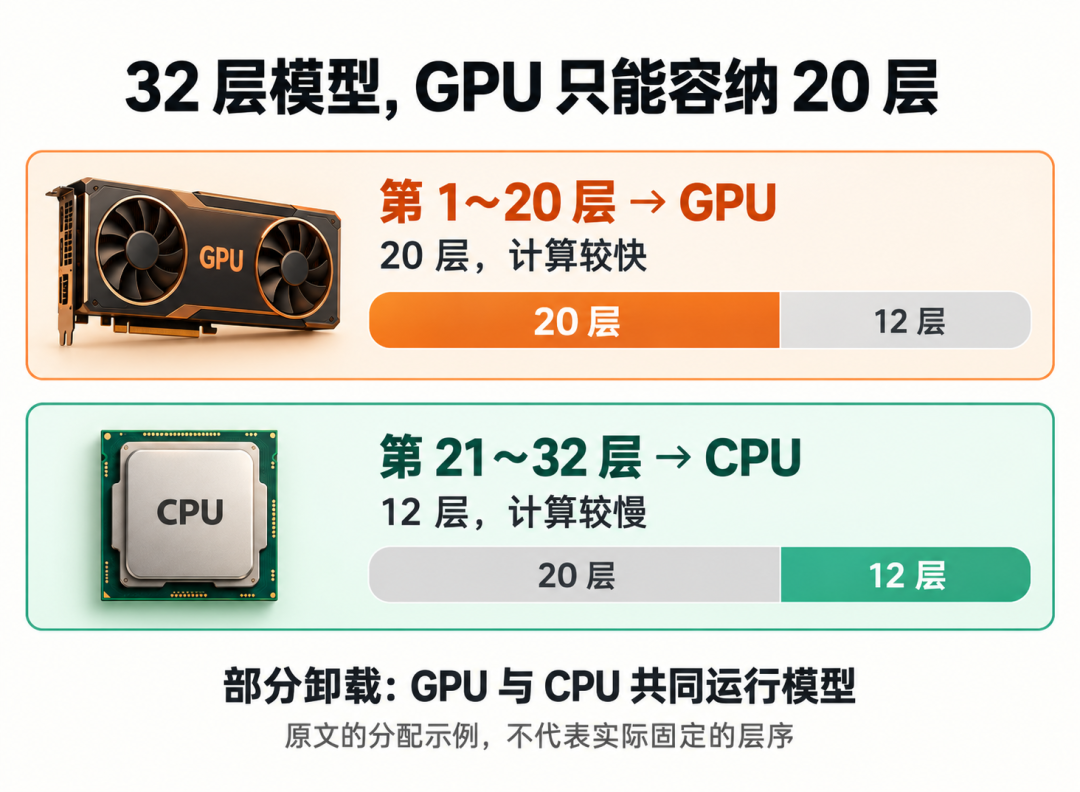
Ollama 会自动利用可用硬件,无需手动分配每一层。运行 ollama ps,可以查看已加载模型在 GPU 和 CPU 上的分配情况。
需要注意,内存不只用于存储权重,还要容纳对话过程中的缓存。随着模型读取更多文本,它会保存此前词元计算得到的信息,这就是 KV 缓存(KV cache)。对话越长,通常需要的内存越多。模型一次能看到的文本上限称为上下文长度(context length);上下文越长,内存占用也越大。
09Modelfile 是什么?
假设想定制一个模型,让它始终像一位友善的老师那样回答问题,并减少回答中的随机性。
Ollama 可以通过 Modelfile 实现这种定制。Modelfile 是一个小型文本文件,用来描述如何基于已有模型构建定制模型。
它就像一份配方,说明从哪个模型开始,以及需要改动哪些设置。
下面是一份 Modelfile 示例:
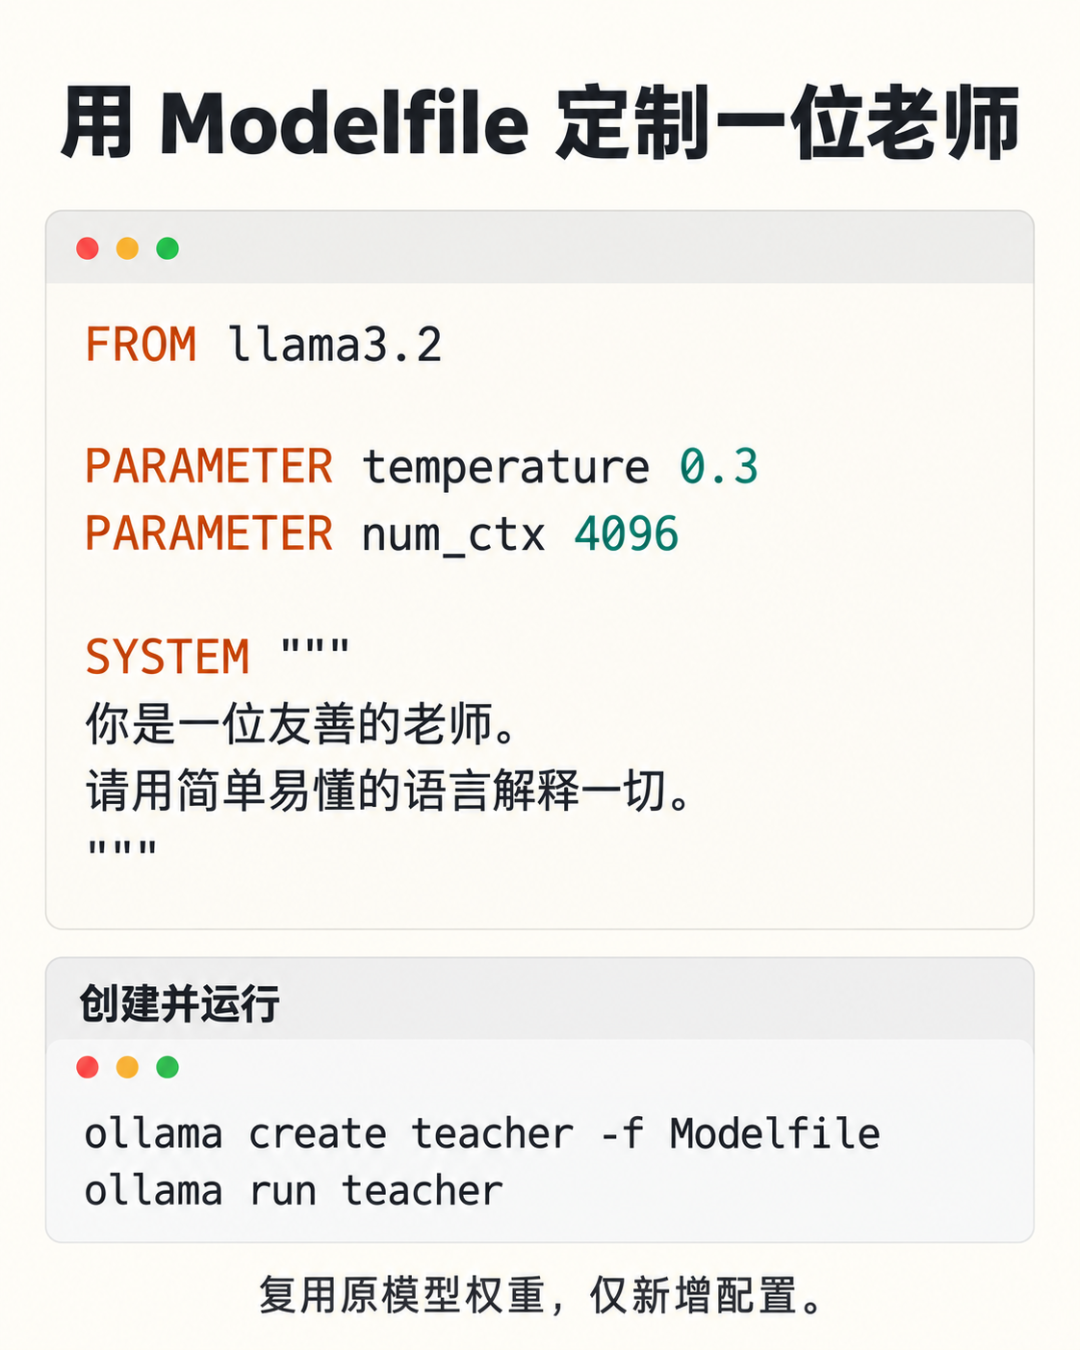
其中:
FROM llama3.2:指定作为起点的基础模型。PARAMETER temperature 0.3:将温度设为 0.3。温度控制随机性,数值较低时,回答通常更集中,也更可预测。PARAMETER num_ctx 4096:将上下文长度设为 4096 个词元。SYSTEM:设置系统消息,也就是每次对话前向模型提供的指令。
保存文件后,可以创建并运行这个定制模型:
创建:ollama create teacher -f Modelfile。
运行:ollama run teacher。
create 根据这份配方创建名为 teacher 的模型,run 则启动与它的对话。
这里不会重新复制一份权重。teacher 和 llama3.2 指向相同的权重层,新增的只有体积很小的配置层。这正是前面介绍的层共享机制。
10通过 API 在代码中调用 Ollama
前面的例子都从终端使用 Ollama。由于服务端采用 HTTP 通信,其他程序同样可以通过 API 调用它。
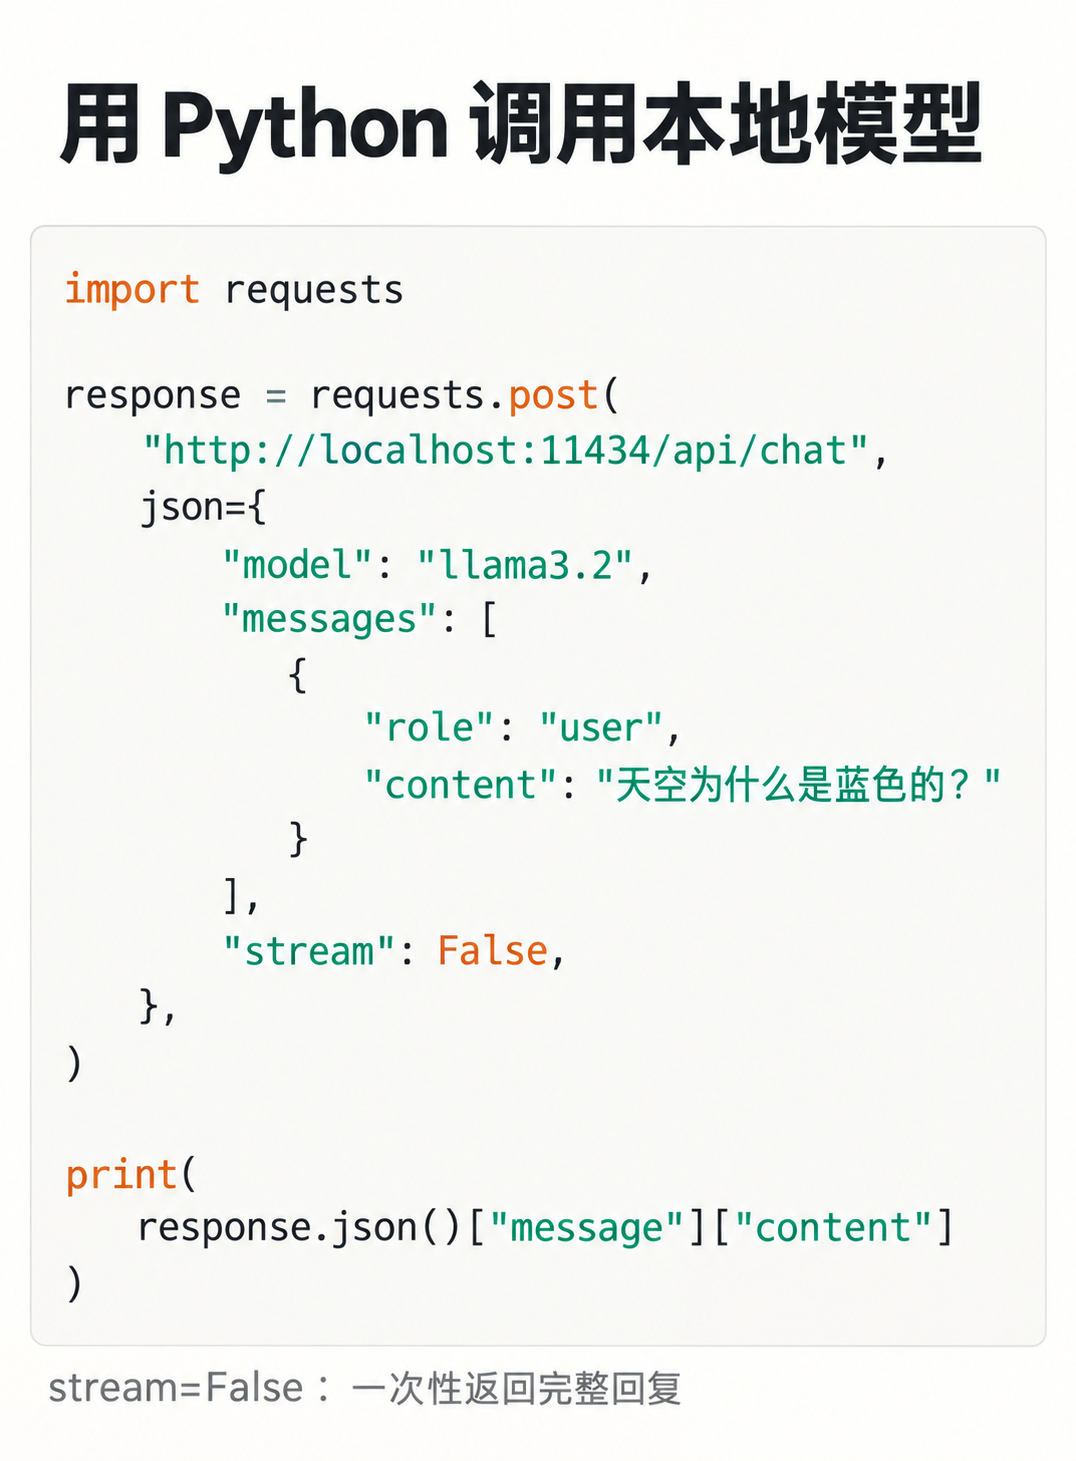
下面用 Python 发送一条聊天请求:
Python requests.post 调用 http://localhost:11434/api/chat,模型为 llama3.2,messages 包含 user 消息,stream=False,打印 response.json()["message"。](https://ilearnai.online/usr/uploads/2026/11/image_6_4.png)
这段代码完成了以下几件事:
- 向本地 Ollama 服务端的
/api/chat接口发送请求。 - 用
model指定要调用的模型。 - 用
messages传入对话。每条消息都包含角色role,例如user或assistant,以及消息正文content。 - 把
stream设为False,表示一次性获取完整回复。默认情况下,Ollama 会像终端对话那样,以流式方式逐步返回内容。 - 最后,从响应中取出回复文本并打印。
运行后,程序会输出模型对“天空为什么是蓝色的?”这个问题的回答。
Ollama 还提供与 OpenAI API 请求格式兼容的接口,基础地址为 http://localhost:11434/v1。许多原本为 OpenAI API 编写的应用和库,可以通过修改请求地址来接入本地 Ollama 模型。
11适用场景与局限
下面把云端大模型服务与本地 Ollama 放在一起对照。
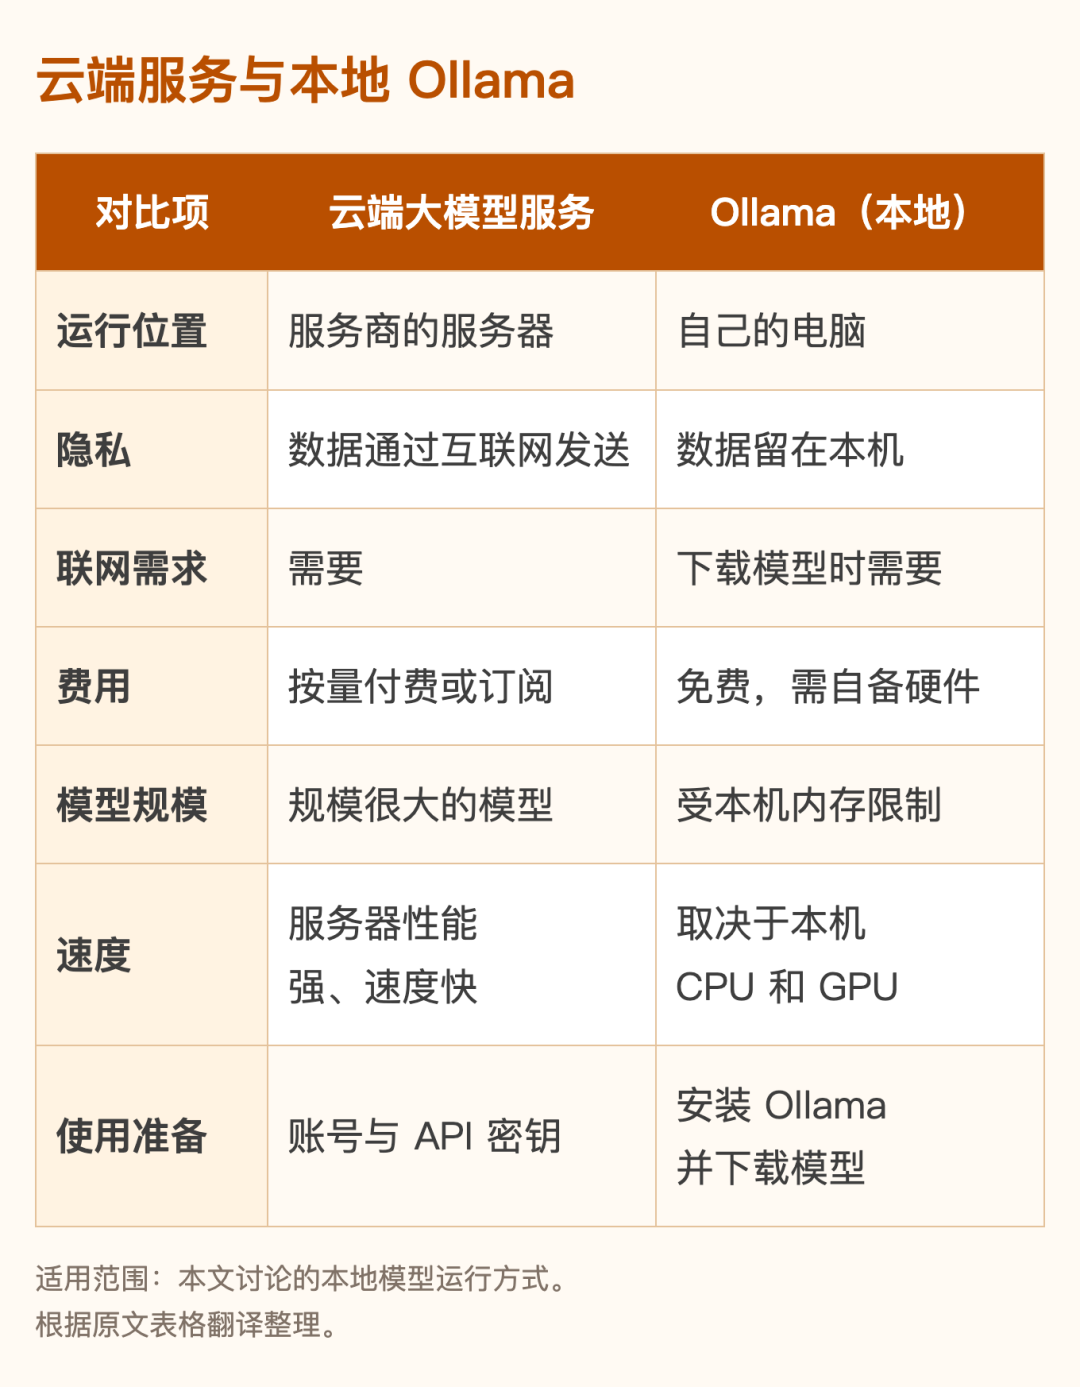
Ollama 很适合以下情况:
- 希望保护隐私,例如处理个人笔记或公司文档。
- 希望构建和测试应用,又不想为每次请求付费。
- 需要离线工作。
- 希望快速尝试多个开放模型。
它也有不擅长的场景:
- 需要规模最大、能力最强的模型。这些模型通常超出了个人电脑的承载能力。
- 电脑内存较少,或缺少性能较好的 GPU,生成回复会比较慢。
- 需要同时服务大量用户。Ollama 主要面向单机上的个人或小团队;面对高并发服务,vLLM 这类为高流量推理设计的工具通常更合适。
对大多数个人电脑来说,较小的模型往往是更合适的选择。
至此,Ollama 的工作原理就清楚了。
12常见问题
Ollama 可以免费使用吗?
可以。Ollama 免费且开源。向本地模型发送请求不需要按次付费,但需要自备硬件,因为模型运行在自己的电脑上,而不是服务商的服务器上。
Ollama 需要联网吗?
对于本文讨论的本地运行场景,下载模型时需要联网。模型下载到本机后,就可以离线使用,提示词和回复都留在自己的电脑上。
没有 GPU,也能运行 Ollama 吗?
可以。如果没有可用 GPU,整个模型都会在 CPU 上运行,只是生成回复通常更慢。有可用 GPU 时,Ollama 会尽量把模型层放到 GPU,剩余部分由 CPU 处理。
为 OpenAI API 开发的应用能使用 Ollama 吗?
可以。Ollama 在 http://localhost:11434/v1 提供兼容接口,许多为 OpenAI API 开发的应用和库可以通过修改请求地址,使用本地 Ollama 模型。
为什么第一次回复比后续更慢?
第一次请求需要先把模型从磁盘加载到内存,这可能花上几秒钟。之后,Ollama 默认继续保留模型 5 分钟,因此接下来的问题可以跳过加载步骤,更快开始生成回复。这个保留时长可以用 keep_alive 调整。
本文转载自微信公众号「AI灰鲸」,仅供学习交流使用。
觉得内容不错?我要