
AMD 锐龙 AI MAX+ 395 实测:Qwen3.8-Flash-Next极速版本地部署(47)
本文来源: 虾搞代码(公众号:虾搞代码)
原文链接: https://mp.weixin.qq.com/s/yDsoJNjDIxtgCluPDtQrIA
发布时间: 2026-11-04 00:00
作者: 虾搞代码 发布时间: 2026-11-04 00:00
Qwenox是Qwen3.8-Flash-Next(qwen4_exp架构)的本地推理引擎,为 AMD Strix Halo (Ryzen AI Max+ 395,gfx1151)这类 128 GB 统一内存的 APU 编写,Linux 和 Windows 都能运行。 对外提供 OpenAI 兼容 API 和 Anthropic Messages API(流式输出、工具调用、图片输入)以及网页控制台。
几个关键做法:
1、权重放得下:路由专家 4-bit,GPU kernel 直接读;PLE n-gram 表(27–48 GiB)留在磁盘按需读取, 不占内存。
2、投机解码:ngram 起草优先,MTP 草稿头兜底。
3、不重复 prefill:分页 KV 页池加两级 prompt 缓存(消息边界的内存检查点、可跨重启恢复的 SSD 快照), 编辑重发、多轮续写、切换对话都直接复用已算过的部分。
经大佬网友推荐,终于抽出时间了解了下halogen-flash-server,发现halogen-flash-server是专为在 AMD Strix Halo (gfx1151) 上运行 Qwen3.8-Flash-Next 而打造的专用本地推理引擎;decode速度喜人可以达到45+t/s以上(普通的llama.cpp正常也就20+t/s以上),但是遗憾都是halogen-flash-server只能在linux下运行(windows和wsl都不行)。最终经过一段时间的折腾终于找到了windows下的替代版本:Qwenox,在BIOS中显存设置为96GB。哈哈哈哈哈真是开心了好几天。
本文将重点介绍Qwenox的安装部署和使用过程;
第一步:下载程序和模型
Qwenox推理框架0.1.0:
https://github.com/IIIIIllllIIIIIlllll/Qwenox/releases
大模型下载地址:https://modelscope.cn/models/peonist-ai/halogen-qwen3.8-flash-next
| 说明 | 名称 | 大小 |
|---|---|---|
| 主模型 | qwen38-flash-next-v2.hgn | 66.69GB |
| ngram表 | qwen38-flash-next-ngram.hgn | 51.20GB |
| MTP草稿 | qwen38-flash-next-mtp.hgn | 1.52GB |
| 视觉 | qwen38-flash-next-vision.hgn | 897.92MB |
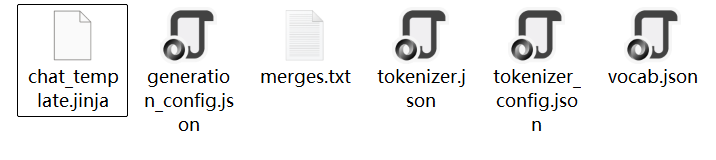
| tokenizer | 约10MB |
第二步:设置模型路径
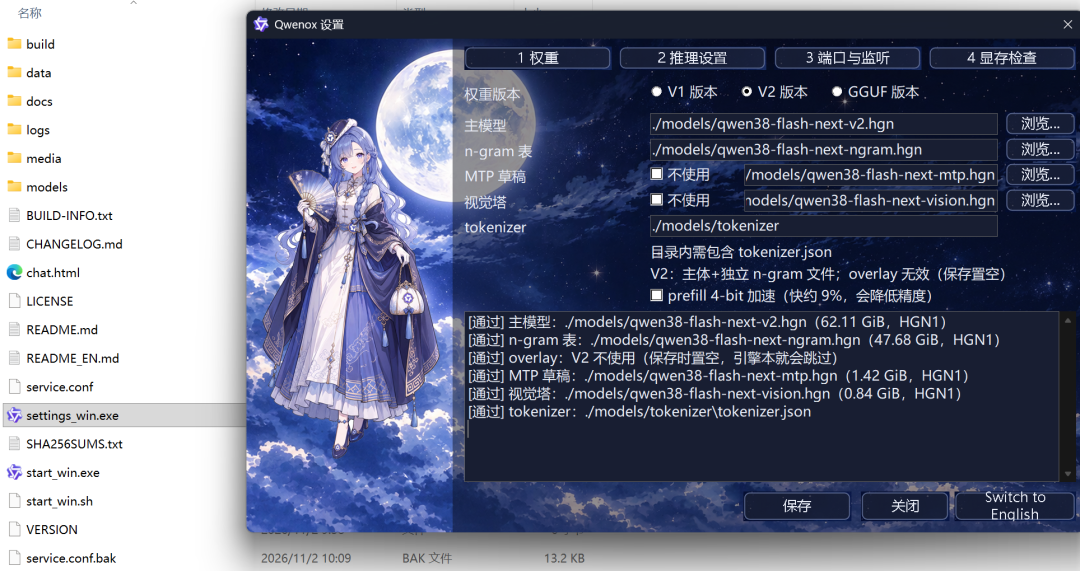
settings_win.exe模型路径设置:
进入“1 权重”选择V2 版本,填写主模型、ngram 表、MTP、视觉塔和 tokenizer 路径。只做文本问答可以不启用视觉塔。
点击“保存”,下方日志逐项显示“通过”即可。最容易出错的是 tokenizer:程序要找目录里的 tokenizer.json,不是随手改名的文本文件。
第三步:启动引擎和控制台
双击 start_win.exe。
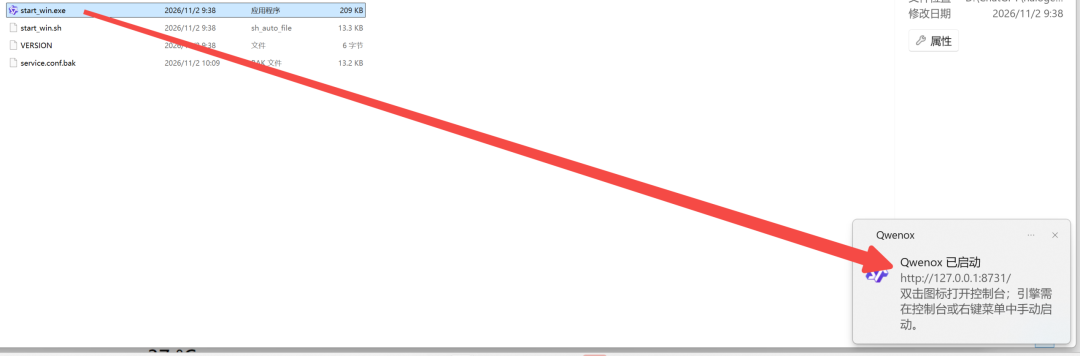
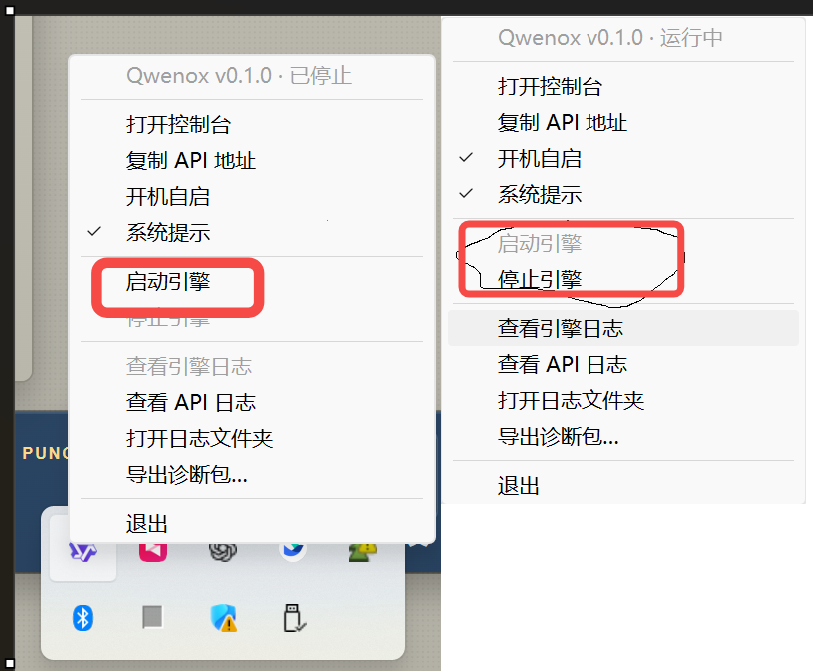
托盘出现 Qwenox 图标后,右键选择“启动引擎”。等待模型读入完成,菜单会变成“停止引擎”。(注意:这里需要手工启动引擎)
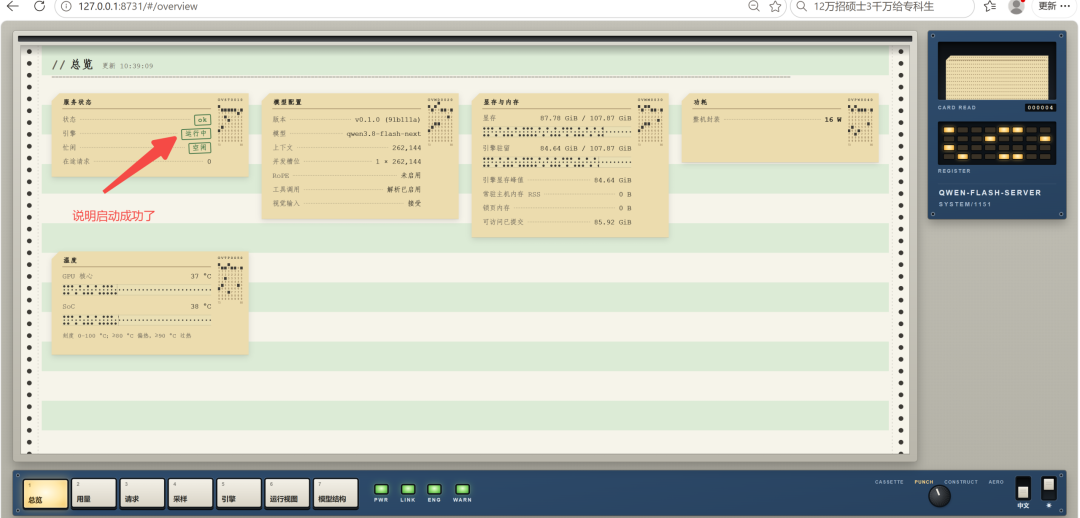
浏览器打开 http://127.0.0.1:8731/。总览页看到服务状态为 ok、引擎“运行中”,就算成功;控制台还能查看请求和日志。
api地址:http://127.0.0.1:8731/v1/chat/completions;OpenAI 客户端把 base_url 指向 http://127.0.0.1:8731/v1 即可。
第四步:用 PowerShell 发请求
由于没有聊天界面,只能手工命令行来测试下效果,以下是PS测试命令:
curl.exe http://127.0.0.1:8731/v1/chat/completions -H "Content-Type: application/json"
-d "{\"model\": \"qwen3.8-flash-next\", \"messages\": [{\"role\": \"user\", \"content\": \"你好!\"}]}"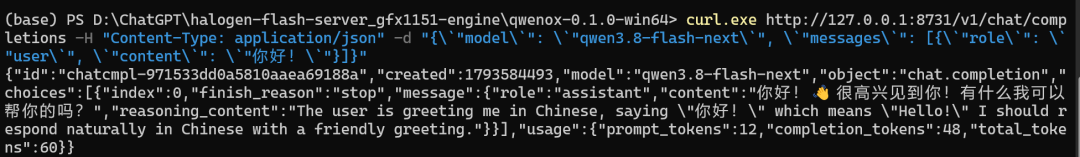
curl.exe http://127.0.0.1:8731/v1/chat/completions -H "Content-Type: application/json" -d "{\
"model\": \"qwen3.8-flash-next\", \
"messages\": [{\"role\": \
"user\", \"content\": \"你是谁呀!\"}]}"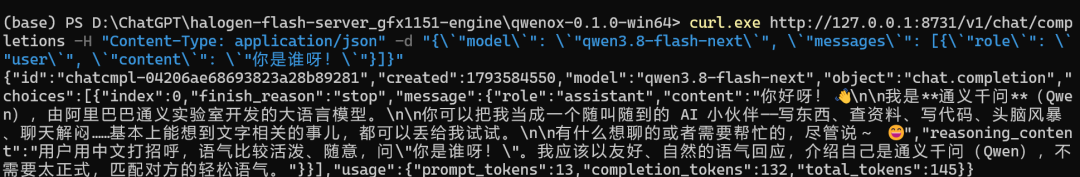
返回 JSON 里的 choices[0].message.content 就是回答。加入 stream:true 可逐段接收。速度和体验
截图中的 Windows 请求记录显示,开启投机解码后,简单对话的 decode 约47~58 tok/s,还能看到 prefill、接受率等指标。这个数字对应特定硬件和请求,不是所有提示词的保证;随机采样、长上下文和图片请求都会改变结果。
它还能复用上下文、接工具、收图片,适合接入代码助手、知识库或本地 Agent。
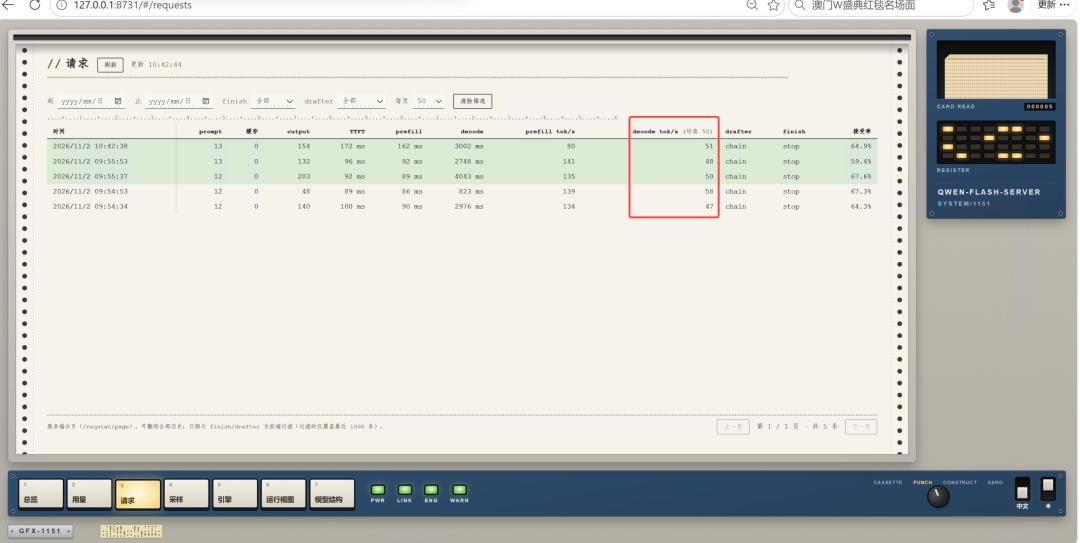
通过网页控制台可以看到简单的对话请求速度在45+t/s以上,通用版本的llama.cpp速度是没有这么快的。
Qwenox 把 125B 级 MoE、长上下文、投机解码和本地 API 组合成了一台 Windows 桌面服务。
如果你正好有 Strix Halo 和足够存储空间,按“下载 → 设置 → 启动 → 控制台确认 → curl 测试”走一遍,先让服务稳定出字,再折腾并发和 Agent。
本文转载自微信公众号「虾搞代码」,仅供学习交流使用。
觉得内容不错?我要