
本地推理省显存的两个关键:KV Cache量化与和前缀Cache复用
本文来源: 马尧(公众号:马尧)
原文链接: https://mp.weixin.qq.com/s/mBgtgq4bCmmz3aLAYKFFMQ
发布时间: 2026-11-17 12:35
作者: 马尧 发布时间: 2026-11-17 12:35
在 《在Mac上跑本地大模型,关注MLX、统一内存、量化三要素》 介绍了本地设备跑大模型最重要的三要素。
今天介绍两个显存使用优化技巧,毕竟现在内存价格这么贵。
1:模型上下文长度和KV Cache量化精度
模型的上下文长度决定了 K/V Cache 的显存占用,不同推理引擎会根据你设备的显存设置不一样的上下文长度,就算启动同一个模型,推理引擎默认上下文长度可能也不一样,比如说 Ollama 发现你的 Mac 统一内存如果小于 24GB,则上下文长度配置为 4k;如果统一内存处于 24~48 GB 之间,上下文长度则设置为 32K,高于 48GB 的时候上下文长度为 256k,其中建议智能体和工具至少使用 64,000 token。
此外 K/V Cache 的显存占用和模型架构有关,并不完全取决于模型参数量。比如一个稠密 8B 模型,fp16 精度,128K 上下文 K/V Cache 要 17.8GB 显存,可以说相当的惊人!
而 Qwen3.5 是一个混合 MoE 模型:只有 8 层需要 KV 缓存,也就是四分之一,如果使用 fp16 精度, 32K 上下文 K/V Cache 要 1GB 显存,256K 上下文 K/V Cache 要 8GB 显存,如果选择 q8_0 和 q4_0 量化精度,显存占用分别大概为 1/2 和 1/4。
总结下来,相比稠密模型,MoE 模型 K/V Cache 显存占用少得多。
那是不是 K/V Cache 尽量采用 q8_0 精度呢,目前并没有确切的说法,建议如果显存实在不够,K/V Cache 精度才考虑低精度,比如 q8_0。
下面是各种推理引擎设置 K/V Cache 精度的命令:
OLLAMA_CONTEXT_LENGTH=65536 OLLAMA_FLASH_ATTENTION=1 OLLAMA_KV_CACHE_TYPE=q8_0 ollama serve

llama-server -m model.gguf -c 65536 -fa on -ctk q8_0 -ctv q8_0

mlx_lm.generate --model <repo> --kv-bits 8 --prompt "..."
2: 前缀 K/V Cache 复用
如果你看我过去写的文章,Apple 官方测试M5 Ultra,相比 M3 Ultra, Prompt 预处理速度提升 4.3倍,而 token 生成速度也就提升 1.6 倍,为什么同样的机器,两个生成速度相差这么大呢?
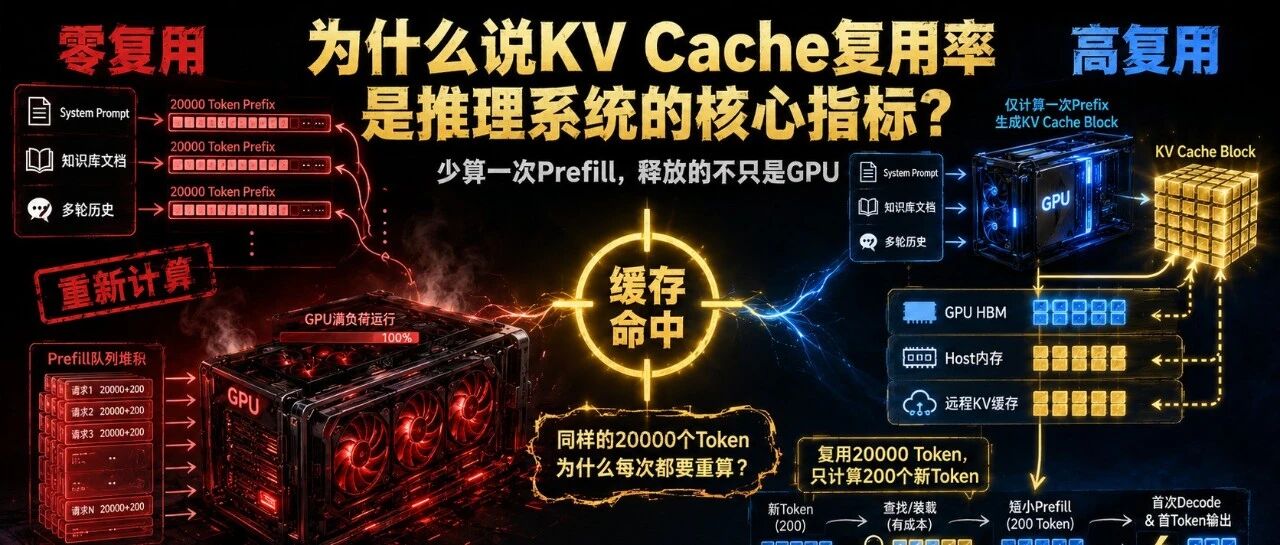
实际上 Prompt 预处理是计算密集型的,衡量GPU算力,而 token 生成速度主要看显存带宽,减少 GPU 计算最现实的优化算法就是 K/V Cache 优化,尤其是前缀 K/V Cache 复用。
现在智能体的工作方式很粗暴,一个会话中,每一次聊天就要发送完整会话,甚至一个会话中,不同子请求也要发送完整上下文(属于跨对话),如果反复进行注意力计算,则消耗极大的算力,所以前缀 K/V Cache 非常重要。
在本地设备推理的时候,和云端不一样的是,你重启电脑 K/V Cache就没了,下一次启动推理的时候,又要重新生成 K/V Cache,所以需要自己显示保存起来。
下面是 lama.cpp的做法:
llama-server -m model.gguf --cache-reuse 256设置前缀 K/V Cache 最小阀值,如果新旧前缀提示词至少有 256 个 token 相同时,允许复用前缀 K/V Cache,但没找到将 K/V Cache 保存下来的方法。
不过 mlx-lm 可以保存,如下:
mlx_lm.cache_prompt --model <repo> --prompt - --prompt-cache-file sys.safetensors < system.txt
mlx_lm.generate --model <repo> --prompt-cache-file sys.safetensors --prompt "..."
LM Studio 的 mlx-engine 1.8.5 加入了前缀 K/V Cache 复用功能,在 M3 Max 测试,采取四个并发请求,Qwen3.6-27B 4-bit 量化),由于有前缀 K/V Cache 复用,耗时从 37.60 秒缩短到了 16.78 秒。
如果你用云端模型,不用考虑前缀 K/V Cache 复用的问题,由模型提供者处理。但在本地推理可能需要好好琢磨了,虽然单个对话肯定会用上 K/V Cache,但跨请求、跨重启的前缀 K/V Cache 复用需要自己设置。
相关文章:
本文转载自微信公众号「马尧」,仅供学习交流使用。
觉得内容不错?我要