
LLM 推理优化技术:KV Cache、Paged Attention、Flash Attention、Grouped Query Attention、Speculative Decoding、Continuous Batching
本文来源: AI灰鲸(公众号:AI灰鲸)
原文链接: https://mp.weixin.qq.com/s/3hA2ESdkdcP_uSYJmdy9yQ
发布时间: 2026-11-16 12:30
作者: AI灰鲸 发布时间: 2026-11-16 12:30
一个模型能在显卡上跑起来,距离稳定服务大量用户还有一段距离。长提示词会推高首字等待时间,逐个生成 token 会反复读取模型权重,并发请求还会持续占用 KV Cache。KV Cache、PagedAttention、FlashAttention、GQA、投机解码和连续批处理,分别处理这条链路上的不同开销。把它们放在一次请求的完整生命周期中,才能看清哪些技术可以组合、哪些收益取决于负载,以及“更快”究竟指首字延迟、生成速度,还是整台服务器的吞吐量。
01从一次生成看清推理瓶颈
Prefill 与 Decode,做的是两种工作
自回归语言模型依据已有文本预测下一个 token,再把新 token 接到序列末尾,继续预测。token 是模型处理文本的基本单位,可能是一个字、一个词,也可能只是词的一部分。为便于说明,下面的英文例子暂把一个单词看作一个 token,真实分词结果未必如此。
给模型输入“I love”,它可能先生成“teaching”,再生成“AI”。后一次预测依赖前一次的结果,因此同一条回答的常规生成过程存在串行依赖。停止条件通常是结束标记、指定的停止条件或长度上限。
一次推理可以分成两个阶段。预填充(Prefill)处理已知的提示词,为各层建立缓存,并在最后一个提示词位置得到首个输出 token 的分布。提示词中的所有位置已经确定,可以用大块矩阵运算并行处理,因果掩码仍会阻止某个位置看见未来位置。实际系统也可能把很长的 Prefill 拆成多个块。
解码(Decode)从此后逐步推进。常规解码每轮给每条活跃序列增加一个 token。若首个输出 token 已在 Prefill 末尾产生,一条包含 200 个输出 token 的回答,通常还需要 199 轮后续解码;讨论简化调度模型时,也常把每次产出统称为一次生成迭代。
两阶段对硬件的压力并不相同。Prefill 有大量已知输入,往往更容易形成大矩阵乘法;低并发 Decode 每轮只处理很少的新位置,却仍要访问模型权重和历史 K/V,容易受显存带宽限制。上下文长度、批量大小、模型结构和硬件都会改变瓶颈,不能把所有推理都归为同一种负载。
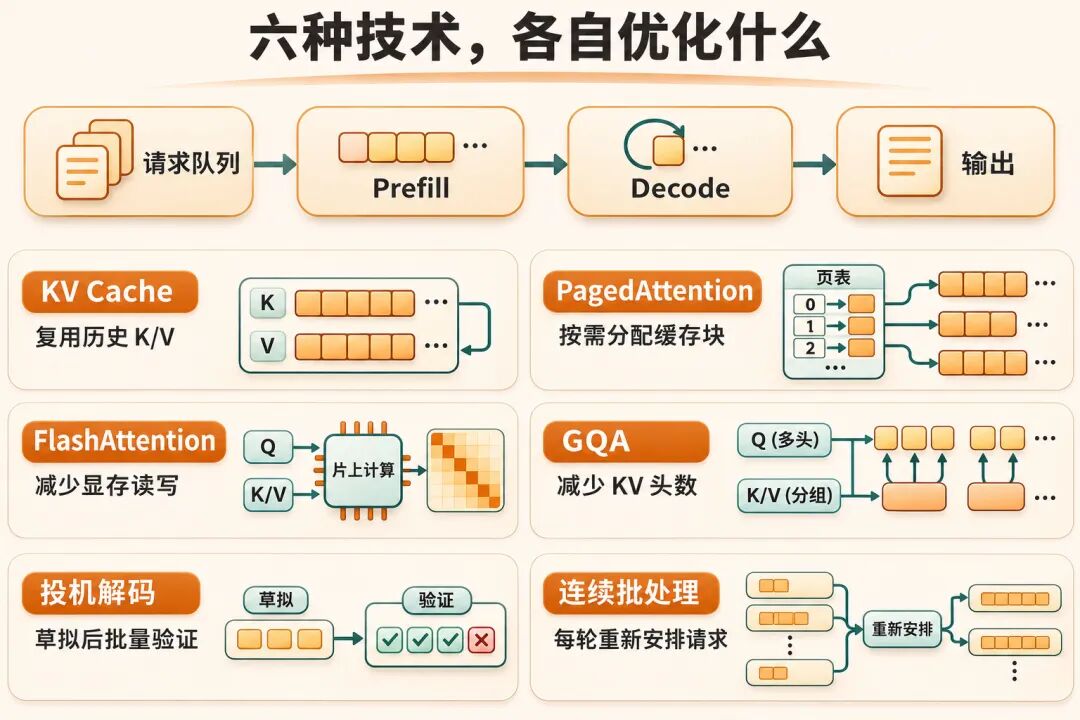
图 1|六种技术分布在缓存、计算和调度等不同层面,可以组合使用。本文技术图依据材料重新绘制。
先分清三种“快”
用户关心多久看到第一个字,以及后面的字是否顺畅;服务端还要考虑同一套硬件能接待多少请求。因此,至少要区分三个指标:
- 首 token 延迟(TTFT):从请求到达到首个 token 返回的时间,通常包含排队和 Prefill。
- token 间延迟(ITL):相邻输出 token 之间的时间间隔,反映流式输出是否顺畅。
- 吞吐量:单位时间内完成的请求数或产生的 token 数。比较时要说明统计输入还是输出 token,以及并发量和长度分布。
某项优化可能让服务器每秒生成更多 token,却使单个用户等得更久。讨论提速倍数时,必须把指标和负载放在一起。
Q、K、V 分别保存什么
注意力机制把某一层的输入表示投影成查询向量 Query(Q)、键向量 Key(K)和值向量 Value(V)。Q 表达当前位置需要寻找什么信息,K 用于计算匹配程度,V 提供被汇总的内容。可以把它们理解为检索问题、索引标签和实际资料。
对一个注意力头,常见的缩放点积注意力写作:
Attention(Q, K, V) = softmax(QKᵀ / √d + M)V
其中 d 是该头的维度,M 是掩码;因果注意力会遮住未来位置。softmax 把每行得分归一化,随后按这些权重汇总 V。Q、K、V 都是随层和位置变化的向量,不能把某个 token 的 K/V 理解为脱离上下文、永久固定的词典条目。
接下来的几种优化,大多围绕一个问题展开:这些向量应该算几次、存多少、放在哪里,以及什么时候交给 GPU 处理。
02KV Cache:复用已经算过的历史
重复计算从哪里来
如果采用不缓存的朴素实现,每次生成都把整个已有前缀重新送入模型,那么“I love”生成“teaching”后,下一轮处理“I love teaching”时,“I”和“love”的中间结果又会被计算一遍;再生成“AI”,更长的前缀还会被重新处理。
在因果模型的推理过程中,前面的位置看不到后来新增的 token。只要模型、前缀、位置等条件相同,旧位置各层的 K/V 就不需要因为序列末尾增长而重新计算。KV Cache 将这些 K/V 保存下来,供后续位置直接读取。
这类似于开会时保留已有记录:新发言者加入后,查阅记录即可,不必要求前面的每个人再发言一遍。
缓存如何接住 Prefill 和 Decode
以“I love”为提示词,处理过程可以连成三步:
- Prefill 处理“I”和“love”,计算各层 Q/K/V,并保存这两个位置的 K/V;模型据此预测“teaching”。
- 下一轮只输入新 token“teaching”。模型计算这个位置各层的 Q/K/V,将新 K/V 追加到缓存;新 Q 与允许访问的历史 K 计算注意力,再汇总对应 V,预测“AI”。
- 再下一轮输入“AI”,重复计算、追加和读取,继续预测后续 token。
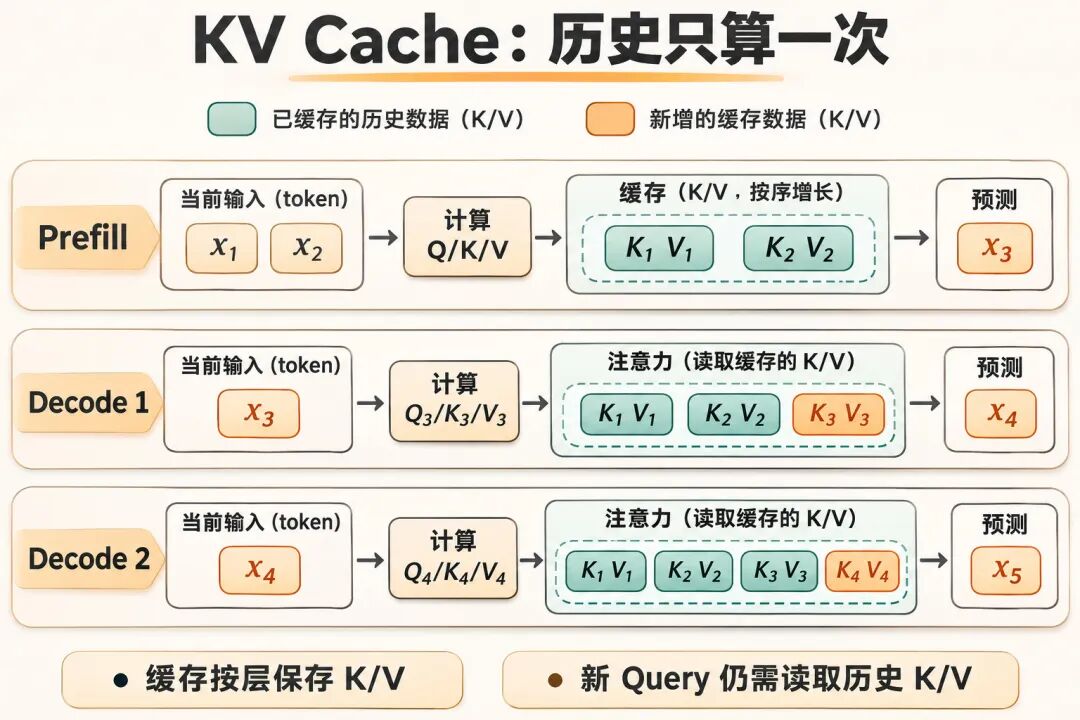
图 2|预测出的 token 在下一轮被模型处理时,才形成自己的 K/V。图中省略了层间传递和注意力后的其他网络计算。
缓存只保存 K 和 V,是因为未来位置需要用自己的 Q 查询历史 K,并汇总历史 V。旧 Q 已经完成了旧位置的信息查询,后面的生成不再需要它。缓存通常按 Transformer 层分别维护;一层的 K/V 不能直接替代另一层的 K/V。
节省了计算,但历史仍然要读
为了把计数说清楚,假设提示词有 2 个 token,要生成 100 个新 token。首个输出由长度为 2 的提示词得到,最后一个输出由长度为 101 的前缀得到。
不使用缓存时,各轮重新处理的 token 位置总数是 2 + 3 + … + 101 = 5,150;使用缓存时,则是首次处理 2 个位置,再逐轮处理 99 个新位置,共 101 个位置。按这个简化口径,K/V 投影涉及的位置数降到约五十一分之一。
这个倍数不等于端到端推理提速 51 倍。新位置仍要计算 Q/K/V,经过前馈网络等模块,并读取历史缓存。对完整因果注意力,序列越长,每一步需要访问的历史 K/V 越多;缓存消除了重复构建历史表示的开销,没有消除当前位置与历史之间的注意力运算。
用显存换取时间
KV Cache 的代价是额外显存。对于各层采用相同 KV 头配置、没有共享或压缩的模型,其有效缓存数据量可以粗略估为:
KV 字节数 ≈ 2 × 层数 L × KV 头数 Hkv × 头维度 d × 每元素字节数 b × ΣTᵢ
ΣTᵢ 是所有活跃序列已缓存的 token 数之和;系数 2 对应 K 和 V。这个公式估算的是有效数据,不含分页尾部空位、管理元数据和实现中的其他开销,多卡分片也会改变每张卡的实际占用。
上下文越长、并发序列越多、KV 头越多,缓存越大。这正是后面 PagedAttention 和 GQA 发挥作用的地方:一个减少分配浪费,一个减少需要保存的 KV 头数。
同一前缀的缓存还可以跨请求复用,例如许多请求都带着相同的系统提示词。复用条件需要包含完整前缀及其计算条件;只有某句话相同、但前面的聊天历史不同,不能据此认定其 K/V 相同。
对于持续增长的长对话,也存在保留最近窗口、结合开头的注意力汇聚点(attention sink)token 等方法,或对 KV 做低精度存储。这些方法可能改变可访问的信息或数值精度,需要与模型结构和质量评估配合。单纯开启 KV Cache,不会让长对话的显存占用自动保持恒定。
03PagedAttention:让缓存按需占用显存
为什么有空闲显存却接不了新请求
提示词长度已知,回答究竟会生成多长却往往未知。一个简单问题可能只需要 20 个 token,一次长篇生成也可能需要 2,000 个 token。朴素的连续预留方式会为每条序列提前划出一大段空间,以满足允许的最大长度。
如果只看待生成部分,为 2,048 个 token 预留了空间,最后只生成 50 个,就有 1,998 个位置没有用上。这是预留空间内部的浪费。另一类问题是外部碎片:显存里虽然有许多空隙,却拼不成新请求所需的连续区域。
可以把它想成一间存放长文件的仓库。如果每份文件都必须占据一排连续货架,还要先按最大长度预留,空货架会很难被其他文件使用。缓存管理需要一种更灵活的分配方式。
用块表连接逻辑顺序与物理位置
PagedAttention 借鉴操作系统分页的思路,将 KV Cache 划分为固定大小的块。每块容纳固定数量 token 的 K/V;一条序列用到多少,就逐块分配多少。这些物理块不必相邻。
请求看到的是有序的逻辑块,显存里存放的是分散的物理块,两者由块表(block table)映射。注意力实现根据块表找到所需数据,按序列语义完成计算。这既涉及缓存分配管理,也需要能读取这种布局的注意力内核。
假设每块能保存 4 个 token,一个简化序列最终保存 10 个 token:
- 连续预留 16 个位置,实际用掉 10 个,剩余 6 个位置闲置。
- 分页时分配 3 个块,共 12 个位置。前两块装满,最后一块使用 2 个位置、空出 2 个位置。
- 逻辑块 0、1、2 可以分别映射到物理块 5、12、3。序列顺序依旧是 0、1、2,物理地址不必按这个顺序连续排列。
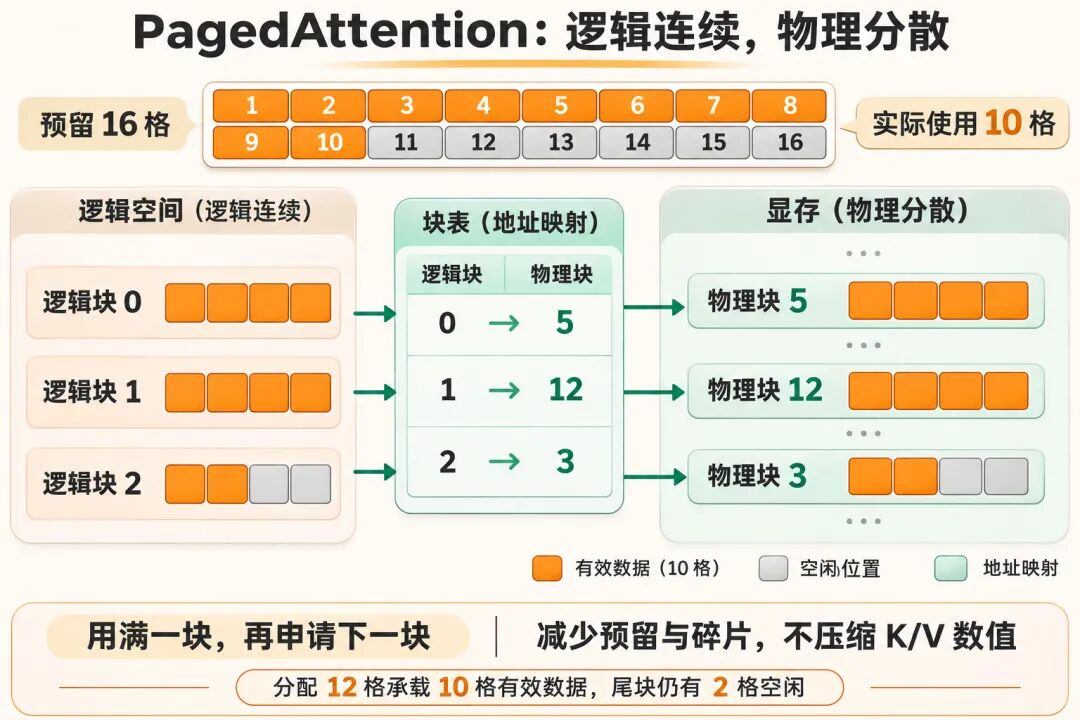
图 3|每块 4 个位置,保存 10 个 token 需要 3 块。分散存放不改变逻辑顺序,尾块仍可能有空位。
在 token 数为 T、每块容量为 B 的简单模型中,需要 ceil(T/B) 个块,尾部未使用位置少于 B。块太大,尾部浪费可能增加;块太小,块表和寻址管理的代价又可能上升。
分页消除了这一缓存块池中“必须凑出一段大连续空间”的要求,也大幅减少按最大长度预留的浪费。尾块空位、元数据和其他系统开销仍然存在,因此更准确的说法是接近零浪费,而不是整个 GPU 显存完全没有浪费。
同一段前缀,可以只保存一份
块表还为共享缓存提供了便利。如果多条序列具有相同前缀,且模型和其他计算条件兼容,它们的块表可以指向同一组已计算的物理块。
这适合对同一个提示词进行多路采样,也适合束搜索(beam search)中共享前缀的候选序列。公共部分只保存一份,后续分叉各自追加缓存;涉及共享块的修改时,可以采用写时复制,避免一条序列污染另一条序列。
跨请求的前缀匹配还需要缓存索引和复用策略,分页本身不会自动判断两个请求是否可以共享。SGLang 的 RadixAttention 使用基数树组织可复用前缀;vLLM 以 PagedAttention 为核心建立服务系统,TensorRT-LLM 也使用分页 KV 缓存。算法、缓存策略与完整服务引擎应当区分开来。
PagedAttention 不减少每个 token 必须保存的 K/V 数值量。它主要减少预留、碎片和重复副本造成的浪费,使同样的显存能够容纳更多有效缓存。若希望进一步缩小有效缓存本身,需要看 KV 头数、存储精度或保留范围。
04GQA:从模型结构上减少 KV 头数
MHA 的成本随头数增长
多头注意力(Multi-Head Attention,MHA)使用多个注意力头,每个头都有自己的 Q、K、V 投影。不同头可以形成不同的注意力模式;各头输出拼接后,再经过输出投影。
如果某层有 8 个头,序列包含 1,000 个 token,仅这一层就需要保存 8,000 个 K 向量和 8,000 个 V 向量,共 16,000 个向量。完整模型还要乘上层数和每个向量的维度。头数达到 64、上下文达到 100,000 个 token 时,这项成本会更加突出。
对于解码,还要反复从显存读取这些缓存。减少 KV 头数因此既能节省容量,也能减少相关带宽需求。
从一头一份,到按组共享
多查询注意力(Multi-Query Attention,MQA)保留多个独立的 Q 头,让所有 Q 头共享一组 K/V。以 8 个 Q 头为例,KV 从 8 组变成 1 组,在其他条件相同时,缓存变为 MHA 的八分之一。
共享会限制 K/V 表示的自由度,可能带来质量损失或训练适配问题。具体效果取决于模型和训练方式,不能只凭共享方式给所有模型排出固定的质量名次。
分组查询注意力(Grouped-Query Attention,GQA)在两者之间引入分组:每个 Q 头仍然独立,组内的多个 Q 头共享一组 K/V。例如,8 个 Q 头分成两组,Q1 至 Q4 共享第一组 K/V,Q5 至 Q8 共享第二组 K/V。
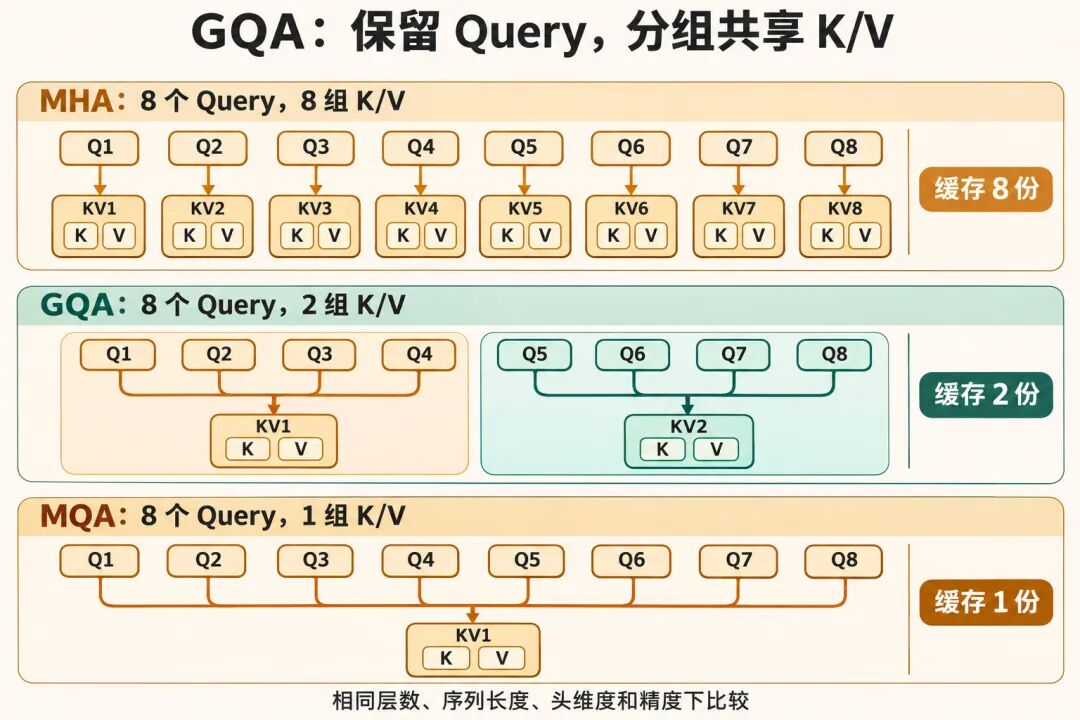
图 4|“一组 K/V”表示一套 KV 头对应的序列数据,并非用一个向量代替所有 token。相同比较条件下,示例 GQA 的缓存是 MHA 的四分之一。
这一设计的计算步骤很直接:先用各 Q 头的权重得到各自的查询,再用各组的权重计算共享 K/V;每个 Q 头与所属组的 K/V 做注意力运算,最后拼接所有 Q 头的输出并做输出投影。Query 不共享,因此同一组中的不同头仍可以给历史位置分配不同权重。
三种结构是同一条连续谱
记查询头数为 Hq,KV 头数为 Hkv。在常见的等规模分组配置中,每组有 Hq/Hkv 个查询头。
- MHA:Hkv = Hq。
每个查询头拥有一组 K/V,示例中保存 8 组,缓存占用最大,表示自由度最高。
- MQA:Hkv = 1。
所有查询头共享一组 K/V,示例中保存 1 组,缓存最小,但质量和训练适配需要评估。
- GQA:1 < Hkv < Hq。
示例中保存 2 组,在缓存占用与表示能力之间取折中。相关论文实验表明,合适的 GQA 配置能够接近 MHA 的质量,并获得接近 MQA 的解码效率。
相同层数、序列长度、头维度和精度下,GQA 相对 MHA 的 KV 数据量比例约为 Hkv/Hq。这个比例描述缓存大小,不能直接换算成整个模型的提速倍数或显存缩减倍数;模型权重、激活和其他运行时数据仍然占空间。
模型配置里,查询头数常写作 num_attention_heads,KV 头数常写作 num_key_value_heads。例如 32 个查询头、8 个 KV 头,对应 8 组,每组 4 个查询头。阅读配置时,不要把“8 个 KV 头”误读成“每组 8 个查询头”。
已有模型如何采用 GQA
GQA 通常属于模型架构的一部分,需要在训练时确定。它不等同于把任意 MHA 模型推理时的几个 KV 头直接删掉。
已有 MHA 检查点也可以通过继续训练转换。GQA 论文给出一种 uptraining 方法:把同组多个头的 K 投影权重求平均,V 投影权重也分别求平均,以此初始化共享 KV 头,再继续训练适配。在论文实验设置中,约使用原始预训练计算量的 5%,就能得到质量接近 MHA 的 GQA 模型。这是特定实验的结果,不是任意模型转换都适用的成本保证。
典型例子包括:Llama 2 的 70B 使用 64 个查询头、8 个 KV 头,理论 KV 数据量是对应 MHA 的八分之一;论文中的 34B 也采用 GQA,但当时没有公开发布其权重,7B 和 13B 则使用 MHA。Llama 3 的模型采用 GQA;最初的 Mistral 7B 使用 32 个查询头、8 个 KV 头,并结合滑动窗口注意力。
这些设计有利于长上下文、高并发和显存受限部署。GQA 减少需要保存的 KV 数据,PagedAttention 负责把这些数据更紧凑地安排到显存里,两者解决的是相邻但不同的问题。
05FlashAttention:减少中间结果的显存读写
注意力矩阵为什么昂贵
处理长度为 N 的输入时,标准完整注意力在每个头上形成 N×N 的得分关系。N 为 4,000 时有 1,600 万个元素;10,000 时有 1 亿个;100,000 时有 100 亿个。输入长度翻倍,矩阵元素数变成四倍。
朴素分步实现先计算得分矩阵 S,再计算概率矩阵 P,最后得到输出 O:S = QKᵀ/√d,P = softmax(S),O = PV。掩码按需要加入得分。
如果每一步都单独落到显存,S 要写一次、读一次,P 也要写一次、读一次。仅这两个 N×N 中间矩阵,就产生了四轮完整的数据搬运。大量时间可能消耗在读写中间结果上,而非矩阵乘法本身。
这里的 N×N 主要用于说明多位置计算,例如训练、Prefill 或多 token 验证。带 KV Cache 的单 token Decode,其查询长度通常为 1,注意力得分形状接近 1×T;不能把每一步解码都画成重新构建 T×T 矩阵。
HBM 很大,片上存储很快
GPU 的高带宽内存(High Bandwidth Memory,HBM)容量大,适合放权重和缓存;计算单元附近的片上 SRAM、共享内存和寄存器容量小,但访问更快。除此之外还有缓存层次,实际硬件比“两层存储”模型复杂,不过这个简化足以解释 FlashAttention。
可以把 HBM 想成远处的大书库,把片上存储想成面前的书桌。资料最终仍要从书库取来,但如果每做一步就把一整本中间笔记搬回书库,再搬出来,计算单元就会花大量时间等数据。
FlashAttention 将注意力计算组织成能利用片上空间的小块,融合得分、softmax 和对 V 的加权累积,避免把完整的 N×N 中间矩阵写入 HBM。
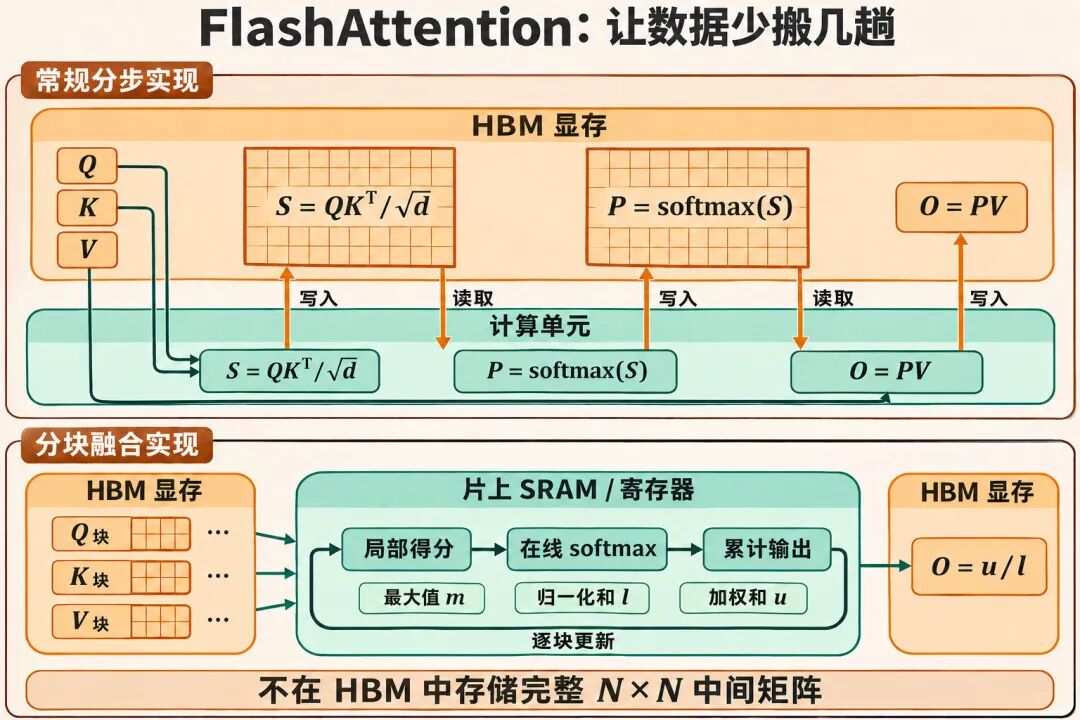
图 5|局部得分在片上处理,跨块保留统计量和累积结果。图中 u 是尚未除以归一化和 l 的加权和。
分块容易,softmax 怎样跨块保持一致
分块(tiling)的做法是把 Q、K、V 拆成若干小块。处理一个 Q 块时,逐块读入对应的 K/V,计算局部得分,并把贡献加入输出。块大小取决于头维度、数据类型、寄存器和共享内存等资源,不能任意指定一个大小就认定一定装得下。
难点在 softmax:一行分数的归一化分母要包含这一行所有允许访问的位置。为防止指数溢出,通常先减去该行最大值 m,再计算 exp(s−m) 并归一化。独立地对每个块做 softmax,最后拼接,通常得不到整行 softmax 的结果。
在线 softmax 为每行维护三个状态:已见分数的最大值 m、指数和 l,以及未归一化的加权和 u。新块出现更大的最大值时,旧统计量需要换到新的缩放基准:
m′ = max(m, 当前块最大分数)
l′ = exp(m−m′)l + Σ exp(sⱼ−m′)
u′ = exp(m−m′)u + Σ exp(sⱼ−m′)vⱼ
所有块处理完后:O = u/l
这里的求和只针对当前块。最大值、归一化和及加权和逐块更新,就能在不保存整行分数的情况下得到同一注意力计算的结果。
用分数 [2, 4, 6] 看一次更新。先读 [2, 4],此时 m=4,l=exp(−2)+1≈1.1353。再读 [6],最大值升到 6,要把旧 l 乘以 exp(4−6),得到约 0.1537,再加上 exp(6−6)=1,结果约为 1.1537。
一次性处理整行也会得到 exp(−4)+exp(−2)+1≈1.1537。u 同样进行重缩放,最后统一除以 l;对应三个位置的 softmax 权重大约为 0.0159、0.1173、0.8668。
仍然读取 K/V,为什么搬运量更少
沿用一个只为说明量级的例子:单头、N=4,000、d=128,假设 Q 块长度为 256。朴素分步实现仅 S 和 P 的四次完整读写,就涉及约 6,400 万个元素;另有 Q/K/V 和最终输出等数据访问。
若按 Q 块遍历 K/V,Q 有 ceil(4,000/256)=16 个块。每个 Q 块都读取全部 K 和 V,对应约 16×2×4,000×128=1,638.4 万个元素;加上 Q 读取和 O 写回约 102.4 万个元素,总量约为 1,740.8 万个元素。
这个简化账本说明,即便 K/V 会被重复读取,省掉巨大的中间矩阵仍能明显减少数据搬运。它忽略了因果三角区域、缓存命中、边界块、融合策略和具体内核资源限制,不能用来预测某张 GPU 的实际带宽或提速倍数。“元素”也不是“字节”,实际流量还取决于各中间量的数据类型。
“精确注意力”与版本演进
FlashAttention 执行的是相同的注意力运算,不依靠丢弃 token 之间的关系来近似。计算顺序发生变化时,浮点舍入仍可能造成微小数值差异,因此数学等价不表示所有实现都逐比特相同。
对于完整注意力,它消除的是平方规模的中间矩阵存储,相关额外存储可降为随 N 线性增长;主要的 token 两两交互计算量仍然是平方级。模型本身的上下文能力也不会因为换一个内核而自动延长。滑动窗口注意力则会限制每个位置能访问的范围,两者属于不同的优化,可以在支持相应掩码的实现中组合。
训练还涉及反向传播。FlashAttention 在前向保留少量逐行统计量,反向在片上重新计算需要的局部得分和概率,换取更少的激活存储与 HBM 访问。保存的统计量可以用最大值、归一化和或等价的 log-sum-exp 表示。这部分属于训练机制,常规推理没有反向传播。
FlashAttention-2 进一步减少非矩阵乘法操作,沿序列维度增加并行度,并优化线程块内各 warp 的工作划分,以减少共享内存通信。其实现可以把除以归一化和的操作放到末尾,但在线最大值改变时所需的指数重缩放仍然存在。不能把它理解为跨块时完全不再重缩放。
FlashAttention-3 针对 Hopper 架构利用 TMA 异步搬运、异步矩阵乘法及计算与 softmax 的重叠,并探索 FP8 低精度计算。它的重点是结合特定硬件组织执行,不能简化为“只用了异步拷贝”,也不能把某一代 GPU 上的结果直接外推到其他设备。
相关论文曾报告 FlashAttention 相对基线约 2~4 倍的注意力运行时间收益,以及 FlashAttention-2 相对前代约 2 倍的收益;具体数字受输入形状、硬件、精度和基线影响。部署时要看当前框架对所用 GPU、掩码、头维度和数据类型的支持情况,而不能只按版本数字选择。
06投机解码:用一次验证推进多个 token
为什么验证可以一起做
低批量解码时,大模型可能每一轮都要读取大量权重,却只处理少数新位置。即便 KV Cache 已避免重复计算前缀,一条长回答仍要经历许多串行轮次。
投机解码(Speculative Decoding)让一个便宜的草稿器先给出若干候选 token,再由目标模型验证。经典方案使用一个小型草稿模型和一个大型目标模型,例如 1B 级草稿模型配合 70B 级目标模型;这只是规模示意,能否加速取决于草稿成本和两者的匹配程度。
草稿模型顺序生成候选 t1、t2、t3、t4。候选一旦确定,目标模型就能够在一次前向计算中求出相关位置的条件分布,像处理一段已知输入一样利用并行计算。因果掩码依然有效,每个位置只依赖它之前的前缀,没有让后面的 token 偷看未来。
工程实现通常复用已经计算的提示词 KV,只处理待验证的新位置及必要的边界输入,不必每轮都把整段提示词从头算一次。并行的是各位置分布的计算;接受决策仍要遵守从前向后的前缀顺序。
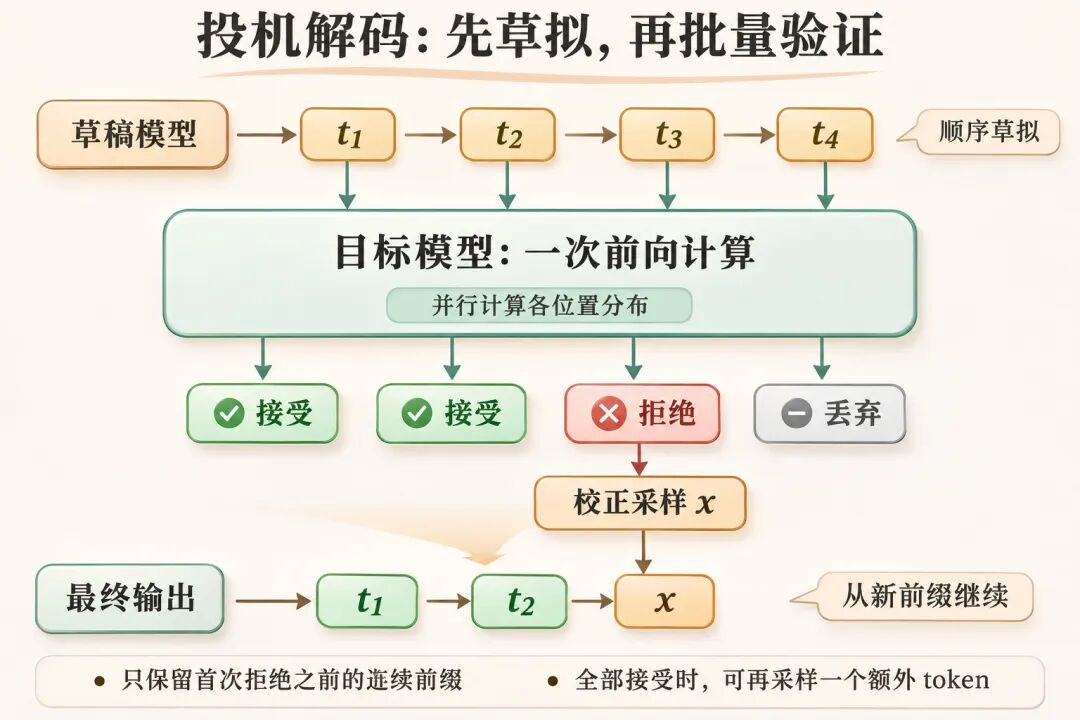
图 6|t3 被拒绝后,t4 的条件前缀已经失效,需要丢弃;本轮推进 t1、t2 和校正 token x。
一次验证怎样形成新前缀
用一个简化的贪心示例说明:提示词为“I love teaching AI”,草稿是“and / Machine / Learning / today”。目标模型按相应前缀给出的选择依次是“and / Machine / Learning / everyday”。
前三个候选匹配,保留;第四个不匹配,改为目标模型的“everyday”。本轮因此新增 4 个 token,下一轮从新的完整前缀继续。若更早发生拒绝,后面即使某个候选看起来合理,也不能越过拒绝点单独保留。
如果 4 个候选全部被接受,目标模型还提供了最后一个候选之后的分布,可以再产生一个额外 token,本轮最多推进 5 个。这个额外 token 不需要再做一次目标模型前向计算,不过系统仍有采样、缓存更新和调度等开销。
随机采样靠什么保持目标分布
“与目标模型的最大概率 token 一样就接受”适合解释贪心流程,不能直接替代随机采样的校验规则。随机采样需要比较两个条件分布:q(x) 是草稿分布,p(x) 是目标分布,它们必须基于相同的已接受前缀,并与实际采样设置一致。
候选 x 从 q 中产生后,以以下概率接受:
接受概率 a(x) = min(1, p(x)/q(x))
若 q("Machine")=0.6、p("Machine")=0.8,则接受概率为 1。若 q("today")=0.5、p("today")=0.1,则接受概率是 0.2:20% 的概率接受,80% 的概率拒绝。
发生拒绝后,需要从校正分布中重新采样:
r(x) = max(0, p(x)−q(x)) / Σᵧ max(0, p(y)−q(y))
这里的求和覆盖候选词表。例如在某个位置,三个词的概率分别为:
- everyday:草稿 q=0.2,目标 p=0.5,正差为 0.3。
- today:草稿 q=0.5,目标 p=0.1,正差为 0。
- tomorrow:草稿 q=0.3,目标 p=0.4,正差为 0.1。
若草稿抽到 today 且被拒绝,正差总和为 0.4,于是校正分布对 everyday 的概率为 0.75,对 tomorrow 为 0.25,对 today 为 0。
这并不是说目标模型永远不会生成 today。它仍可以通过“草稿提出后被接受”这条路径出现。接受路径为 token x 提供的概率质量是 min(p(x),q(x)),拒绝后的校正路径补足正差,两者合起来才恢复 p(x)。
因此,标准拒绝采样式投机解码在理想算术下保持目标模型的输出分布。随机运行的某次文本未必与另一条普通采样运行逐字相同;贪心模式、随机数使用方式和浮点误差也需要分别考虑。带宽或延迟优化不应被误写成所有实现、所有解码模式都天然“完全无损”。
什么时候赚,什么时候反而慢
假设普通目标模型单 token 解码耗时 50 ms,草稿每个 token 耗时 5 ms,每轮草拟 4 个 token;再额外假设验证这 4 个 token 耗时也是 50 ms。那么每轮总成本是 4×5+50=70 ms。
- 全部接受:得到 4 个候选加 1 个额外 token,共 5 个。普通生成要 250 ms,示例加速比为 250/70≈3.57。
- 接受前三个:再加一个校正 token,共 4 个。普通生成要 200 ms,示例加速比为 200/70≈2.86。
- 第一个就拒绝:只得到一个校正 token。普通生成要 50 ms,这里却花了 70 ms,加速比约 0.71,实际变慢。
如果平均每轮推进 4 个 token,生成 200 个 token 大约需要 50 轮,即 3.5 秒,普通逐 token 生成则需要 10 秒。这里忽略了 Prefill、末轮截断和其他开销,所有毫秒数都是教学假设。
更一般地,记每轮平均实际推进 token 数为 E[n],草稿长度为 k,则可以粗估:
加速比 ≈ E[n] × 普通单步耗时 /(k × 草稿单步耗时 + 验证耗时)
验证多个 token 的成本不保证等于一次普通解码。草稿越长,需要的计算和缓存通常越多,也越可能在较早拒绝后浪费后半段。实际优化应关注平均接受前缀长度和每轮推进量,结合草稿耗时、验证耗时共同判断。
相关早期工作在 T5-XXL 和指定基线上报告过 2~3 倍加速,但这不是所有生产请求的固定收益。低并发、目标模型带宽受限、草稿便宜且匹配度高时通常更有利;短回答、匹配度差或高并发已经充分利用计算资源时,收益可能缩小甚至转负。
草稿器不一定是第二个完整模型
独立草稿模型需要额外权重和运行时缓存,也增加部署复杂度。经典 token 级方案通常要求草稿与目标的 token 空间兼容;使用不同 tokenizer 时,需要额外的对齐或转换方法,不能直接套用同一流程。
还有其他草拟方式。Medusa 用额外预测头生成候选;EAGLE 系列利用模型内部特征进行草拟;N-gram speculation 从已有文本中寻找重复模式,把后续片段作为候选,适合答案大量复用输入的场景。不同方法的验证策略并不完全相同,不能只凭“投机解码”这个名称推断其分布保证。
DeepSeek-V3 的多 token 预测(MTP)模块也能充当草稿器。其技术报告给出的特定设置中,第二个 token 的接受率约为 85%~90%,解码吞吐达到约 1.8 倍。模块在训练时学习预测未来位置,推理时参与草拟与验证,因此不一定需要单独部署另一套完整草稿模型。
vLLM、SGLang 和 TensorRT-LLM 都提供相关实现,但可用方法、模型支持和组合限制随版本变化。评估时应明确使用了哪一种草稿器和哪一种验证规则。
07连续批处理:每轮重新安排活跃请求
静态批次为什么会逐渐变空
GPU 适合并行处理多个请求。批处理能够让一次权重访问服务更多序列,把小矩阵运算组织得更有效。不过,“8 个请求一起跑与 1 个请求耗时一样”只在某些未饱和区间可能近似成立;批量继续增大,单轮耗时也会变化。
静态批处理先选定一组请求,然后一直运行到这一批全部结束,再开始下一批。若一个请求只生成几十个 token,另一个要生成上千个,短请求完成后留下的位置就无法及时补入新请求。
有的实现继续对完成位置做掩码或填充计算,有的实现会压缩活跃序列。无论采用哪种实现,只要批次边界不允许加入新请求,后续请求仍要等待,活跃批次也可能越来越小。
连续批处理(Continuous Batching)把调度粒度缩小到迭代。一次迭代完成后,系统检查哪些请求结束、哪些资源可回收,再让符合条件的等待请求加入后续迭代。它也常被称为迭代级调度或 in-flight batching。
可以把批次理解为一辆会沿途接送乘客的车。有人下车后,空位就可以接新乘客,不必等最远的乘客下车才开始接下一批。
服务器循环中发生了什么
一个简化的连续批处理循环包括:
- 新请求进入队列,调度器检查可用显存、token 预算和并发限制。
- 为能够接入的请求安排 Prefill,建立它们自己的缓存状态。
- 执行本轮计算,为活跃解码请求推进 token,并按需要流式返回。
- 检查结束标记、停止条件和长度上限,移除已完成请求,释放或保留可复用缓存块。
- 根据资源情况接入新请求,并安排下一轮。
这里的“空位”是帮助理解的抽象。生产系统通常同时考虑序列数、每轮 token 数、KV 块预算等约束,批量可以动态变化。新请求需要 Prefill,也不会在某个 CUDA 内核执行到一半时突然插入;接入发生在调度边界。
五个请求,一张时间线
假设有 4 个槽位,A、B、C、D 分别还需要 100、20、50、200 轮生成迭代,E 在开始后不久到达,需要 30 轮。为突出调度差异,先忽略 Prefill,假设每轮固定为 50 ms。
静态批处理到第 200 轮才结束 A/B/C/D 这一批,E 随后开始,到第 230 轮完成。连续批处理在第 20 轮 B 完成后,就让 E 加入;E 在第 50 轮完成,D 仍在第 200 轮完成。
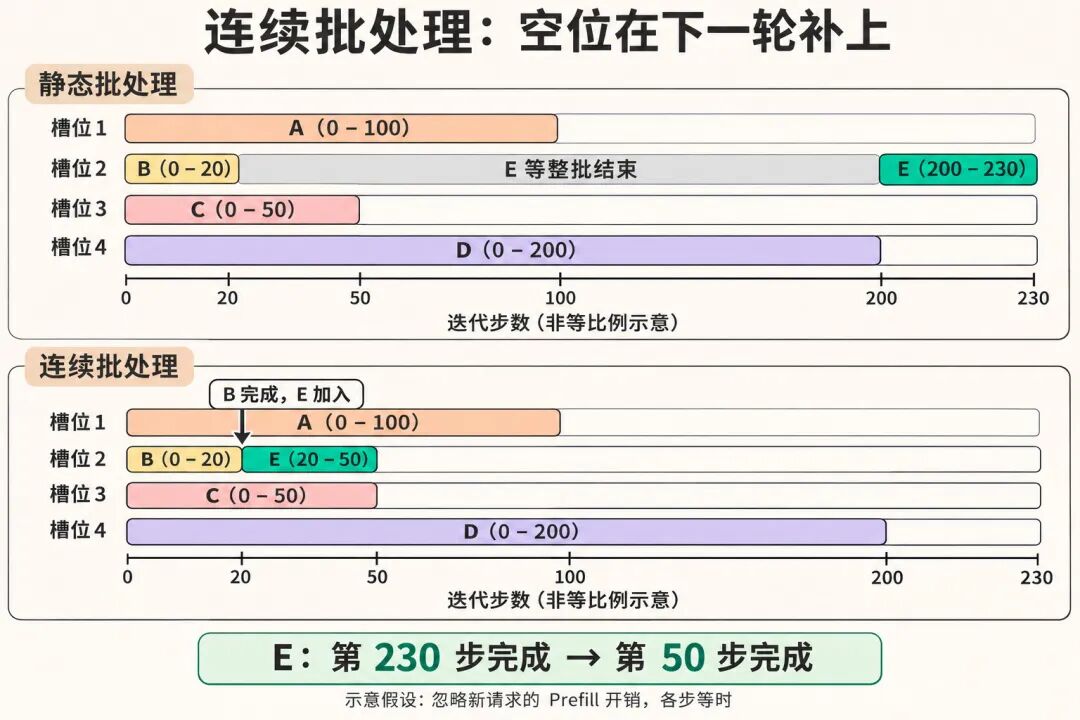
图 7|E 的完成时刻从第 230 轮提前到第 50 轮。队列没有更多请求后,连续批次也会留下空位。
按相同起点统计,A、B、C、D 的完成时间依次是 5.0、1.0、2.5、10.0 秒。E 则从静态批次的 11.5 秒缩短为连续批次的 2.5 秒,约快 4.6 倍。五个请求的平均完成时间由 6.0 秒降到 4.2 秒,全部完成的总时间由 11.5 秒降到 10.0 秒。
E 的改善主要来自少排队,D 本身并没有在这个模型里生成得更快。所谓连续批处理提速,需要说清衡量的是排队、平均完成时间还是服务器吞吐。
100 个请求的吞吐账本
再设有 50 个短请求,每个需要 20 个生成 token;另有 50 个长请求,每个需要 200 个,共 11,000 个 token。仍用 4 个槽位、每轮 50 ms 的简化模型。
若静态批次恰好每批包含 2 短、2 长,就需要 25 批,每批都运行 200 轮,即 10 秒。总耗时 250 秒,输出吞吐是 11,000/250=44 token/s。
连续批处理若四个槽位始终满载,每轮产出 4 个 token,理想吞吐为 4/0.05=80 token/s,相应理想时间为 11,000/80=137.5 秒,约为前者的 1.82 倍吞吐,理想耗时减少 45%。
137.5 秒是忽略队尾空槽、排布约束、Prefill 和调度成本的满载下界,并非这 100 个离散请求一定能够达到的完工时间。流量不足、请求长度很接近,或者调度开销较大时,收益都会变化。
vLLM 的 PagedAttention 论文在其模型、数据集和实验条件下,相对 FasterTransformer 与 Orca 等系统报告过同等延迟下 2~4 倍吞吐收益。这是完整服务系统的对比,包含显存管理和调度等因素,不能把它全部归因于连续批处理,也不能把某种基线上的二十余倍结果当作普遍结论。
连续批处理的约束
连续批处理与 PagedAttention 配合得很好:请求结束时释放块,新请求按需获取块,调度器就更容易维持有效并发。GQA 减少每条序列占用的缓存,也能为并发留出空间。但显存、计算、带宽和每轮 token 预算都有上限,请求不能无限加入。
新请求的 Prefill 还可能干扰已经在 Decode 的请求。一个特别长的提示词占用 GPU 时,其他用户的 token 间隔可能突然变大。分块预填充可以把长 Prefill 切开,与解码交错调度;更大规模下也可以把 Prefill 和 Decode 放到不同设备,但这会引入 KV 传输、路由和资源配置成本。
吞吐量和单请求延迟也有取舍。为了接更多请求而不断扩大批次,可能使每轮变慢;队列持续满载并不等于每个用户都获得了更好的体验。应在目标延迟范围内寻找可承载的吞吐量。
连续批处理主要改变执行安排,不改变模型定义的概率计算规则。不过,批量变化可能改变数值执行路径,随机采样的管理方式也会影响可复现性,因此不宜承诺每次文本都与独立运行逐字一致。
08把六种技术组合到同一条服务链路
从模型结构,到请求结束
在一个采用 GQA 的模型上,KV 头数首先决定每个 token 的缓存数据量。请求到达后,调度器安排 Prefill;注意力可以使用与硬件及模型兼容的 FlashAttention 类内核,产生的 K/V 写入由分页机制管理的缓存块。
进入 Decode 后,KV Cache 提供历史状态,连续批处理每轮重新组织活跃请求。如果负载适合,投机解码还可以为某条序列先草拟多个 token,让目标模型批量验证。请求结束后,释放专用缓存;符合复用条件的公共前缀则由缓存策略决定是否保留。
这六种技术的职责可以分别概括为:
- KV Cache:减少历史位置的重复计算,代价是保存历史 K/V。
- PagedAttention:让缓存按需分配并支持灵活共享,提高显存有效利用率。
- GQA:在模型结构中减少 KV 头数,降低缓存数据量与相关读取量。
- FlashAttention:组织注意力计算,减少大中间矩阵的显存读写。
- 投机解码:花少量草拟成本,争取一次目标模型验证推进多个 token。
- 连续批处理:在迭代边界重新调度请求,减少等待与批次空置。
它们并不是互不影响的开关。连续批处理把 GPU 算力用得更满后,投机验证可利用的余量可能减少;上下文增长后,KV 读取可能成为主要负担;分页与内核实现的组合,也会影响访存效率。单项测试中的收益不能简单相乘。
优化顺序应跟着测量结果走
如果首 token 等待过长,先区分排队时间与 Prefill 时间,检查提示词长度、可复用前缀以及预填充调度。若首 token 很快、后续输出慢,再看解码阶段的带宽、上下文长度、活跃批量,以及投机解码的实际推进效率。
如果问题是显存不足、并发上不去,应拆开权重、有效 KV 数据和分配浪费:分页改善空间利用,GQA 由模型结构决定;量化、窗口化等其他手段还涉及精度或上下文范围的取舍。
服务评估应固定模型版本、硬件、数值精度、采样参数和输入输出长度分布,逐项改变配置,记录 TTFT、ITL、端到端延迟、输出吞吐、峰值显存及接受前缀长度。除平均值外,还应查看高分位延迟,确认少数长请求没有拖慢大量普通请求。
本文转载自微信公众号「AI灰鲸」,仅供学习交流使用。
觉得内容不错?我要