
大模型推理中的 PD 分离:计算特征、KV Cache 传输与引擎实现
本文来源: glmapper(公众号:glmapper)
原文链接: https://mp.weixin.qq.com/s/-qEPXZFA6K00ieN-mBmsjw
发布时间: 2026-09-16 17:37
作者: glmapper 发布时间: 2026-09-16 17:37
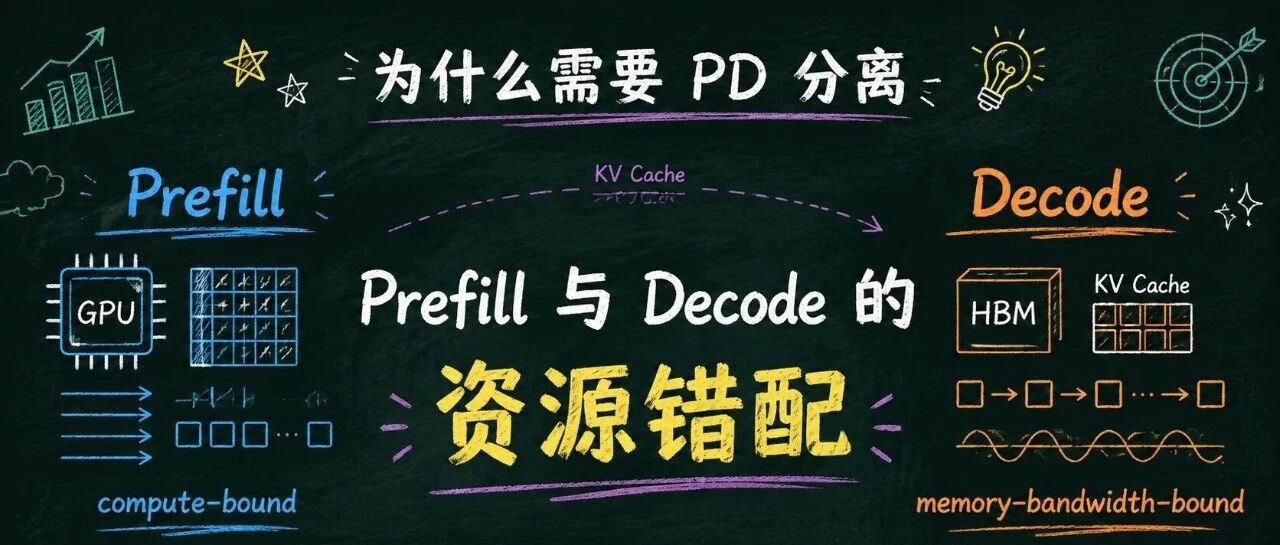
Prefill-Decode Disaggregation 的产生直接来自自回归 Transformer 推理过程内部两种不同的计算形态 。一个请求从模型语义上看是一条连续的生成链路,但进入 GPU/NPU 后,输入上下文处理与后续逐 Token 生成在计算粒度、显存访问、Batch 组织、延迟目标和并行方式上都存在明显差异。
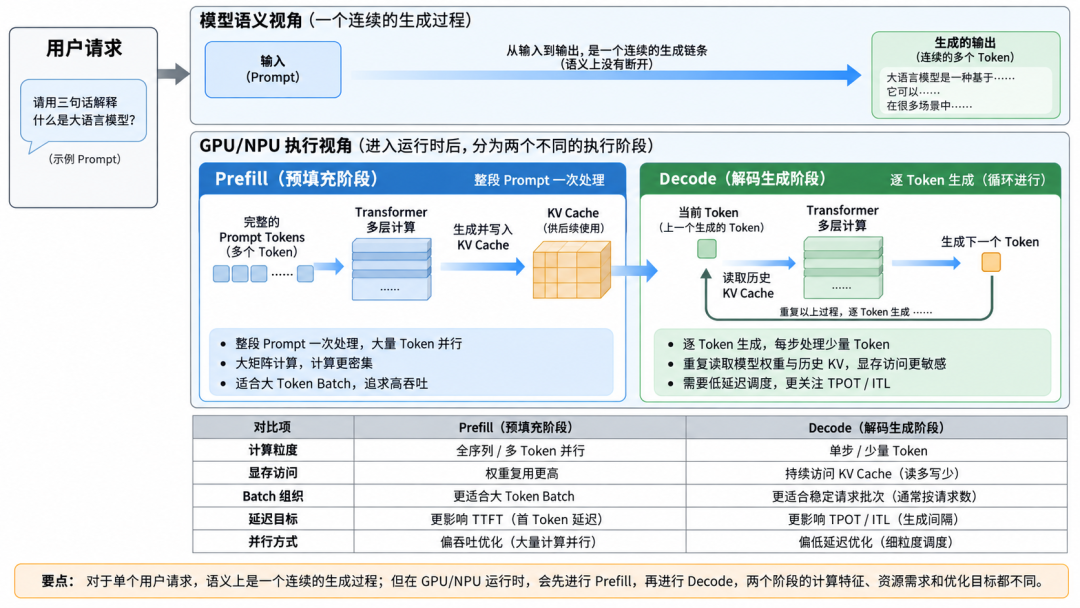
Prefill 一次消费整段 Prompt,可以让大量 Token 同时进入模型,因此更容易形成较大的矩阵计算;Decode 每一轮只推进少量 Token,却需要重复执行全部 Transformer Layer,同时不断读取模型权重和此前积累的 KV Cache。当大量请求同时进入在线推理系统以后,这两类负载会开始竞争同一批计算资源和同一个调度器,一个阶段的优化通常会影响另一个阶段的延迟,因此 PD 分离逐渐从单纯的性能优化演化成大规模推理系统中的一种资源组织方式。
从系统角度看,PD 分离要解决的问题并不是简单地把两个阶段放到不同 GPU 上,而是把原本耦合在同一个 Runtime 中的计算阶段拆成独立的执行域。拆分后的 Prefill 和 Decode 可以拥有不同的请求队列、Batch 策略、资源数量、并行拓扑和扩缩容策略,但请求在模型语义上仍然必须保持连续。Prefill 已经完成的上下文计算不能在 Decode 上重新执行,否则分离本身就失去了意义,因此系统必须将 Prefill 形成的模型运行状态交给另一个 Decode Runtime。由此,KV Cache 从单机推理引擎内部的一块显存缓存,逐渐变成一个需要跨实例定位、传输、映射和管理的分布式状态对象,这也是理解整个 PD 架构最重要的切入点。
Prefill 与 Decode 的计算特征差异
对于典型的 Decoder-only Transformer,请求进入模型以后首先执行 Prefill。此时 Prompt 中的几千甚至数万个 Token 都已经确定,模型可以一次性处理完整序列,各层的线性变换会形成较大的矩阵计算。同一份模型权重读取到计算单元以后,可以同时参与大量 Token 的计算,因此权重的数据搬运成本能够被更多计算摊薄,GPU Tensor Core 或 NPU 矩阵计算单元也更容易得到充分利用。Attention 在这一阶段除了完成上下文建模,还会为每个 Token 生成对应的 K 和 V,这些状态会被保存下来,形成后续自回归生成所需要的 KV Cache。
进入 Decode 以后,模型执行方式发生变化。Prompt 已经处理完成,每一次 Forward 通常只需要生成新的一个 Token,但这个 Token 仍然必须通过模型的全部 Transformer Layer。历史 Token 不需要重新执行,因为它们对应的 K/V 已经保存在 KV Cache 中;与此同时,新 Token 的 Attention 又需要访问这些历史状态,随着上下文越来越长,每一轮 Decode 要读取的状态量也不断增加。最终形成的结果是:Prefill 更容易通过大量 Token 并行形成较高的计算密度,Decode 则反复经历 “读取模型权重、读取历史 KV、计算少量新 Token、追加新的 KV” 这一循环,因此 在线低延迟场景中的 Decode 往往更加敏感于显存带宽、KV 访问效率以及 Batch 大小。
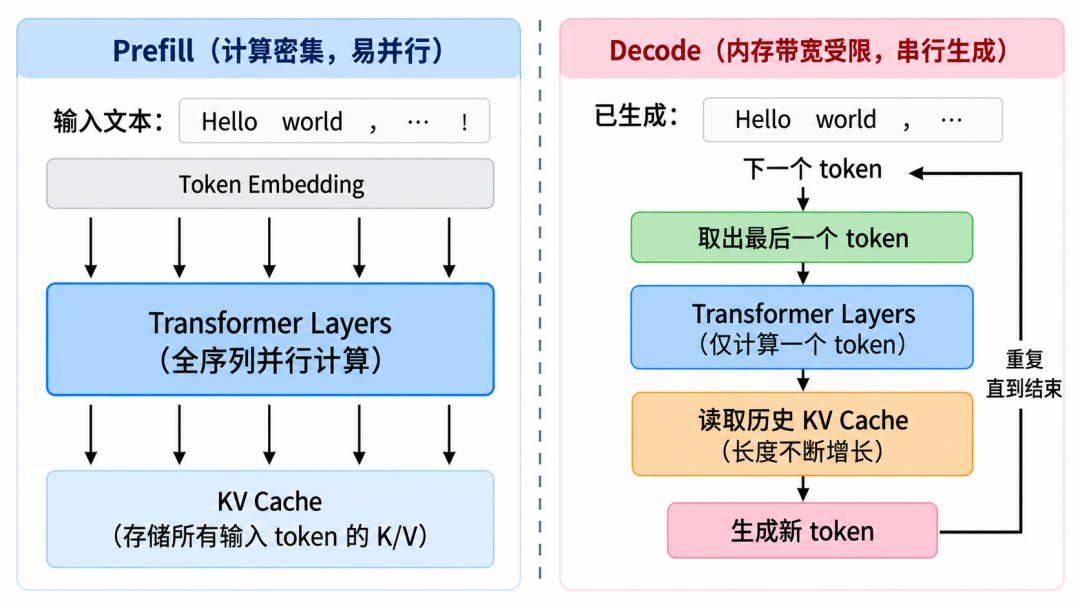
把 Prefill 简单理解成计算密集、把 Decode 理解成显存带宽受限,只能作为一种典型工作区间下的工程近似。实际系统中,Decode Batch 足够大时,同一份权重能够被更多请求复用,Decode 的算术强度同样会上升;Prompt 很短或者 Prefix Cache 命中率很高时,Prefill 的计算压力也会明显下降。总结来说就是:两种阶段对计算、显存和时延的敏感方式不同,而且这种差异会随着上下文长度、Batch、模型结构以及并行策略发生移动,因此 PD 的价值是让系统能够根据真实工作负载分别优化两种阶段。
KV Cache 在这里起到了连接两个阶段的作用,它的规模由模型层数、上下文长度、KV Head 数量、Head 维度、数据类型和并发请求数量共同决定。上下文变长以后,Prefill 需要处理更多输入 Token,Decode 也要在之后的每一步持续访问更大的历史状态,因此长上下文同时增加了前处理计算压力和后续生成阶段的显存访问压力。MHA、GQA、MQA、MLA 等 Attention 结构之所以与 PD 密切相关,也正是因为它们改变了模型在不同阶段需要保存和搬运的运行状态规模,最终会直接影响 KV 传输成本以及 P/D 资源规划。
混合部署下的 Prefill/Decode 调度冲突
在一个没有 PD 的推理实例中,Prefill 和 Decode 通常共享同一个 GPU/NPU 资源池和同一个 Scheduler。假设系统已经存在几十个处于生成阶段的请求,这些请求需要周期性进入下一轮 Decode,以保证 Token 能够稳定输出;此时突然进入一个 32K Prompt,请求的 Prefill 可能持续占用计算资源较长时间。如果调度器立即执行这个长 Prefill,正在生成的请求就会等待,用户看到的直接现象是流式输出暂停,ITL 或 TPOT 出现明显尖峰;如果调度器持续优先照顾 Decode,新请求又会长时间排队,首 Token 返回时间 TTFT 随之增加。
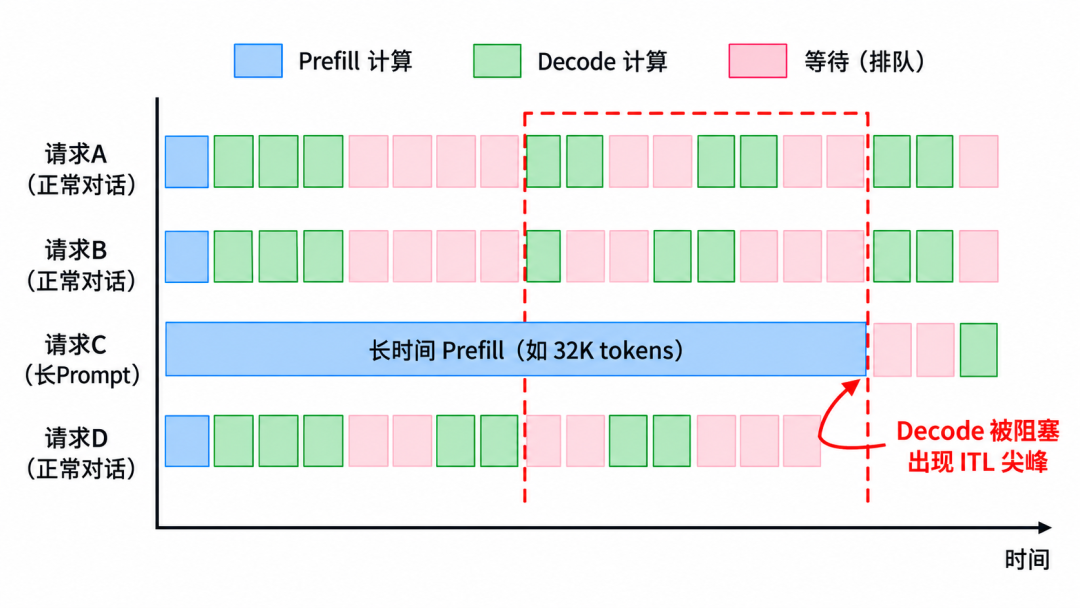
这个问题本质上是 两种不同时间尺度的任务共用一个调度域。Prefill 更希望聚合大量 Token,以提高矩阵计算效率和整体吞吐;Decode 更关心下一次调度能否及时发生,因为单次 Forward 本身不一定很重,但任何额外等待都会直接反映到 Token 间隔上。两种任务混合以后,Scheduler 必须不断在 “让 Prefill 多运行一会儿” 和 “立即切回 Decode” 之间取舍,这也是很多推理引擎引入 Chunked Prefill 的原因。长 Prompt 可以被切成多个较小 Chunk,在不同 Chunk 之间穿插 Decode,从而减少单次阻塞时间,但 Chunk 大小本身又成为一个新的调优参数:Chunk 太大仍然会干扰 Decode,Chunk 太小又会削弱 Prefill 的计算效率,同时增加调度和 Kernel Launch 开销。
因此,Chunked Prefill 和 PD 实际上处在不同的架构层次。前者仍然接受 Prefill 与 Decode 共用同一个执行域,只是在这个执行域内部重新设计时间片分配方式;后者则进一步把两种负载拆成两个独立 Runtime,让它们分别组织队列和 Batch。拆分之后,系统不仅可以隔离 TTFT 与 TPOT,还可以让 Prefill 和 Decode 分别使用适合自己的并行策略与资源数量。对于输入很长、输出较短的业务,可以增加 Prefill 资源;对于短输入、长推理链的场景,可以增加 Decode 资源;对于大规模 MoE,两个阶段还可以分别选择不同的 TP、DP、EP 以及通信模式。PD 实际解除的是调度、Batch、并行策略和资源容量之间原有的耦合关系。
PD 分离后的请求执行链路
完成分离之后,请求首先进入 Prefill Pool,由某个 Prefill 实例完成完整 Prompt 的 Forward,并产生能够支撑后续生成的模型状态。系统随后选择合适的 Decode 实例,把已经形成的状态迁移过去,Decode 获得这些状态后直接从输出 Token 的生成位置继续执行。模型语义上,这仍然是一条连续的自回归推理链;系统实现上,这条链已经跨越两个独立的 Scheduler、两个 Engine Runtime,甚至可能跨越两台不同的物理服务器。
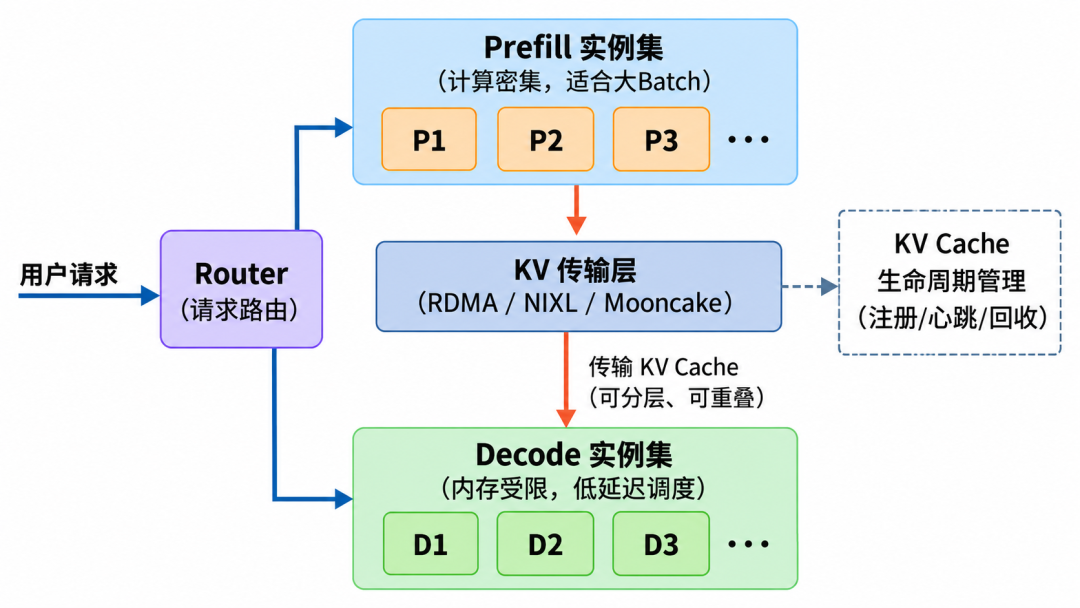
这种变化使推理系统形成了明显的 生产者—传输层—消费者 结构。Prefill Pool 负责快速处理输入并生产模型运行状态,KV Transfer Layer 负责把状态从源实例迁移到目标实例,Decode Pool 负责长期持有请求并持续产生输出 Token。三个阶段中的任何一个变慢都会形成排队:Prefill 能力不足时,新请求堆积在入口;网络带宽不足时,大量已经完成 Prefill 的请求会等待状态传输;Decode 能力不足时,KV 即使已经生成,也无法及时被下游消费。因此 P:D 的比例不能按机器数量简单平均配置,而需要结合业务中的输入长度、输出长度、并发量、模型结构以及网络拓扑共同测算。
从这个角度看,PD 的系统本质比 “P 放几张卡、D 放几张卡” 要复杂得多。底层逻辑变化是模型的一次执行被拆成两个服务阶段,同时模型运行状态开始跨 Runtime 存在。Router 不再只负责负载均衡,还需要决定某个请求先去哪一个 P,再去哪一个 D;传输层不仅搬运数据,还要知道这些 KV 属于哪个请求、哪些 Block、哪些 Layer 和哪些 Rank;Runtime 还必须处理状态什么时候可以释放、目标实例失败以后如何回收、已经存在的缓存是否能够直接复用等问题。PD 因此天然要求推理引擎具备更加明确的控制面、状态面和数据传输面。
KV Cache 的跨实例传输机制
Prefill 和 Decode 分开部署以后,最大的新增成本就是模型状态跨节点移动。一次 Prefill 可能产生几百 MB 甚至数 GB 的 KV 状态,如果这些数据必须等到 Prefill 完全结束之后才开始传输,那么用户虽然已经完成输入计算,仍然需要额外等待网络搬运完成才能看到第一个输出 Token。此时 KV Transfer 会直接落到 TTFT 的关键路径上,网络性能不足甚至可能抵消 PD 原本带来的延迟隔离收益。因此,现代 PD 实现的重点已经从 “能不能传 KV” 转向 “怎样让传输尽量不暴露在请求关键路径中”。
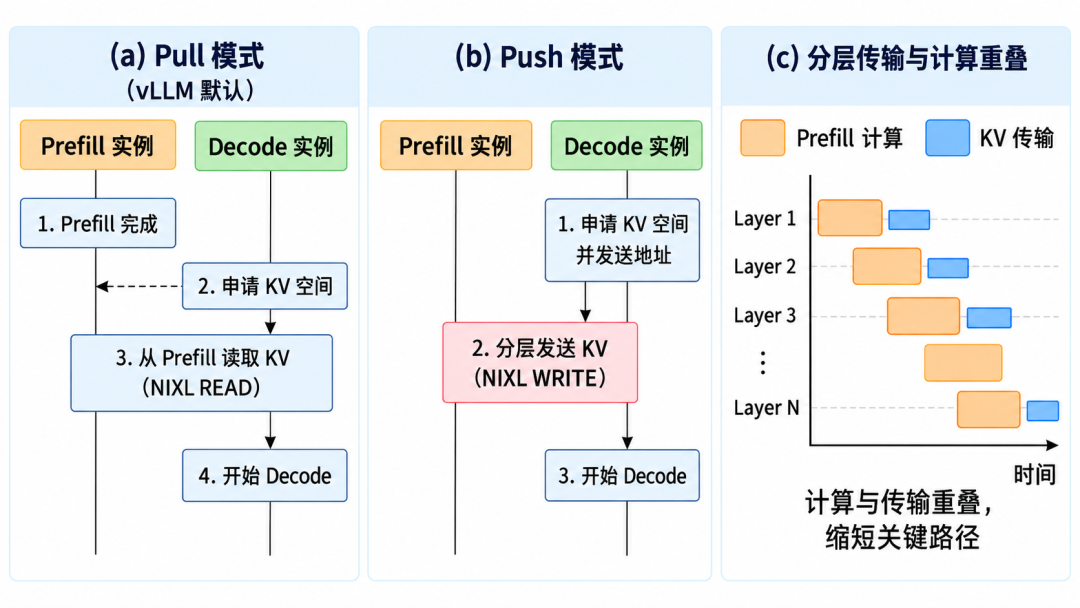
最简单的 Pull 模式是在 Prefill 完成后由 Decode 主动获取状态。Decode 根据请求需要分配 KV Block,再从 P 所在内存区域读取对应数据,这种方式实现清晰、所有权关系明确,因此很适合作为基础协议,但很多准备工作会顺序发生在 Prefill 结束之后。Push 模式会提前让 Decode 分配目标 KV 空间,并把目标地址交给 Prefill,Prefill 在数据准备好以后直接向目标内存写入状态。它改变的不只是数据传输方向,更重要的是让内存准备、地址交换和部分通信控制能够提前发生,从而减少 Prefill 完成后的串行等待。
进一步的 Layer-wise Transfer 会直接利用 Transformer 的层级执行结构。模型在 Prefill 时并不是一次性生成所有 KV,而是每执行完一层就产生这一层对应的状态,因此传输层可以在前面 Layer 的 KV 生成后立即发送,同时模型继续计算后续 Layer。这样,网络传输与模型计算形成流水线,大量通信耗时被后续 Layer 的计算覆盖。最终 Prefill 完成时,大部分状态已经到达 Decode 一侧,只剩最后少量数据和同步开销需要等待。Layer-wise Transfer 的价值是把状态迁移从串行关键路径中尽可能隐藏到模型计算过程里。 这与分布式训练中通过 计算—通信 重叠隐藏 AllReduce 或 AllToAll 的思路非常接近,只是 PD 隐藏的是模型运行状态传输。
影响这种重叠效果的并不只是网卡标称带宽,GPU/NPU Direct RDMA 能否有效工作、显存注册开销、数据块大小、网络并发队列、NUMA 拓扑、不同节点之间的 Fabric 路径以及每层计算时间都会影响实际效果(我们在实际交付场景中,如果是有涉及到算力纳管,不管是侧重训练还是推理,都会直接参与组网这个过程)。单纯拥有 200G 或 400G RDMA 并不能保证 PD 高效,如果数据被拆成大量小块,或者 P/D 内存布局需要频繁重新整理,实际有效带宽仍然可能很低。KV Transfer 本质上是模型内存布局、Runtime 调度和高速网络协同优化的问题。
异构并行下的 KV 布局与数据重排
PD 的一个重要价值是 Prefill 和 Decode 可以分别选择并行策略,但这个能力也给 KV 传输带来了更复杂的问题。如果两端采用完全相同的 TP 拓扑,每个 Rank 上保存的 KV 范围基本可以建立直接映射,状态传输接近大块显存复制;一旦 Prefill 与 Decode 使用不同的 TP、DP Attention 或其他并行方式,同一个请求的 KV 在两端可能具有完全不同的数据布局。P 侧某些 KV Head 被分散在多个 Rank,D 侧却希望将它们组织到另一套 Paged KV Block 中,此时网络传输前后都需要进行数据重排。
这类场景通常需要发送端先把多个离散 KV Slice 聚合到连续的 Staging Buffer,再通过 RDMA 发送较大的连续数据块,接收端随后按照目标 Runtime 的 Block 和 Rank 布局重新分发。SGLang 引入 GPU Staging Buffer 的一个重要目的就是处理这种问题。相比为每个 Token、Layer 和 Head Slice 分别产生小网络请求,GPU 侧先完成 Gather 能显著改善传输粒度,提高网络设备的实际利用率;同时,这个中间层还承担了异构 TP 环境下的数据格式转换,使 P/D 两端真正能够采用不同的并行拓扑。一旦 P/D 的并行拓扑不同,KV Transfer 就不再是简单的数据搬运,而会演化成显存布局转换与网络传输的组合问题。
这也解释了为什么大规模 PD 集群不能单独讨论网络够不够快。模型状态在 GPU/NPU 内部如何切分、KV Page 如何组织、每个 Rank 持有哪些数据、传输层一次能够发送多大连续块、目标端如何重新映射,都会决定网络最终能跑到多少有效吞吐。PD 把原本位于推理 Engine 内部的内存布局问题扩展到了整个分布式系统领域。 模型 Parallelism、Memory Manager 与 RDMA Transport 从这一阶段开始形成强关联。
vLLM、SGLang 与 MindIE 的 PD 实现
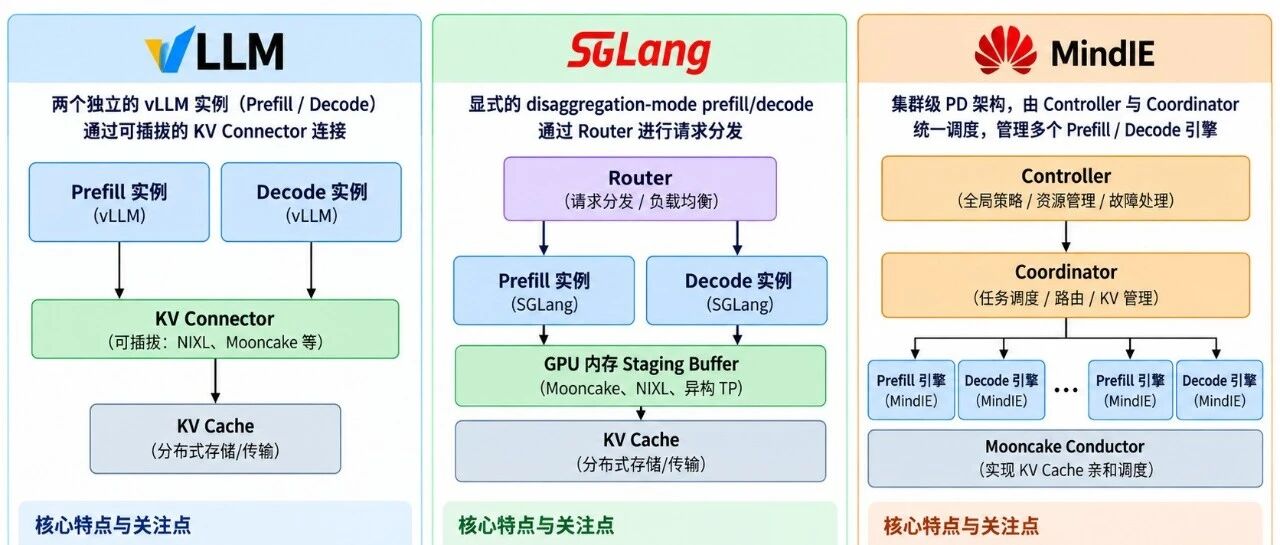
vLLM 的实现特点是通过 KV Connector 把模型执行和状态迁移分开。Prefill 和 Decode 可以作为两个独立 vLLM Engine 存在,Scheduler 负责判断某个请求何时需要保存或加载 KV,Worker 侧 Connector 负责真正的数据发送和接收,Attention 执行期间还可以在合适的 Layer 调用对应的状态操作。这样的抽象使底层传输协议可以替换,NIXL、Mooncake、LMCache 等能力能够作为 Connector 接入,而 Engine 本身仍然专注于模型执行。vLLM 的核心思路,是在现有 Engine Runtime 上增加一个可插拔的分布式模型状态接口。 更上层的 Router 再负责 P/D 选择和全局容量调度。
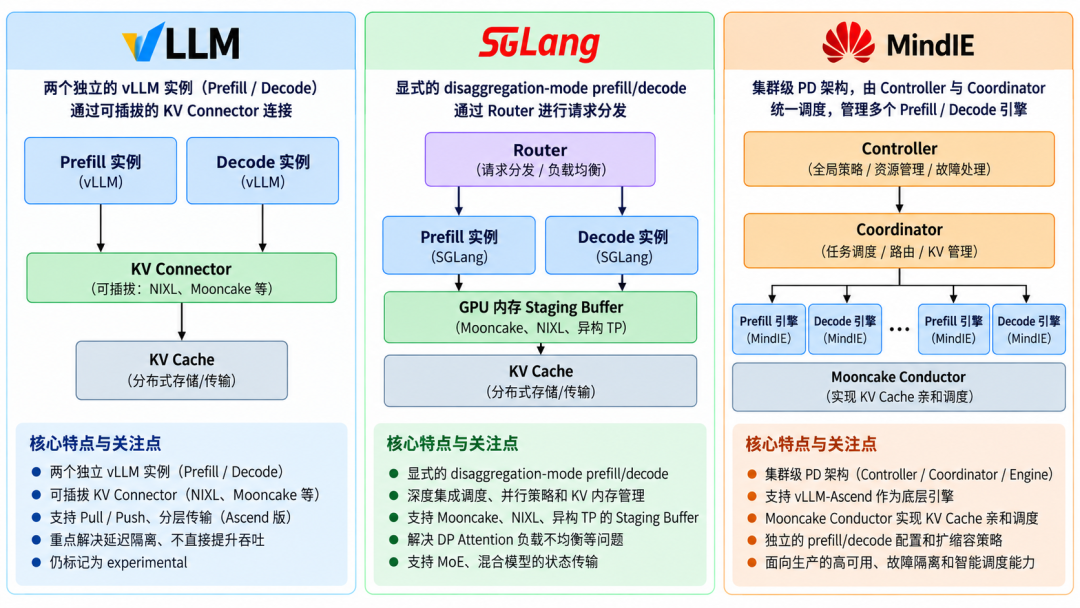
SGLang 把 PD 更深入地嵌入调度和并行体系。Prefill 与 Decode 可以显式作为不同角色运行,Router 对两类实例进行请求分发,KV Transfer 又与 DP Attention、异构 TP、GPU Staging Buffer、Mooncake、NIXL 等机制直接协同。对 MoE 模型而言,这种设计尤其重要,因为 Prefill 和 Decode 对 Expert 通信和单步延迟的要求不同,两个阶段可以分别选择不同的 EP 或 DeepEP 工作模式。SGLang 更倾向于把 PD 作为整个推理 Runtime 的组成部分,让调度、并行、KV 内存和网络传输共同围绕两个阶段优化。
MindIE 的定位进一步向集群级系统延伸。除了底层 Prefill 和 Decode Engine,它还通过 Controller、Coordinator 等组件管理实例生命周期、角色、故障和全局调度,KV Transfer 则结合 Mooncake 等机制形成独立的数据通路。这样一来,PD 不只是某个 Engine 内部功能,而是成为集群控制面的一个资源管理对象。大规模 NPU 集群中,某个 Decode Engine 故障以后如何重新选择实例、已有 KV 是否能够复用等都会进入全局 Scheduler 的决策范围,这也是 MindIE 逐渐强化 KV Cache-aware Scheduling 的原因。MindIE 体现的是将 PD 从单引擎优化进一步提升到集群控制、全局调度和状态位置感知的层次。
三种实现虽然工程方式不同,但底层方向高度一致:推理 Engine 负责阶段内计算,Router 或 Coordinator 负责阶段间调度,KV Transfer Plane 负责状态移动,Memory Manager 则保证状态在两个 Runtime 中拥有一致的逻辑含义。随着系统规模增大,KV 所在位置本身开始成为调度信息,负载均衡逐渐从只看设备利用率和队列长度,发展到同时考虑 KV Locality、网络传输成本和请求 SLO。推理调度正在从传统的负载感知走向状态位置感知。
总结与后话
PD 分离的收益和成本
把 Prefill 和 Decode 分离并不会减少模型必须执行的 Transformer 计算,系统反而会新增第二套模型权重、跨节点 KV Transfer、Router、元数据同步、状态生命周期管理以及可能出现的 P/D 资源不平衡等问题。因此,单纯比较总 Token/s 很难判断 PD 是否真正有效。一个统一部署系统可以拥有很高的峰值吞吐,但如果每次遇到长 Prompt 都让正在生成的请求出现明显停顿,那么大量请求实际上无法满足生产环境对 TTFT 和 TPOT 的要求。
有意义的指标是 SLO 约束下的 Goodput,也就是满足延迟目标的情况下系统能够稳定服务多少请求。PD 可能并没有显著提高理论 Token/s,却通过隔离长 Prefill 对 Decode 的干扰,让更多请求能够稳定落在 TPOT 目标以内;同时,P/D 分离后可以分别调整 Batch、选择更合适的 Parallelism,并根据业务输入输出长度动态调整两种资源池的容量。
因此是否采用 PD 也需要结合具体业务判断(太极还是要打一打的~~~)。短 Prompt、低并发、小模型或者网络条件一般的服务,继续使用 Chunked Prefill 往往更简单;长上下文、高并发、严格 Token 间隔、大规模 MoE、多节点推理以及 P/D 最佳并行策略明显不同的场景,PD 的资源解耦价值会快速上升。系统规模越大,决定 PD 收益的因素也越偏向整体架构,包括 P:D 比例、KV 传输链路、缓存命中率、异构 Parallelism、状态 Locality 和故障恢复,而不再只是某一个模型 Kernel 的性能。
从 KV Cache 到分布式模型运行状态
早期 KV Cache 主要是一项 Attention 计算优化,用于避免每生成一个 Token 都重新计算整个历史序列;PagedAttention 出现以后,KV 又成为需要由 Runtime 管理的显存资源,系统开始关注 Page、Block、Allocator、碎片率和 Prefix Cache。进入 PD 架构以后呢,这个对象进一步跨出了单个 Runtime,需要被其他 Engine 发现、传输、接管和回收,因此它同时具有计算状态、缓存数据、网络数据和调度资源几种属性。KV Cache 的系统角色已经从“减少重复计算的缓存”演化成了“跨执行域延续模型推理所依赖的状态”。
随着模型架构继续演进,需要跨 Runtime 迁移的状态也不一定永远只有标准 K/V。Mamba、Sliding Window、Sparse Attention 以及 Transformer/SSM 混合架构都可能需要维护不同形式的运行状态。一个稳定的系统抽象应该逐渐从狭义的 KV Cache Transfer 转向 Decode-resumable Model State,也就是另一个 Runtime 想从当前模型执行位置继续生成时所需要的全部状态。Decode-resumable Model State 比 KV Cache 更接近未来分离式推理系统真正需要管理的抽象对象。
从这个角度看,vLLM、SGLang、MindIE 当前围绕 NIXL、Mooncake、Layer-wise Transfer、KV Lease、GPU Staging Buffer、KV Cache-aware Routing 等能力进行的演进,本质上都在回答同一个问题:怎样把原来绑定在单机推理引擎内部的模型运行状态,变成一种可传输、可复用、可调度并具有明确生命周期的分布式系统资源。Prefill 和 Decode 的分离不仅仅是表层架构变化,也是模型运行状态开始成为分布式推理系统的一等资源的进化过程。
本文转载自微信公众号「glmapper」,仅供学习交流使用。
觉得内容不错?我要