
从 0 写一个 playwright-tester Skill,我花了 3 天:架构和流程全记录
从 0 写一个 playwright-tester Skill · 3 天全记录
官方 agent 负责生成用例,我这个 Skill 负责验收——架构、流程,以及被脚本当场打脸的 4 个设计缺陷,全部记下来。
「用 AI 写用例」官方已经做完了,这篇讲的是「拒绝用例」
Playwright 1.63 已经自带 planner / generator / healer 三个 agent,还有官方 MCP 和给编码代理用的 CLI。也就是说,「用 AI 帮你写 Playwright 用例」这件事,官方已经做完了。但我花了 3 天写的这个 playwright-tester,一行用例生成逻辑都没有。它做的是另一件事:拒绝用例——什么写法一律不许合、这条用例到底证明了什么、这次失败该算谁头上。这篇把三天的过程、架构、以及被脚本当场打脸的 4 个设计缺陷,全部记下来。
01 PART 先划边界
官方 agent 管「生成」,我的 Skill 管「验收」
动手写第一行之前,我先把能力矩阵列清楚,因为一旦边界含糊,Skill 最后会变成「和官方 agent 抢活」,写出来没人用。
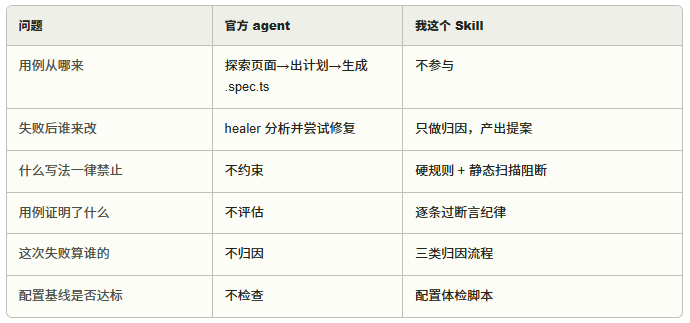
这张表定下来,「不做什么」也就清楚了,一共三条:
- 不重造 agent。生成这件事官方做得比我好,我不碰。
- 不自动改断言。healer 可以提议修,但「把断言放宽到能过」和「修好定位器」在代码上长得几乎一样,必须人来判。Skill 只允许产出提案。
- 不碰真实资金与生产数据。涉及真实支付、真实用户数据的操作,一律不可自动化执行,这条写进硬规则。
这个 Skill 的核心不是「知识」,而是判断标准的可执行化。 边界划完,架构也随之定了下来。
02 PART 架构-四层目录,一次定死
最后的结构是这样——一个标准 Skill 的四层目录,一次定死,后面三天都没有再动过:
playwright-tester/
├── SKILL.md    入口:边界、工作流、硬规则、输出契约
├── references/  知识层:判定规则,按需加载
│ ├── locator-strategy.md  定位器优先级与禁用项
│ ├── waiting-and-sync.md  等待与同步
│ ├── assertion-discipline.md 断言纪律
│ ├── test-structure.md   用例结构与隔离
│ ├── flaky-triage.md    失败三类归因
│ └── evidence-and-traces.md 证据链与 trace 采集
├── scripts/    执行层:确定性检查
│ ├── lint_spec.py   用例静态扫描
│ ├── check_config.py 配置基线体检
│ └── summarize_report.py 报告聚类与归因建议
└── assets/    资产层:模板
  ├── playwright.config.ts 配置基线
  └── test-template.spec.ts 用例骨架
四层各自解决一个不同的问题:
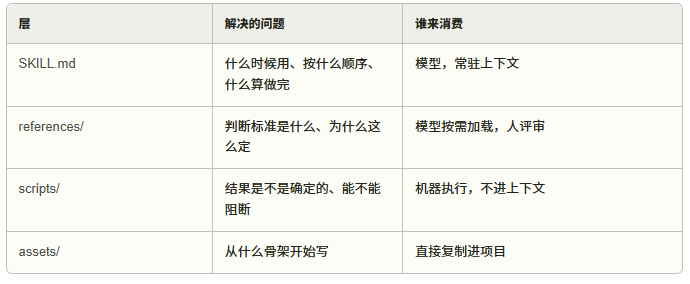
两个设计决定值得单独说。第一,知识层和执行层必须分开。一开始我想把规则直接写进 SKILL.md,写完发现两个问题:文档会越来越长,模型在长文档里会漏规则;而且文档的「违反」永远是人读出来的,不是机器拦下来的。于是规则分家:判断标准留在 references,执行检查搬进 scripts。
第二,扫描器不是锦上添花,它是骨架。这是我第二天才真正想通的(下文有代价):一个 Skill 若只有文档,它的效果取决于模型当天的注意力;有了扫描器,至少「哪些写法不许合入」这件事变成了确定的。文档负责讲道理,脚本负责不讲情面——两者都不可替代。
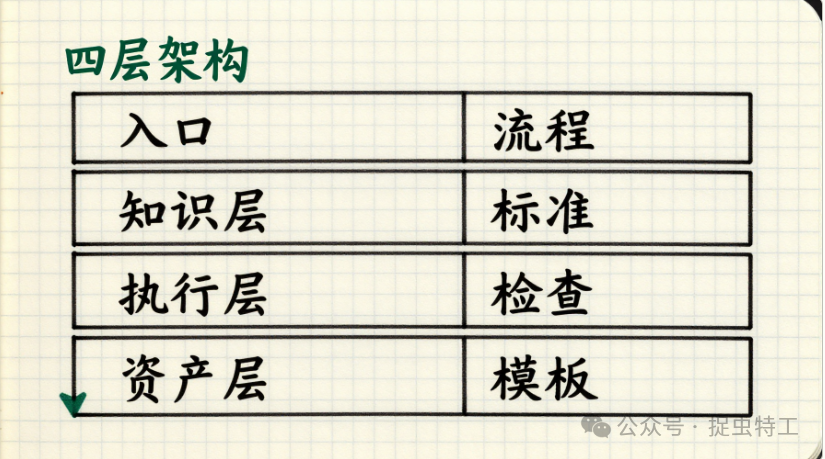
— playwright-tester 的四层目录结构
03 PART 第一天
把「我平时怎么测」拆成可判定的规则
第一天全花在 references 上,最后写成 6 个文件。每个文件回答一个具体的判断题,而不是「Playwright 教程」:
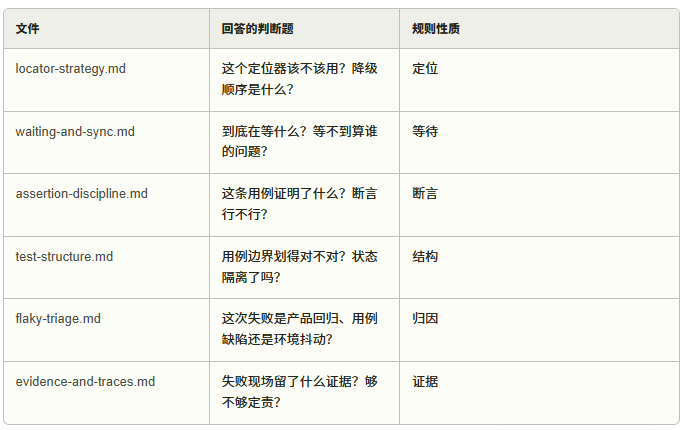
写的过程中我给自己加了一条格式要求,后来证明这是第一天最有价值的产出:每条规则必须写成「判据 + 反例 + 评审检查点」三段。只有判据的规则,等于没写。
举个真例子。定位器优先级我不写「尽量用语义定位器」这种话,而是给一张会掉级的表:
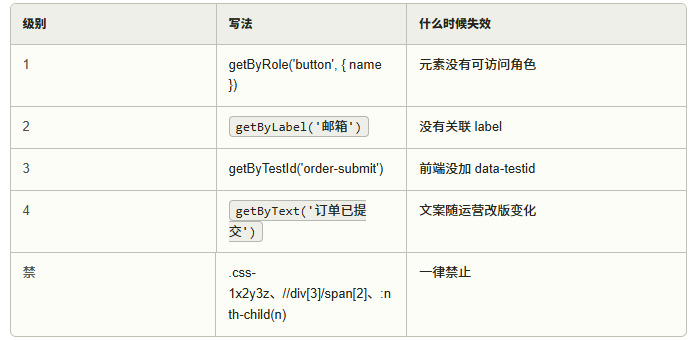
降级的理由也要写出来,否则下次还是不知道该怎么选:级别 1–3 描述的是用户或开发者承诺的稳定契约,改版时通常被刻意保留;级别 4 描述的是内容,会随文案变;级别 5 之后描述的是实现,前端结构一动就全废。
另一个当天必须处理的事是版本敏感知识。Playwright 这两年变化很快,把过时写法写进 Skill,等于给团队埋雷。所以凡是跟版本相关的写法规矩,我都标了版本:跨 frame 定位用无参 frameLocator()、只匹配可见元素用 locator.visible() 取代 :visible(1.63 起);retryStrategy: 'isolated' 与操作级 AbortSignal(1.62 起);WebAuthn passkey 与 page.localStorage(1.61 起);locator.drop() 与 tracing.startHar()(1.60 起)。每条都写清「从哪个版本开始有」,读的人自己判断项目跟没跟上。
「等待」这条规则更能说明问题。只写「不要用固定时长等待」没有意义,得给出替代路径:
// 允许:等状态变化(首选)
await expect(page.getByText('订单已提交')).toBeVisible();

// 允许:等网络条件,而不是等时间
await page.waitForResponse(r => r.url().includes('/api/order') && r.ok());

// 允许:等轮询型条件成立
await expect.poll(async () => (await (await request.get('/api/order/A1001')).json()).status, { timeout: 15_000 }).toBe('SETTLED');

// 禁止:等时间
await page.waitForTimeout(3000);
理由也要写进去:waitForTimeout 不是「慢」,而是把问题藏起来——环境快十倍时白等,慢十倍时照样失败;而它的失败现场永远是「超时」,不会告诉你「在等哪个条件」。这一句话,比十条禁令更能说服人改代码。
第一天结束时我挺满意:6 个文件、结构清晰、道理都讲透了。然后第二天被现实打脸:把这些规则念给模型听,它会在第 30 段漏掉第 3 段。文档写完,不代表规则会被执行。
04 PART 第二天
把规则交给脚本,这层才是分水岭
第二天的目标很明确:写一个扫描器,把硬规则变成确定性的检查。最终是 14 条规则、三个级别:
- ERROR(阻断,退出码 1):固定时长等待、.only 泄漏、绝对 XPath、nth-child 定位、force: true、断言没 await、把 Playwright 断言降级成 JS 判断、用例内没有任何断言
- WARN(人工确认):只用 toHaveCount 判存在、CSS 类名或结构选择器、.first()/.last()/.nth() 位置收敛、networkidle、超时放宽到 100 秒以上、:visible 旧写法
写的过程比想象中曲折。三个缺陷都是脚本一跑就自己跳出来的,而且每一个都很有代表性。
缺陷 1 拦 .only 的规则,被 .only 绕过去了
我准备了三份样例:clean.spec.ts(合格写法)、messy.spec.ts(一堆典型坏味道)、tricky.spec.ts(专门埋误报陷阱:注释里的假代码、模板串里的花括号、多行 await expect)。
第一版跑完,messy.spec.ts 报告「用例 2 条」——但我写了 3 条。漏掉的那条正是 test.only('下单主流程', ...),也就是最该被拦下的那条。原因很简单:我用 test\s*\( 找用例块,而 test.only( 里 test 后面跟的是 .only,压根不匹配。于是这条用例整块没被扫描,里面堆的 XPath、nth-child、force: true、networkidle、isVisible 全部安然过关。
一个用来拦 .only 的规则,恰恰被 .only 自己骗过去了。修法是把块起始改成 test(?:\s*\.\s*\w+)?\s*\(,同时把 test.skip(、test.fixme( 一起纳进来。
缺陷 2 证据对不上原文
同一版输出里,报错证据长这样:
[WARN ] PW011 messy.spec.ts:19 使用 .first()/.last()/.nth() 位置收敛
    证据: to( );
 await page.locator( ).first().locat
行号是对的,证据却是 locator( )——选择器不见了。根因是我做了「脱敏」(把注释和字符串内容抹掉,避免注释里的假代码被当真),但脱敏后的文本长度变了,行号按原文算、证据按脱敏文本取,两边偏移对不上。
修法只有一条路:脱敏必须等长。把注释和字符串内容替换成等长的空格或换行,偏移不变,于是「检测用脱敏文本、证据回原文取」才能成立,报出来的每一行都能直接贴进代码评审。
缺陷 3 选择器类规则永远不可能命中,同时容器被误判
改成等长脱敏后,clean.spec.ts 反而报了一个 ERROR:「用例内没有任何 expect 断言」。点开一看,被判的是 test.describe('通知设置', ...) 这个容器块——容器当然没有断言,它只是分组。这是典型的假阳性。
同时还有反向的漏报:XPath 和 nth-child 两条规则一次都没命中。原因更隐蔽——它们在找的是 locator('//div[@id="app"]/…') 里的内容,而这段内容在「字符串被抹掉」的脱敏文本里根本不存在。脱敏保护了「注释里的假代码」,顺手把「选择器字符串里的真问题」也一起抹掉了。
最后的解法是把脱敏拆成两道工序:
- 只去注释、保留字符串 —— 给选择器规则用(选择器就写在字符串里)
- 再去字符串 —— 给「有没有断言、有没有 await」这类判断用(否则注释里写的 expect(...) 会被当成真断言)
容器块也不再走完整检查,只单独拦 .only。三份样例终于全部符合预期:
clean.spec.ts ERROR 0 / WARN 0
4 条用例,零告警 —— 合格写法不报。
messy.spec.ts ERROR 9 / WARN 14
3 条用例,坏味道全中。
tricky.spec.ts ERROR 0 / WARN 0
4 条用例,注释、字符串、多行写法都不误报。
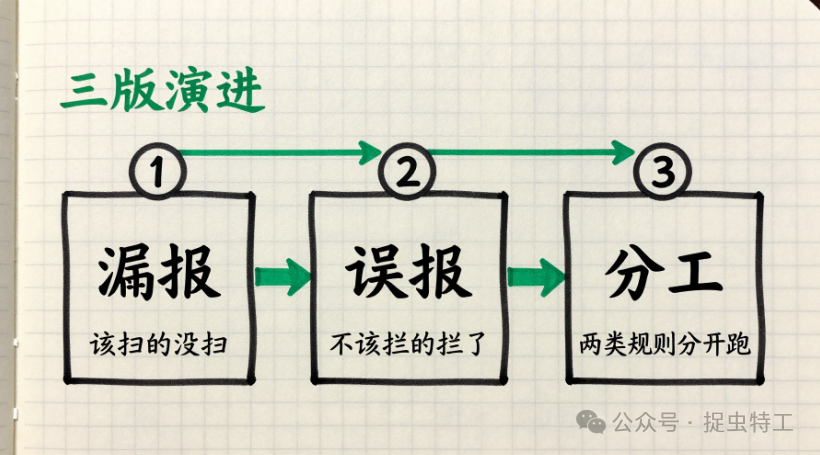
— 扫描器三版演进:从漏报到误报,再到两道脱敏
第二天结束,从这三次打脸里提炼出四条通用结论,我把它们写回了 SKILL.md:
- 先脱敏再切块,且脱敏必须等长。顺序反了或者长度变了,就会出现「行号对得上、证据取到别人身上」。
- 选择器类规则要在「保留字符串」的那份文本上跑。一道脱敏不可能同时满足两类规则。
- 容器与用例分开处理。否则 describe、test.step 都会被判成「没有断言的用例」。
- 宁漏不误报。误报会让整套门禁失去可信度——工程师第一次被冤枉,第二次就直接关掉它了。所以 tricky.spec.ts 这种「误报陷阱」样例必须常驻。
05 PART 第三天
拿真实回归把规则打回来
第三天不再靠想,直接跑。我在本机装了 @playwright/test 1.63,用 page.setContent() 自建页面(不依赖任何外部服务,离线可复现),写了一份 8 条用例的演示回归,故意把失败按不同签名铺开,然后看两个脚本的表现。
先看配置体检。它跑在我自己的基线和一份「能跑但结论不可信」的历史配置上:
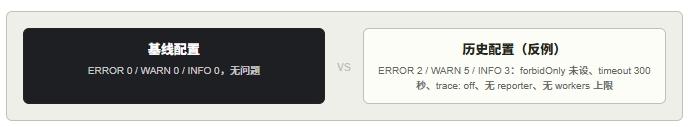
两条 ERROR 都不是风格问题,而是「结论会失真」的问题:没有 forbidOnly,.only 随时可能带着一条用例进 CI;timeout 拉到 300 秒,任何失败都会以「超时」的样子出现,你再也分不清是页面慢了还是功能坏了。
再看真实回归。8 条用例跑出:2 通过、6 失败、1 偶发,耗时 83.1 秒。聚类脚本把 6 条失败压成 4 个根因签名:
3 次 · assertion
签名 expect(locator).toHaveText(expected) failed —— 断言未成立:看 trace 里页面实际状态,区分产品回归与断言写错。
1 次 · locator-strict
签名 strict mode violation: getByText(
1 次 · timeout
签名 TimeoutError: locator.click: Timeout 3000ms exceeded. —— 操作等待超时:先查定位器还能不能命中。
1 次 · env
签名 page.goto: net::ERR\_CONNECTION\_REFUSED at
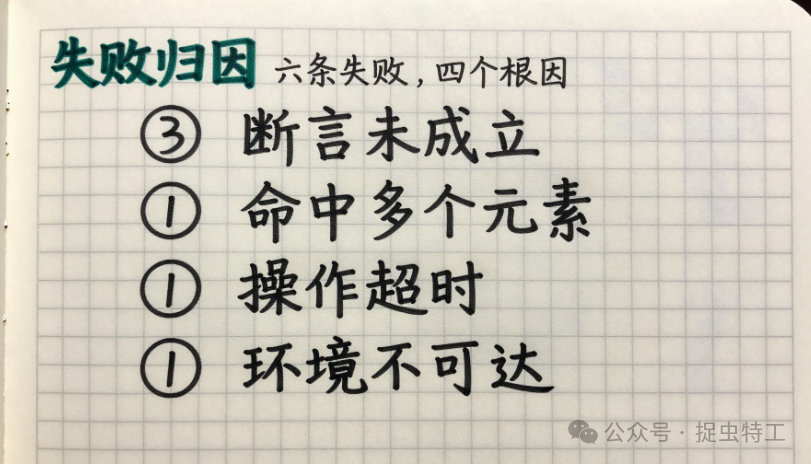
— 失败按签名聚类:6 条失败压成 4 个根因
这里省下来的不是打字时间,而是判断路径:6 条失败如果要逐条看,光读错误栈就得二十分钟,而且很容易把 3 条同源失败当成 3 个 bug 分别派给 3 个人。聚类之后只剩 4 个签名,工作量直接对上「4 个人去查」。
一点可复现的说明:这份演示回归没有依赖任何外部服务。用例用 page.setContent() 现场造页面,所以离线也能跑;配置里只把 actionTimeout 压到 3 秒(短于用例超时),目的是让「操作超时」先暴露,而不是被整条用例超时盖住。能离线复现,意味着这套检查可以随 Skill 一起分发,别人拉下来就能验证,不需要先搭一套环境。
顺带把规模边界也说清:这是一份用来验证脚本自身的最小回归,页面是自造的、用例只有 8 条。真实项目接入时,得先拿自家代码库跑一轮基线,把 WARN 阈值校准到实际水平——否则第一次开门的误报量会劝退所有人。
顺便说清三个脚本在 CI 里的分工,它们不是一个东西:
python scripts/check_config.py playwright.config.ts # 跑之前:配置基线是否可信

python scripts/lint_spec.py tests/ # 合入前:ERROR 必须为 0

python scripts/summarize_report.py test-results/report.json # 跑之后:失败归因与派活
配置体检放在最前面,是因为它错的时候后面全是白干;用例扫描挂 pre-commit 或 PR 检查;报告聚类挂在失败任务里,产物直接当工单的附件。
这也是第三天最值钱的收获:归因不该由模型现场判断,而应该是一条可复现的规则。同一条错误签名出现多少次、属于哪一类、下一步该谁做什么,全部由脚本给出。
当然,第三天的脚本也不干净,又被打了一次脸,而且是最隐蔽的那种。
缺陷 4 断言失败被归成了「超时」
第一版聚类输出里,3 条 toHaveText 断言失败全被判成 timeout。我一开始以为是判定顺序问题——Playwright 的断言失败消息里确实也含 waiting for,容易和操作超时混。改了判定优先级(从最具体到最泛)之后,结果没变。
只好把报告里的原始消息打出来看,真相是:
Error: \x1b[2mexpect(\x1b[22m\x1b[31mlocator\x1b[39m\x1b[2m).\x1b[22mtoHaveText...错误消息里带着 ANSI 颜色转义。我的判定正则写的是 Error: expect\(,而真实文本是 Error: 紧跟一串控制字符再跟 expect(,永远匹配不上。更糟的是,我在签名里清洗了 ANSI、在判定里没清洗——同一份文本被两种清洗度处理,于是签名看着正常、归因全歪。
修法一句话:判定与签名必须吃同一份清洗后的文本。修完之后的输出才是可信的(就是上面那张表)。到这里,三个脚本、两份样例集、一份真实报告,构成了完整的验证闭环。
06 PART SKILL.md 怎么写,才有人真的用
入口文件决定 Skill 会不会在该触发的时候触发
最后一天剩下的时间花在入口文件上。SKILL.md 是唯一常驻上下文的文件,它决定这个 Skill 会不会在该触发的时候触发。
- description 里要写「什么时候不用」和「不做什么」。只写能做什么,触发面会失控:用户让你写单元测试、跑真机、整理测试数据,它也会自信地接活。所以我的 description 明确写了三句:不负责搭建被测应用、不替代官方 planner/generator/healer、不自动提交修复。
- 工作流要短到能记住。我的入口只留四步:定骨架 → 写定位与等待 → 过断言纪律 → 过门禁(跑两个脚本,ERROR 清零)。每一步指向具体的 reference 文件,而不是把内容抄进入口。
- 硬规则要能一眼判定违反。七条硬规则每条都是一句「No」,不含「尽量」「建议」。因为硬规则后面会变成扫描器规则——写不成「No」的规则,也写不成正则。
- 输出契约里加一条非常规要求:交付时必须给出「每条用例证明了什么」的一句话说明。这条要求逼着写用例的人回到「主张」,实测比任何「请写高质量用例」的嘱咐都管用。
- 目录树放进入口文件尾部。这是 progressive disclosure 的关键:模型看到目录,才知道有哪些资源可以按需加载;看不到,等于这些文件不存在。
07 PART 三天下来最值钱的三件事
写文档一天,让规则生效两天
三天的时间分布其实很不均匀,值得摊开看:
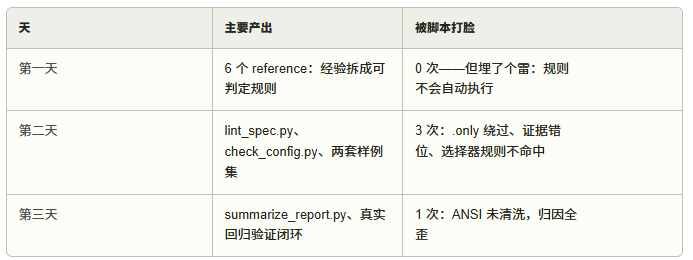
写文档只花了一天,剩下两天全用在「让规则真的生效」上。这个比例本身就是这篇文章最想说的结论。
回看这三天,架构本身其实一眼就能画出来,真正花时间的是三件「不写就不知道」的事:
- 规则要可判定。「用例要稳定」「断言要有意义」这类话,写一百遍也不会改变任何一次提交。能改变行为的是「判据 + 反例 + 检查点」,以及最后落地成一条正则。凡是说不清「违反时长什么样」的规则,都是好听话。
- 门禁要有阻断力。只有 WARN 的检查等于没有检查。ERROR 必须让脚本以退出码 1 结束,这样它才能挂进 CI;WARN 存在的意义是提示人工确认,不是凑数量。
- 误报是最大成本。三个缺陷里有三个的半条命都是误报和漏报造成的。为了压住它们,我建了两份样例集:一份装满坏味道,一份装满陷阱。门禁的公信力是它唯一的资产,一次冤枉就够把它废掉。
还有一条边界要讲清楚:这个 Skill 解决的是端到端用例的判断与门禁,不适用于单元测试、纯接口契约测试、需要真机的移动端原生测试。它也不替你做决定——它只保证「没有按团队标准检查过的用例,进不了主分支」。
如果你也在写 Playwright 用例,可以先不写 Skill,直接从最小的那两步开始:把「一律不许出现」的三条写法写成扫描规则,把失败按签名聚类再派活。这两件事做完,你会很清楚自己团队的判断标准到底缺在哪——那份缺口,才是 Skill 真正该写进去的东西。
END 三天全记录 · 结案
这篇没有教你写 Playwright 用例——官方 agent 做得比我好。它记录的是另一条路:当生成已经免费,验收就是剩下唯一值钱的事。
文中所有数据都来自本机实测:8 条用例的演示回归、2 通过 6 失败 1 偶发、6 条失败聚成 4 个签名,脚本和样例集随文可复现。
写文档一天,让规则生效两天——这个比例才是全文结论。
文中脚本、配置与样例集均为本机实测产物,Playwright 版本为 1.63.0;
跨 frame 定位、locator.visible()、retryStrategy、AbortSignal 等 API 的版本标注以官方 release notes 为准。
觉得内容不错?我要