
中国移动实测昇腾950DT-首份第三方实测数据,非摩尔补摩尔的胜利
本文来源: 老郑(公众号:老郑)
原文链接: https://mp.weixin.qq.com/s/I4f4kAQ1m8F_l_ppF8yTJw
发布时间: 2026-11-19 12:57
作者: 老郑 发布时间: 2026-11-19 12:57
任总说:“芯片问题其实没必要担心,用叠加和集群等方法,计算结果上与最先进水平是相当的。”“用非摩尔补摩尔,用数学补物理,利用集群计算补单芯片”,
一句话导读:11月18日,一份题为《昇腾950DT性能测试与经营效益测算汇报》的中国移动内部材料在算力圈流传。10月10日,中国移动六个部门组建联合团队,赴华为练秋湖研发中心,用64卡950DT超节点实测智谱GLM5.2与DeepSeek V4 Pro两个模型的极限吞吐——结论是:64卡超节点的Token产能等效400卡910B服务器;推理性能达910C的3-5倍、约910B4的11倍以上;推理性价比约910B4的3倍;对标英伟达H200约为其86%。这是"买家"亲自上手验货的第一手数据。
汇报封面|图源:中国移动《昇腾950DT性能测试与经营效益测算汇报》(2026年10月)
一、谁测的、怎么测的:买家上门验货
这份材料的分量,先看测试方:规划技术部、政企客户部、算力运营中心、产品运营中心、数智化部、南京分公司组成联合团队,10月10日前往华为练秋湖研发中心现场测试。发布会上的跑分由"卖货的"报数,这张表是"掏钱的"自己出的题——测试逻辑本身比数字更有分量。
测试配置写得非常实:64卡950DT超节点、灵衢(UnionTech)互联、Atlas 950 PoD液冷服务器;模型统一vLLM推理框架、PD分离部署;量化精度GLM5.2用W4A4C8、DSV4-PRO用W4A8C8;压测工具是开源的aisbench。测试用例取自生产环境常用的三组序列长度:7K/2K(知识库)、16K/2K(内容分析)、128K/1K(超长文本),长序列另加一组cache命中率90%的测试。
时延约束卡着生产红线:7K/2K要求P90的TTFT≤4秒、TPOT≤35毫秒;16K/2K放宽到TTFT≤6秒;128K/1K两组无时延要求,测的是系统最大吞吐。
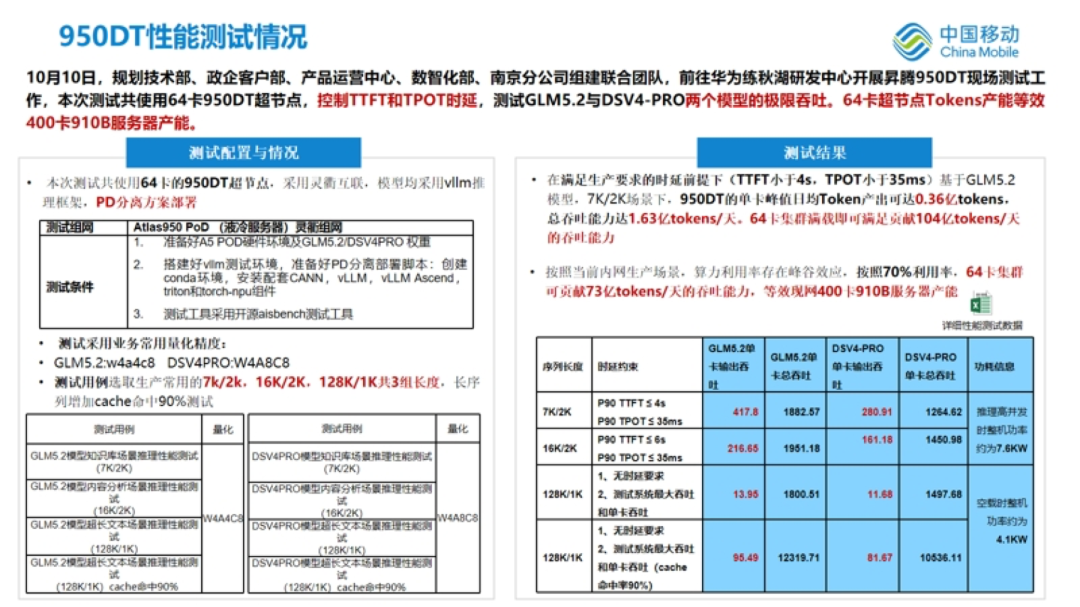
核心页|950DT性能测试情况:左为测试组网与条件,右为测试结果|图源:中国移动内部测试汇报
二、实测结果:四组场景,两个台阶
| 场景 | GLM5.2输出/总吞吐 | DSv4-PRO输出/总吞吐 |
|---|---|---|
| 7K/2KTTFT≤4s·TPOT≤35ms | 417.8 / 1882.57 | 280.91 / 1264.62 |
| 16K/2KTTFT≤6s·TPOT≤35ms | 216.65 / 1951.18 | 161.18 / 1450.98 |
| 128K/1K无时延要求 | 13.95 / 1800.51 | 11.68 / 1497.68 |
| 128K/1Kcache命中90% | 85.49 / 12319.71 | 81.67 / 10536.11 |
单位:tokens/s。斜杠前为输出吞吐,斜杠后为总吞吐(含输入)。高并发时整机功率约7.6kW,空载约4.1kW。
读数一:长序列的账,其实是cache的账。同样是128K/1K,把cache命中率提到90%,GLM5.2总吞吐从1800跳到12320——6.8倍。命中90%意味着九成前缀不必重算,prefill的账直接省掉。这组数字落到中国移动9月底发布的20480卡超节点集采里,就是硬条款:KV Cache动态卸载、按索引复用是不满足即废标的星号条款。
读数二:产能折算是"替换账"。7K/2K场景下单卡峰值日均Token产出约0.36亿,总吞吐口径1.63亿tokens/天;64卡满载即104亿tokens/天;按内网生产峰谷效应打七折(70%利用率),可用产能约73亿tokens/天——这就是"等效400卡910B"的出处。注意:910B侧的测试口径(什么模型、什么时延约束)图上没有标注,这是运营商按现网利用率折算的替换账,不是同口径性能对比。
三、11倍从哪来:单卡没赢满,赢的是系统
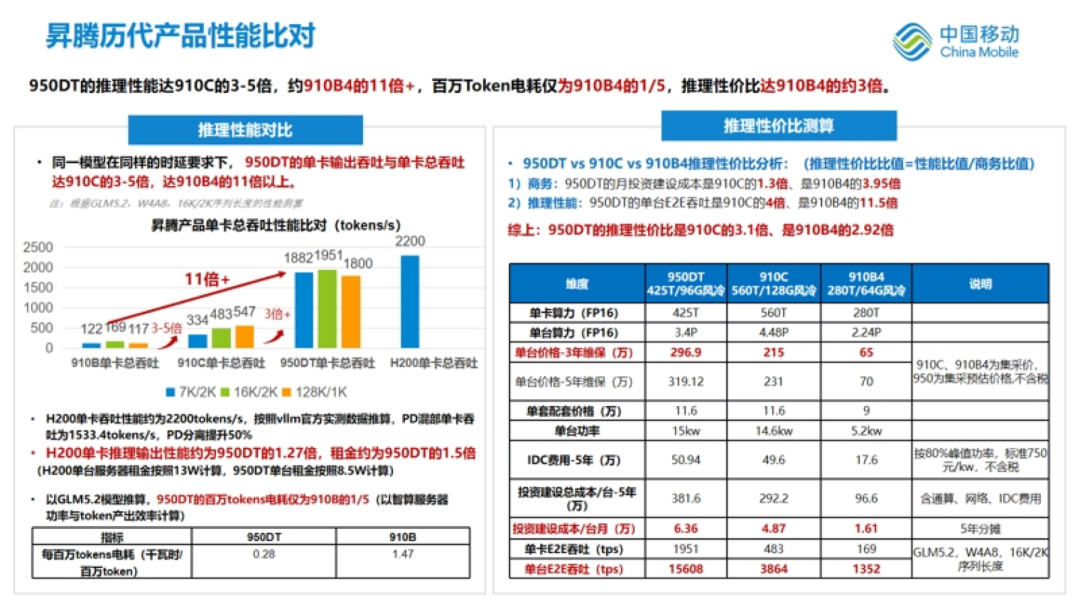
同一模型、同样时延条件下,950DT的单卡输出吞吐与单卡总吞吐达910C的3-5倍、910B4的11倍以上。柱状图里量级差了一整个台阶:910B单卡总吞吐122 tokens/s,910C在109-117之间,950DT落在1882-1951。
昇腾历代产品性能比对|图源:中国移动内部测试汇报
左侧柱状图按三组长度对比910B、910C、950DT与H200;右侧拆解性能比值与商务比值
H200是图里唯一的英伟达参照:单卡总吞吐约2200 tokens/s,看起来比950DT还高。汇报做了两层校准:按vLLM官方实测数据折算,H200在PD混部下约1533.4 tokens/s、PD分离后提升约50%;再按GLM5.2模型比较,950DT的推理性能约为H200的86%,而租金按8.5万/月对13万/月算,性价比反超约30%。能效上,950DT每百万Token电耗约0.28千瓦时,仅为910B(1.47)的约1/5。
关于"86%"要拆开读:同一张卡,公开渠道出现过三个不同的数——测试材料转述是86%(16K/2K口径约89%、7K/2K口径约82%);科大讯飞刘庆峰的公开说法是65%-85%区间(不同任务不一样);另有转载测算按"H200单卡推理输出约为950DT的1.27倍"倒推约79%。三个数口径不同,谁也没推翻谁。另外,H200的数字是按vLLM数据估算的,不是同场同卡实测;"11倍"则是隔着一代硬件、上一代基数低,看趋势可以,当横向战报就夸张了。
把公开规格摆到一起看更清楚:950DT单卡FP8算力大约是H200的一半、内存带宽4TB/s对4.8TB/s,也没到。真正拉开差距的地方在系统层——Atlas 950 SuperPoD最大1024卡高速互联、256TB统一内存编址、官方口径端到端时延3微秒,靠全光互联把卡捏成整体。看AI算力卡只盯单卡参数,会看丢一半。
四、性价比=性能÷商务:6.36万一台月的定价线
这份材料最不常见的地方,是把技术参数和经营模型摆在一起算。"性价比高3倍"不是一句宣传,是一条明确的算式:性价比比值 = 性能比值 ÷ 商务比值。性能上,950DT单台E2E吞吐是910C的4倍、910B的11.5倍;商务上,月均投资建设成本是910C的1.3倍、910B的3.95倍。两组相除,得推理性价比约为910C的3.1倍、910B4的2.92倍。
| 口径 | 950DT | 910C | 910B4 |
|---|---|---|---|
| 单卡算力(FP16) | 425T | 560T | 280T |
| 单台价格·3年质保 | 296.9万 | 215万 | 65万 |
| 单台功率 | 15kW | 14.6kW | 5.2kW |
| 5年建设成本/台 | 381.6万 | 292.2万 | 96.6万 |
| 折合每台月 | 6.36万 | 4.87万 | 1.61万 |
| 单卡E2E吞吐 | 1951 | 483 | 169 |
| 单台E2E吞吐 | 15608 | 3864 | 1352 |
吞吐口径:GLM5.2、W4A8、16K/2K序列长度;910C与910B4为集采价,950DT为集采预估价,均不含税;5年建设成本含配套、通信、网络与IDC费用。
这张表里有个容易被忽略的事实:950DT的单卡算力425T其实低于910C的560T。真正拉开差距的是单卡E2E吞吐1951对483——软件栈、并行策略和PD分离部署把纸面算力兑现成了实际产能。算力规格在这里不是决定性变量。
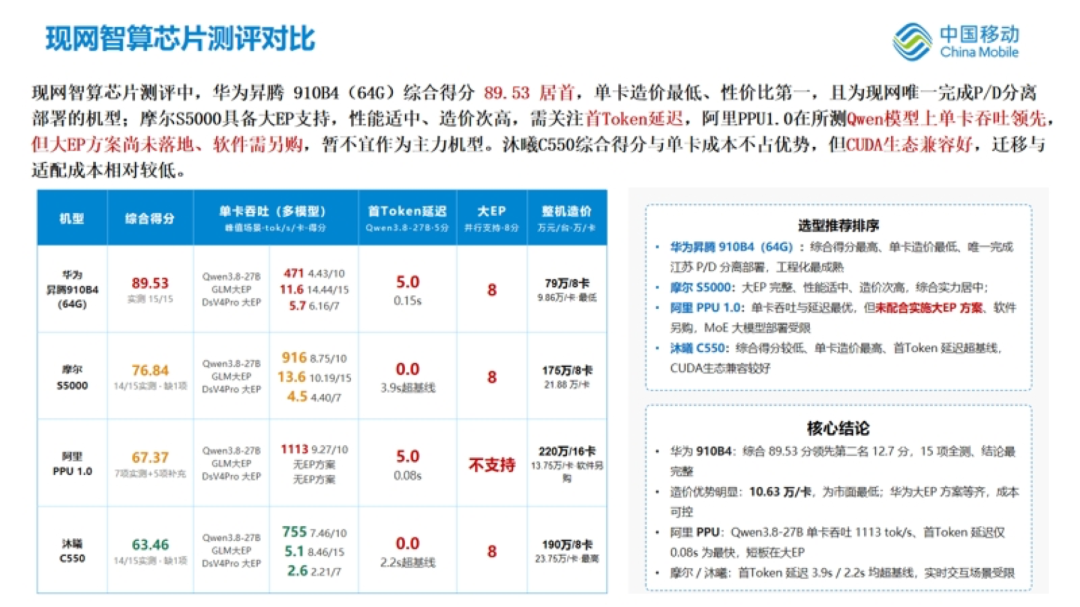
950DT投资回报效益测算:左为投资成本与裸金属定价,右为Token定价收入测算|图源:中国移动内部测试汇报
定价线画得很清楚:按风冷配置,950DT单台含税建设成本约381.66万,分摊5年约6.36万/台月;裸金属定价需高于8.4万/台月才能满足10%收益率;综合建议价风冷7.95万、液冷8.06万(含税裸金属定价建议8.43万与8.55万)。液冷与风冷的定价建议只差0.12万——散热差异被5年分摊摊薄,选哪种更多取决于机房条件。
同一张卡,跑不同模型,经营结果完全相反——这是整份材料最值得读的部分:
GLM5.2:走得通。单台950DT至少对外销售272.5亿Token/月,Token收入才能持平裸金属收入(盈亏平衡);按用户客观使用习惯,单台最大产能约325.7亿Token/月,Token计费收入可达约10万/台月,较裸金属提升约18.6%。
DSv4-PRO:打不平。DS系列官网定价较低,按相同产能测算,token计费收入比裸金属低约34%;即便跑到最大产能,单台月收入也只有约5.6万,覆盖不了6.36万的成本——汇报直接结论:基于DS的token业务无法商业闭环。先定模型,再算产能和单价,这个顺序比任何倍数都值钱。
五、彩蛋:现网横评里,910B仍排第一
材料还附了一张现网智算芯片横评表,结论有点出人意料:华为昇腾910B4(64G)综合得分89.53居首,领先第二名12.7分——15项全测,还是现网唯一完成P/D分离部署的机型。摩尔S5000得76.84分,具备大EP支持、性能适中,但首Token延迟3.9秒超基线;阿里PPU1.0单卡吞吐1113 tok/s、首Token延迟仅0.08秒两项领先,却卡在大EP方案未落地、软件需另购;沐曦C550得63.46分,CUDA生态兼容好、迁移成本低,但综合得分与单卡造价不占优。
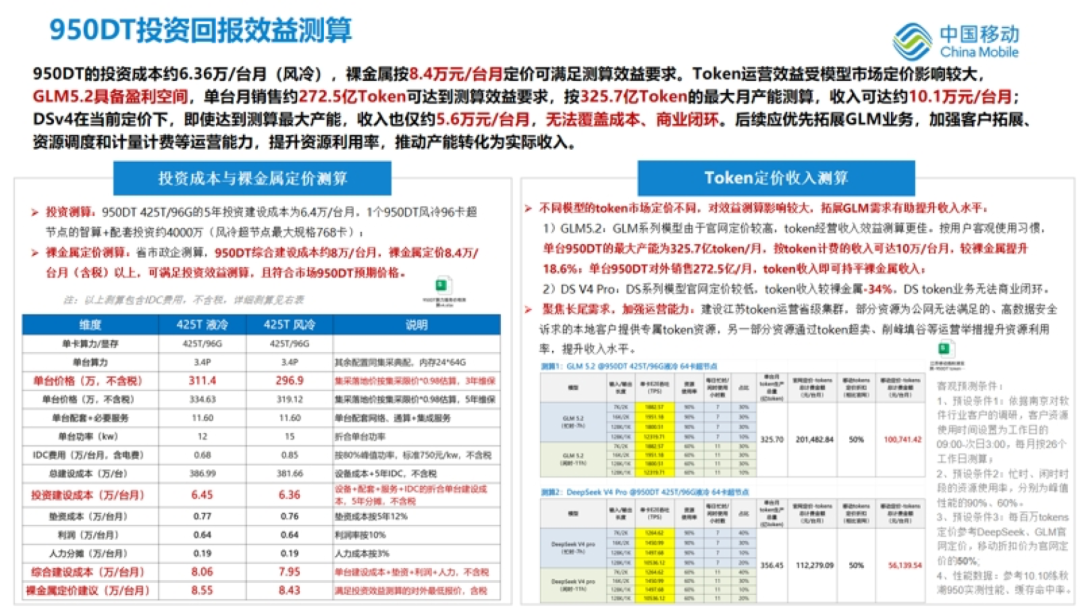
现网智算芯片测评对比:按综合得分、单卡吞吐、首Token延迟、大EP支持与整机造价打分|图源:中国移动内部测试汇报
读法:单卡吞吐、首Token延迟、大EP支持、整机造价,四项很难同时拿满。910B排第一靠的不是某一项极值,而是"15项全测+唯一完成PD分离部署"的工程确定性。跑分高和能上线,是两件事——这也是950DT的现实门槛:纸面性能领先,还得把部署这条链走完,才算真正进了现网。
六、怎么读这份材料:三个判断,五个提醒
判断一:验货方式变了。买家拿真实模型、真实时延要求、真实业务场景去现场测,卡好不好由"出了多少词"说了算——算力的账越来越像水电费,按产出结算。运营商算的是替换账:一天产多少token,能顶掉多少存量卡。
判断二:竞争的计量单位已从单卡TFLOPS切换为超节点Token产能。950DT的定位不是在单卡规格上全面超越H200,而是在制程受限前提下,靠能效(百万Token电耗1/5)、集群吞吐、Token成本控制拿到具备竞争力的经济性。
判断三:背面是采购与交付。中国移动2026-2027年新一代人工智能超节点集采(20480卡)10月28日已公示五家整机厂中标候选、总金额约117亿元,其中神州鲲泰中标2048卡(13.17亿元),装的正是950DT;湖北科投的1024卡液冷超节点10月29日在武汉上线。从测试到规模供货(官方口径今年底或明年初),中间还隔着工程周期。
五个提醒(引用这份数据前先看这里):
1、孤证:目前没有原始报告全文,也没有第二家机构发布同一份数据,截图属二手流传;
2、考场在卖家家里:测试场地是华为练秋湖研发中心,工具链也是华为侧的,部署到自己机房后数字会不会打折是另一道题;
3、三样没测:训练侧、长稳跑、真实负载,材料都没给;
4、"等效400卡910B"口径:910B侧测试条件未标注,是替换账不是同口径对比;
5、图上没有任何英伟达对比:网传"约H200的83%"为博主个人估算,材料原文是86%(且H200数字为vLLM推算)。
要不要上950DT,这份材料给的不是一句"好"或"不好",而是三个必须同时成立的条件:时延红线内跑得出目标吞吐、单台月成本能被定价覆盖、选的模型能把token卖到保本量以上。三条都满足,11倍性能才是真收益。
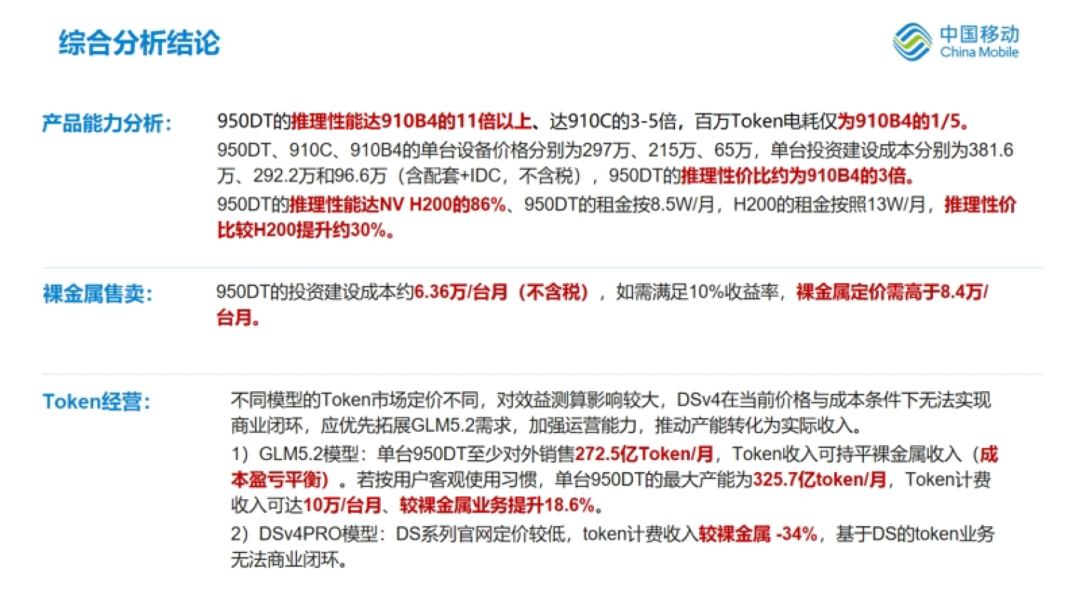
汇报的综合分析结论页:产品能力分析、裸金属售卖、Token经营三段并列|图源:中国移动内部测试汇报
资料来源:中国移动《昇腾950DT性能测试与经营效益测算汇报》(2026年10月,内部测试汇报截图,为汇报方口径、未经独立复测);Infra研习社《64卡跑出400卡910B的产能,昇腾950DT的账要分开算》;ChainCatcher、MaxForAI 相关报道;公开报道与厂商官网信息。文中全部性能与价格数字均出自该汇报口径,价格类数字为集采价或预估价、不含税。
本文转载自微信公众号「老郑」,仅供学习交流使用。
觉得内容不错?我要