
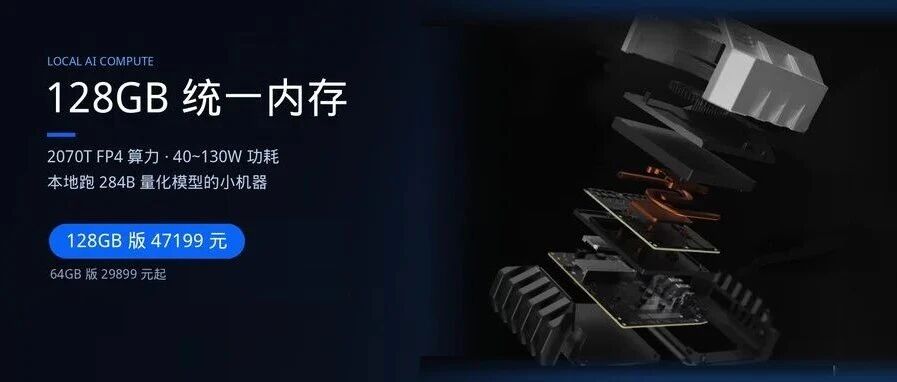
128GB 统一内存的本地 AI 小机器:能跑 284B 量化模型,64GB 版 29899 元起
本文来源: nankle的分享(公众号:nankle的分享)
原文链接: https://mp.weixin.qq.com/s/oulBGNCPpD2JQL6Fn7A1OA
发布时间: 2026-10-26 05:30
作者: nankle的分享 发布时间: 2026-10-26 05:30
最近一年,能本地跑大模型的「小盒子」明显多了起来。苹果 Mac Studio、AMD 的 AI Max+ 395、英伟达 DGX Spark,走的是同一条路:把 CPU、GPU 和内存放进一个统一的内存池,靠大容量把模型装下来。
这台是懒猫 AI 算力舱,型号 X5,有两个配置。它不算便宜,所以这篇不吹,主要把参数、价格和同类放一起,供参考。
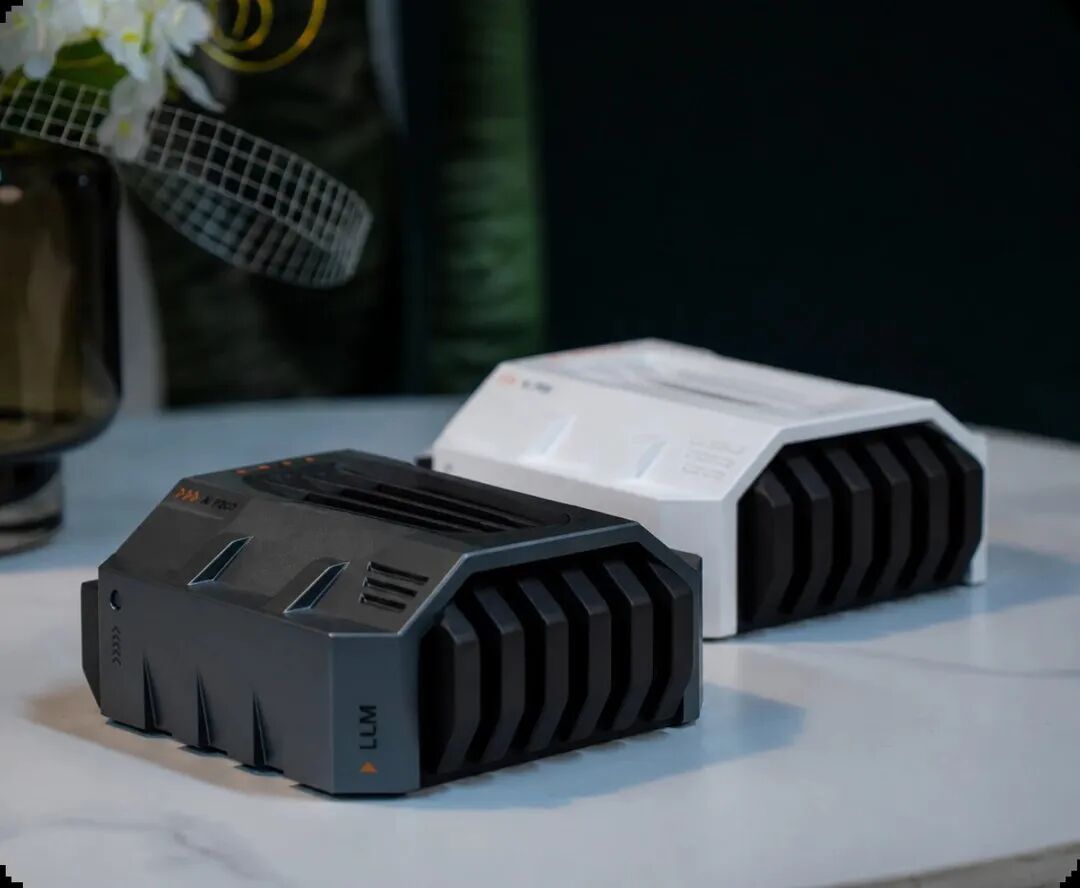
官方图:太空白和星辰灰两个配色,144 × 130 × 61 mm,2.3 kg
先看核心参数
X5-T5000 关键规格
FP4 算力
2070T
官方峰值,口径未注明
统一内存128GBLPDDR5X 256-bit
内存带宽
273GB/s
与 DGX Spark 同标称
模型规模
284B
总参数 284B / 激活 13B
模组功耗40~130W官方标称范围
机身2.3kg144 × 130 × 61 mm
注意,2070T 是 FP4 精度的峰值,官方没注明是否含稀疏;它不是日常生成 token 的速度。真正跑模型快不快,后面会拆开讲。
两个型号,价格差了一万七
两个配置的官方标价
64GB 版
X5-T4000
29899 元
· 1200T FP4 算力
· 64GB 统一内存
· 12 核 Arm CPU
· 40~70W 功耗
128GB 版
X5-T5000
47199 元
· 2070T FP4 算力
· 128GB 统一内存
· 14 核 Arm CPU
· 40~130W 功耗
官网写「29899 元起」,对应的是 64GB 的 T4000;128GB 的 T5000 在商品页标价 47199 元。两个型号外观一样,主要差在 GPU 核心数、CPU 核心数、内存容量、光口速率和功耗上限。
| 项目 | X5-T4000 | X5-T5000 |
|---|---|---|
| 算力 | 1200T | 2070T |
| 内存 | 64GB LPDDR5X | 128GB LPDDR5X |
| GPU | 1536 核 Blackwell / 6 TPC | 2560 核 Blackwell / 10 TPC |
| CPU | 12 核 Neoverse-V3AE | 14 核 Neoverse-V3AE |
| 光口 | 最高 75Gbps(3×25GbE) | 最高 100Gbps(4×25GbE) |
| 功耗 | 40~70W | 40~130W |
| 价格 | 29899 元 | 47199 元 |
完整的 GPU、CPU、存储和接口参数在官网参数页,这里只挑影响选择的几项。
统一内存,解决的到底是什么问题
传统独显跑大模型,模型权重得先塞进显存。消费级卡常见 16GB、24GB、32GB,70B 的模型量化后都可能不够,更别说 200B 以上。装不下怎么办?要么多卡,要么把一部分放内存里来回搬,速度会掉得很难看。
统一内存的思路是:CPU 和 GPU 共用同一块 LPDDR5X,没有独立的显存上限。机器有 128GB,模型权重、KV cache、系统占用都在这个池子里分。好处是「能装下」,代价是 LPDDR5X 的带宽比不上 GDDR7 和 HBM。
容量决定模型能不能装下
↓
带宽决定单路生成速度的上限
↓
算力
决定预填充、并发和微调速度
↓
量化决定同样的内存能装多大参数
拿官方说的 DeepSeek-V4-Flash 284B 举例。284B 是总参数,MoE 激活 13B。按 4bit 粗算,全部权重约 142GB,128GB 其实装不下;官方只写「284B 量化大模型」,没公布具体比特数,大概率用了更低的混合精度才塞进去。MoE 每次只读激活的那部分,假设等效 3.5bit,13B 激活每生成一个 token 大约要读 5.7GB 权重;273GB/s 除以 5.7GB,理论上限约 48 token/s。官方标的是双并发合计 63 token/s(折合单路 31.5),考虑 KV cache、调度和带宽利用率,这个量级是对得上的。
※所以看这类机器,别只盯 2070T。先看内存够不够装你要的模型,再看带宽能跑出多少 token/s,最后才看算力峰值。
和另外三条路线比一比
同样走统一内存的,目前主要是这几类。参数来自各家官网或公开规格页,价格随渠道和配置变化,只作量级参考。
内存带宽(GB/s,官方标称)
带宽决定单路生成速度上限;Mac 取 M3 Ultra 口径
Mac Studio M3 Ultra819
X5-T5000273
DGX Spark273
AMD AI Max+ 395256
FP4 算力峰值(T,官方口径)
两家都按官方峰值列;是否含稀疏未统一标注,只看量级
X5-T50002070
DGX Spark1000
功耗上限(W,条越短越省电)
均为芯片或模组 TDP,不是整机墙插功耗
AMD AI Max+ 395120
X5-T5000130
DGX Spark(GB10)140
机型X5-T5000
统一内存128GB / 273GB/s
AI 算力2070T FP4
功耗口径40~130W
参考价47199 元
机型DGX Spark
统一内存128GB / 273GB/s
AI 算力1000T FP4
功耗口径芯片 140W
参考价约 6950 美元(2026-10)
机型AMD AI Max+ 395
统一内存128GB / 256GB/s
AI 算力约 60 TFLOPS FP16
功耗口径120W
参考价整机约 2000~3999 美元
机型Mac Studio M3 Ultra
统一内存最高 512GB / 819GB/s
AI 算力未标 FP4
功耗口径整机口径
参考价数万元起
这张表能看出各自的取舍:Mac 带宽最高、内存上限最大,但价格也最高;AMD 平台便宜、x86 生态成熟,但走 ROCm,FP4 不是它的强项;DGX Spark 和这台算力舱都是英伟达 Blackwell + Arm 的统一内存方案,内存容量和带宽标称一致。按 2026 年 10 月官网价,DGX Spark 128GB 已经涨到 6950 美元,按 1 美元约 7.1 元折算,和这台 47199 元在同一档;它的优势是 DGX OS 软件栈和 ConnectX-7 双机互联,但 FP4 峰值是 1000T。
多台互联,能叠加到什么程度
官方页面写的是「支持 vLLM 和多台组网,可按需扩展本地 AI 算力」,FAQ 里还有一句「通过局域网组网,算力可以无限叠加」。从接口看,T5000 有一个 QSFP28 光口,最高 100Gbps(4×25GbE),T4000 是 75Gbps(3×25GbE),确实预留了多机互联的通道。
但「多台互联」和「内存池合并」不是一回事。它走的是局域网/以太网,不是 NVLink;多机跑一个大模型,需要 vLLM 之类的框架做张量并行或流水并行,实际能扩到几台、效率怎么样,官方没给公开数据。买之前最好问清楚支持几台、用什么拓扑、有没有实测 token/s。
※一句话:支持多台组网是官方明确写的,但「无限叠加」是宣传口径,别按「插上网线就变成 256GB 统一内存」理解。
CUDA 生态,是它价格的一部分
这台机器用的是 Ubuntu + CUDA,官方说预装驱动和 AI 环境,支持 vLLM、Ollama、ComfyUI、Jupyter。对用过英伟达卡的人来说,这意味着模型下载下来大概率能直接跑,不用等 ROCm 或 MLX 适配。
「官方页面原话:非英伟达 CUDA 的 AI 芯片,AI 性能只是硬件理论跑分值……实际 AI 算力要打折 50% 左右。」
这话有营销成分,不能当实测结论。但生态差距确实存在:AMD 走 ROCm,苹果走 MLX,能跑,只是部分新模型要等适配。买这类机器,软件时间成本要算进去。
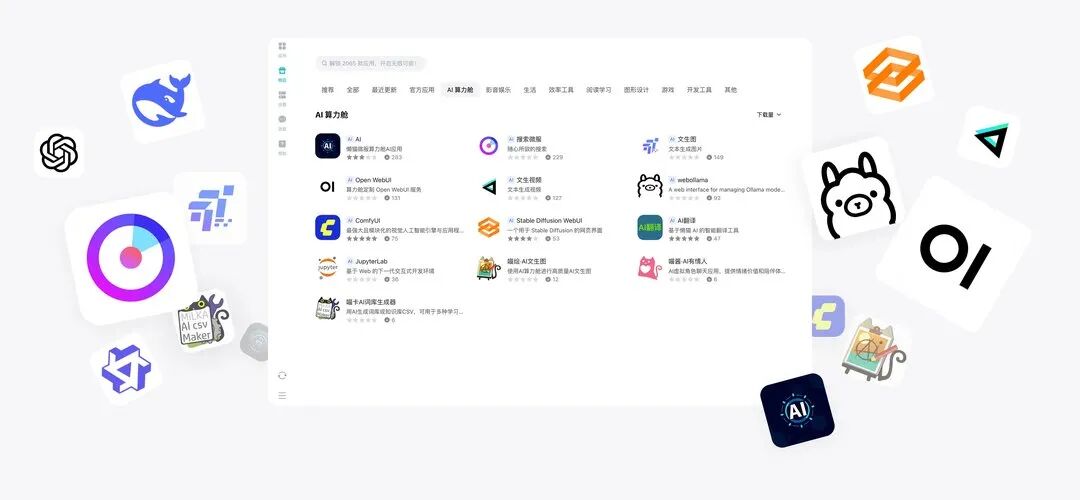
官方应用商店截图:AI 应用按下载量排,Ollama、ComfyUI、JupyterLab 都在里面
不过要注意,官方 FAQ 里还有一句:这些一键安装的 AI 应用需要配合懒猫微服使用。单买算力舱,它就是一台 Ubuntu 主机,插上键鼠显示器可以自己折腾;想要官方那套一键应用、内网穿透和手机远程调用,得再加微服,这些自己也能配,只是要花时间。
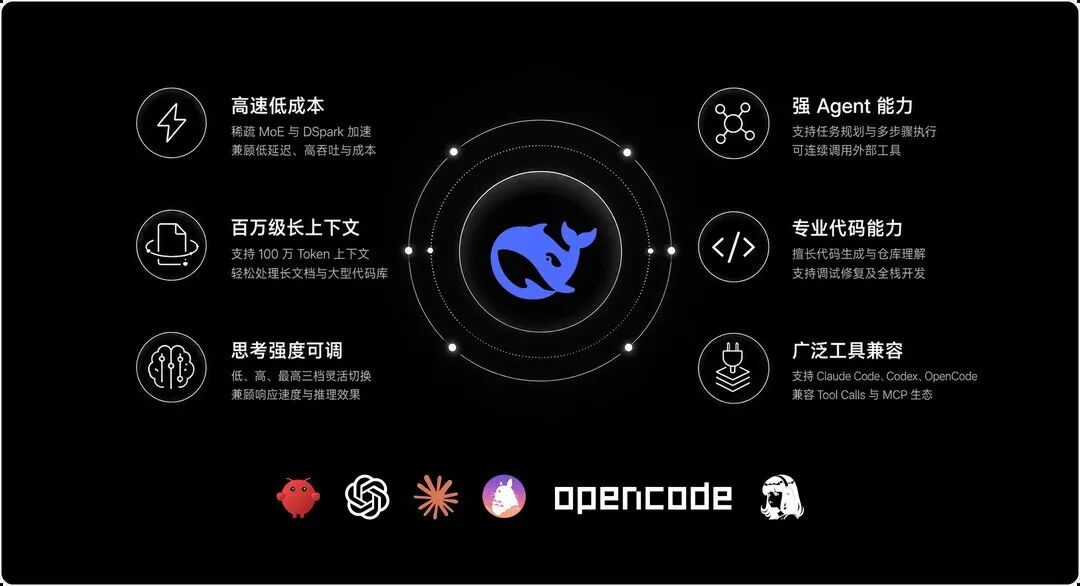
官方图:DeepSeek-V4-Flash 284B 本地部署,标称双并发 63 token/s
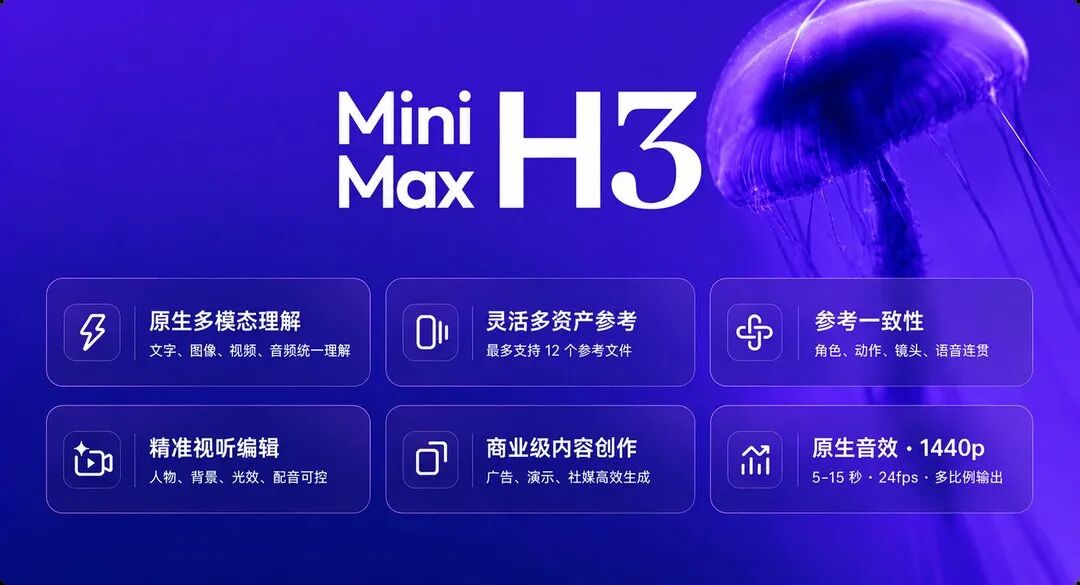
官方图:MiniMax H3-Base 全模态模型,也能在这台机器上私有化跑
官方给的场景包括:本地大模型推理、文生图、文生视频、OCR、语音合成、网页总结、音视频转文字。4 秒生成一张图、一天 2 万张电费 0.3 元这类数字,是官方口径,实际要看模型、分辨率和批量,别直接当承诺。
适合谁,不适合谁
比较适合的场景:
要跑 200B 级以上 MoE,又不想组多卡:128GB 统一内存更稳妥
数据不能出内网:代码库、合同、病历这类,本地跑更省心
需要 CUDA:vLLM、ComfyUI、Jupyter、各种 NVIDIA 轮子直接上
想给手机、平板远程加算力:配合微服的内网穿透
不太适合的场景:
只跑 7B、14B、32B:迷你主机或二手显卡更便宜
追求极致单路速度:273GB/s 不是强项,Mac Studio 的 819GB/s 更高
要玩游戏或跑 Windows 软件:这是 Ubuntu + Arm
预算卡得紧:128GB 版 47199 元不是小数目,先想清楚要跑什么模型
价格和购买前要确认的事
官网写 29899 元起,对应 64GB 版;128GB 版商品页标价 47199 元。差价 17300 元,换来内存翻倍、算力 1200T 到 2070T、光口 75Gbps 到 100Gbps、功耗上限 70W 到 130W。
如果你的目标是 284B 这类模型,64GB 版基本不用考虑;如果只跑 30B 以内,64GB 版反而更合理。别为了「以后可能用得上」多花一万七。
※购买前建议确认:1)284B 模型的具体量化格式和实际占用;2)多台组网的拓扑、支持台数和实测数据;3)售后年限、保修范围和发票类型;4)AI 应用是否必须搭配微服;5)内存是板载 LPDDR5X,不能自己加。
◆
我的看法:这类机器的价值不在于「替代显卡」,而在于把大容量统一内存、CUDA 和低功耗打包进一个能放桌面的盒子。它不适合所有人,价格也谈不上便宜,但确实给本地大模型多了一个选项。
统一内存这条路,今年应该还会有更多产品。不着急的话,可以再等等;要现在就用,先明确自己要跑的模型和预算,再决定 64GB 还是 128GB。
※本文为公开信息整理,无商家合作。参数来自品牌官网及 NVIDIA / AMD / Apple 公开规格页,价格来自商品页,可能随时间和渠道变化。
参考来源
[1] 产品页:https://lazycat.cloud/ai-pod
[2] NVIDIA DGX Spark 规格:https://www.nvidia.cn/products/workstations/dgx-spark/
[3] AMD Ryzen AI Max+ 395 规格:https://www.amd.com/en/products/processors/laptop/ryzen/ai-300-series/amd-ryzen-ai-max-plus-395.html
[4] Apple Mac Studio 规格:https://www.apple.com/mac-studio/specs/
[5] 懒猫价格为 64GB / 128GB 商品页标价;DGX Spark 取 2026 年 10 月 NVIDIA 美国商城 128GB 版价格,均仅作参考
如果觉得这篇整理有用,可以点下面的名片关注,后面还会继续分享这类本地 AI 硬件。
本文转载自微信公众号「nankle的分享」,仅供学习交流使用。
觉得内容不错?我要