
83.6K Star!Google工程总监把20年经验做成24个AI技能
本文来源: 开发者社区(公众号:开发者社区)
原文链接: https://mp.weixin.qq.com/s/v6FFhWYUevE68qTcHhi02Q
发布时间: 2026-08-08 18:57
作者: 开发者社区 发布时间: 2026-08-08 18:57
一个Chrome团队核心成员,把Google内部那套工程纪律拆成了24个AI技能包。装上之后,你的AI编程助手突然就"开窍"了——知道什么时候该写测试,什么时候该做安全审查,什么时候该停下来问你。
83.6K Star背后的痛点
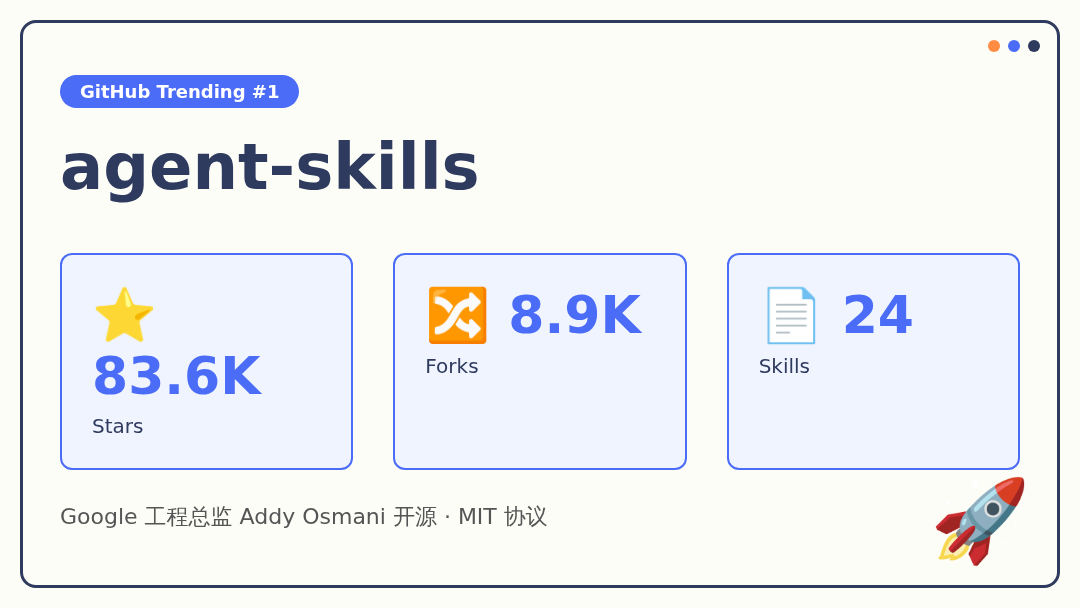
开篇配图:83.6K Star数据冲击
打开 GitHub Trending,有个项目挂了几天就冲到 83,655 Star,Fork 数逼近 9000。不是什么前端框架,也不是新的编程语言——它就是一堆 Markdown 文件。
项目叫 agent-skills,作者是 Addy Osmani。
如果你在前端圈子混过几年,这个名字不陌生。Chrome 团队的工程总监,Google Developer Expert,写了《Learning JavaScript Design Patterns》,在 Chrome 性能优化、PWA、Web 性能领域做了十几年。他的文章在 web.dev 上被几百万开发者读过。
这次他干的事情很简单:把顶级工程师那套"肌肉记忆"拆解成了 24 个结构化的 AI 技能,让任何 AI 编程工具装上之后,都能按照生产级标准来干活。
为什么这么火?因为每个用过 AI 编程的人都被坑过。
Cursor 帮你生成了一段代码,能跑。但你一看——没测试、没文档、变量名叫 temp、安全漏洞明摆着。Claude Code 帮你改了个 Bug,改完引入了两个新 Bug。Copilot 自动补全了100行,其中30行用的是三年前废弃的 API。
核心问题从来不是 AI 不够聪明。是它缺少工程纪律。
Addy 这套技能包解决的就是这个问题。
它到底是个什么东西
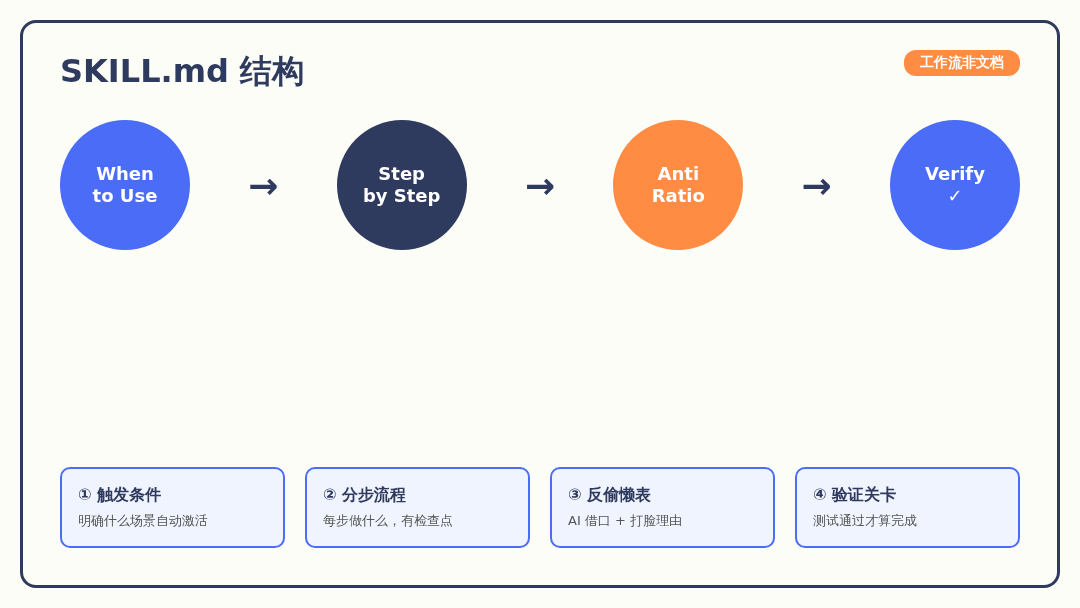
概念图:agent-skills工作原理
agent-skills 里的每个"技能",本质上是一个 SKILL.md 文件。但跟普通的 prompt 模板有本质区别——它不是参考文档,而是 可执行的工作流。
一个标准技能的结构长这样:
- Frontmatter:技能名和触发条件
- Overview:这个技能干什么
- When to Use:什么时候该自动激活
- Process:分几步走,每步做什么
- Rationalizations:AI 想偷懒时的借口 + 打脸理由
- Red Flags:什么信号说明出了问题
- Verification:必须拿出什么证据才算完成
最狠的设计是那个 反 Rationalization 表。
你想,AI Agent 写代码的时候最常说什么?"这个改动太小,不需要写测试。""我待会补文档。""这个边界情况不太可能发生。"
每个技能里都内置了一张表,把这些借口逐条列出来,配上 打脸理由。Agent 偷懒的瞬间,工作流会把它拽回来。
另一个核心原则:"看起来对了"永远不算完成。每个技能最后都有验证关卡——测试得通过、构建得出输出、运行时数据得拿到。Seems right is not done。
24个技能全览:从想法到上线
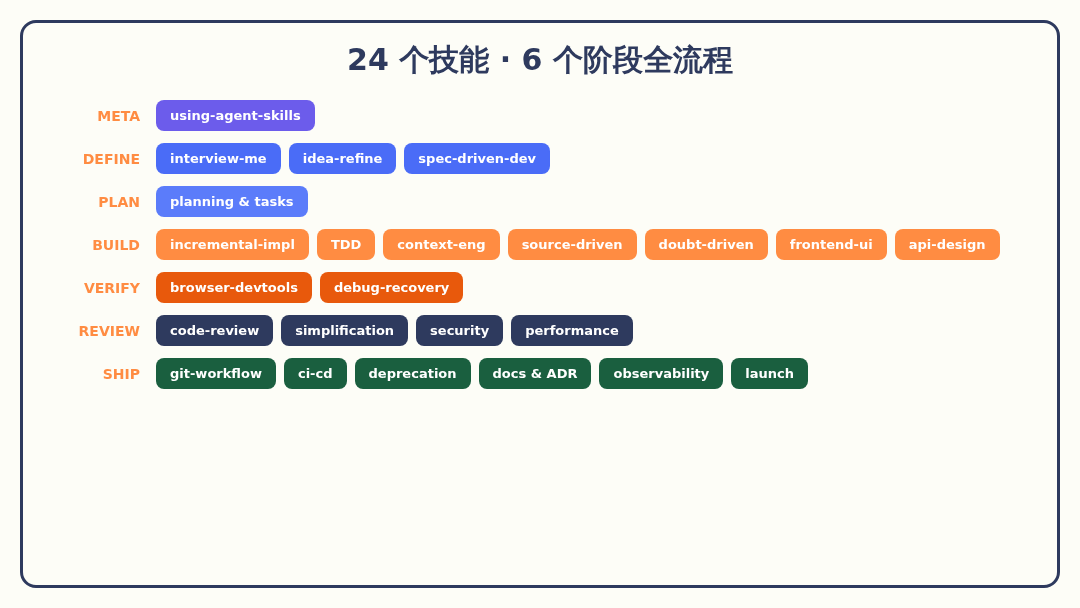
24个技能全览图
这套技能覆盖了软件开发的完整生命周期,6 个阶段,24 个技能:
元技能:自动路由
| 技能 | 干什么 |
|---|---|
| using-agent-skills | 拿到任务后自动判断该用哪个技能 |
第一步:搞清楚要建什么(Define)
| 技能 | 干什么 |
|---|---|
| interview-me | 一次问一个问题,深度追问,直到 95% 确信度 |
| idea-refine | 发散/收敛思维,把模糊想法变成具体方案 |
| spec-driven-development | 写代码前先出技术规格文档 |
第二步:拆解任务(Plan)
| 技能 | 干什么 |
|---|---|
| planning-and-task-breakdown | 把规格拆成小而可验证的任务单元 |
第三步:写代码(Build)
| 技能 | 干什么 |
|---|---|
| incremental-implementation | 薄垂直切片,实现→测试→验证→提交 |
| test-driven-development | Red-Green-Refactor,测试金字塔 |
| context-engineering | 在对的时间给 Agent 喂对的上下文 |
| source-driven-development | 每个框架决策基于官方文档验证 |
| doubt-driven-development | 高风险场景的对抗性审查 |
| frontend-ui-engineering | 组件架构、设计系统、WCAG 无障碍 |
| api-and-interface-design | 契约优先,Hyrum's Law |
第四步:证明能跑(Verify)
| 技能 | 干什么 |
|---|---|
| browser-testing-with-devtools | Chrome DevTools MCP 实时运行时验证 |
| debugging-and-error-recovery | 五步排障法,Stop-the-line 规则 |
第五步:合并前审查(Review)
| 技能 | 干什么 |
|---|---|
| code-review-and-quality | 五轴审查,变更控制在约100行 |
| code-simplification | Chesterton's Fence,Rule of 500 |
| security-and-hardening | OWASP Top 10、密钥管理、依赖审计 |
| performance-optimization | 度量优先,Core Web Vitals |
第六步:自信上线(Ship)
| 技能 | 干什么 |
|---|---|
| git-workflow-and-versioning | 主干开发,原子提交 |
| ci-cd-and-automation | Shift Left,Feature Flag |
| deprecation-and-migration | 代码即负债,僵尸代码清除 |
| documentation-and-adrs | 架构决策记录,记"为什么" |
| observability-and-instrumentation | RED指标、OpenTelemetry、症状告警 |
| shipping-and-launch | 上线清单、灰度发布、回滚流程 |
三个核心技能深度拆解
光看名字和一句话介绍不过瘾。我挑了三个最硬核的技能,带你看看 Addy 到底在里面塞了什么东西。
拆解一:spec-driven-development
spec-driven-development 流程图
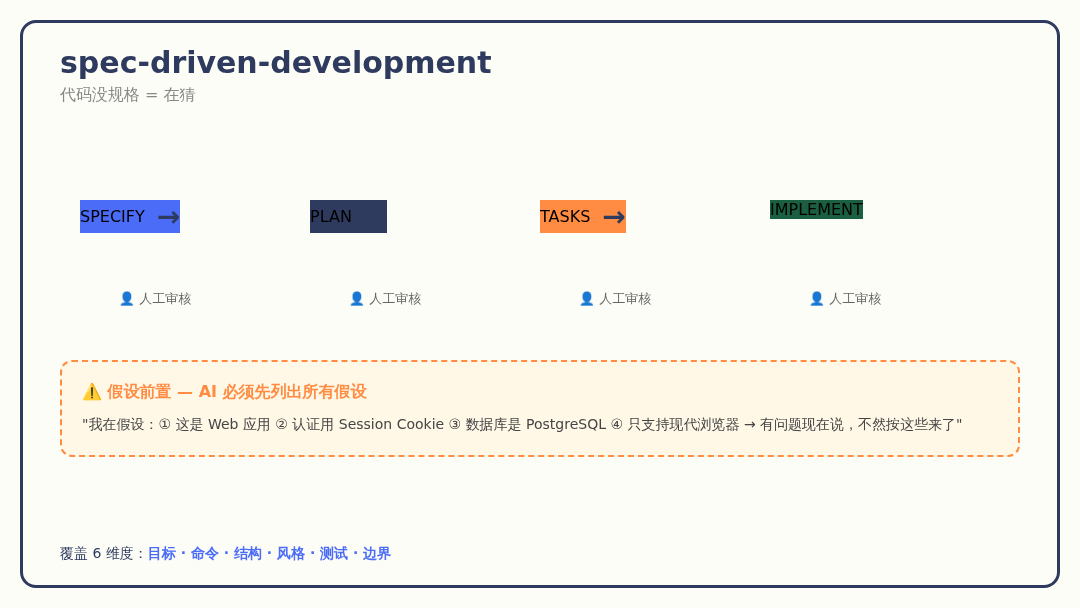
核心理念一句话:代码没规格,等于在猜。
这个技能强制 AI 在写任何代码之前,先走四个阶段,每个阶段都有 人工审核关卡:
SPECIFY → PLAN → TASKS → IMPLEMENT
  │         │       │        │
  ▼         ▼       ▼        ▼
 人工审核  人工审核 人工审核  人工审核
最妙的设计是"假设前置"。AI 在写规格之前,必须先把自己所有的假设列出来:
我在假设:
1. 这是 Web 应用(不是原生移动端)
2. 认证用的是 Session Cookie(不是 JWT)
3. 数据库是 PostgreSQL
4. 只需要支持现代浏览器
→ 有问题现在说,不然我就按这些来了
为什么这么设计?因为 AI 最危险的失败模式不是写错代码,而是基于错误假设一路狂奔。先暴露假设,成本最低。
规格文档必须覆盖六个核心维度:目标、命令、项目结构、代码风格、测试策略、边界。每个维度都有具体模板,不是让你自由发挥。
拆解二:test-driven-development
TDD Red-Green-Refactor 循环
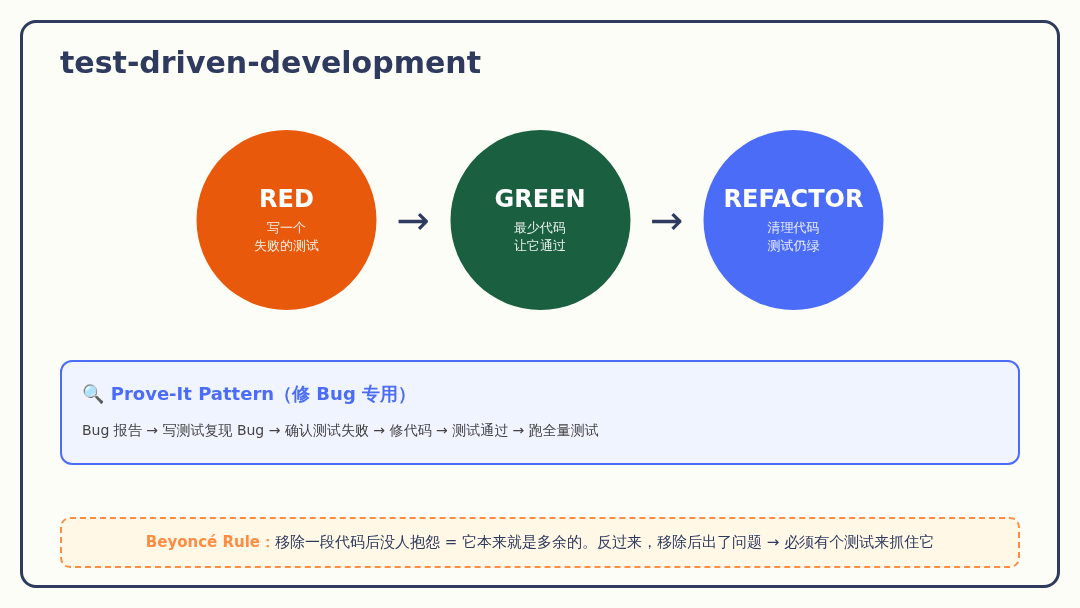
经典的 Red-Green-Refactor 循环,但在 AI 场景下做了针对性强化:
第一步 RED:先写一个必须失败的测试。如果测试一上来就过了,说明它什么也没证明。
第二步 GREEN:写最少量的代码让测试通过。不要过度设计。
第三步 REFACTOR:测试绿了之后才重构。每步重构都要重跑测试。
这里有个针对 AI 的关键设计——Prove-It Pattern(证明模式)。
当你报告一个 Bug,AI 的本能是立刻去"修"。但这个技能要求它先停下来:
- 01先写一个能复现 Bug 的测试
- 02确认测试确实失败了(证明 Bug 存在)
- 03再修代码
- 04测试通过了(证明修好了)
- 05跑全量测试(证明没引入新问题)
还有一个 Beyoncé Rule(对,就是那个 Beyoncé):如果你在没有测试的情况下移除一段代码,系统行为不变,那这段代码就是多余的。反过来说——如果移除后出了问题,就该有个测试来抓住它。
拆解三:code-review-and-quality
五轴代码审查模型
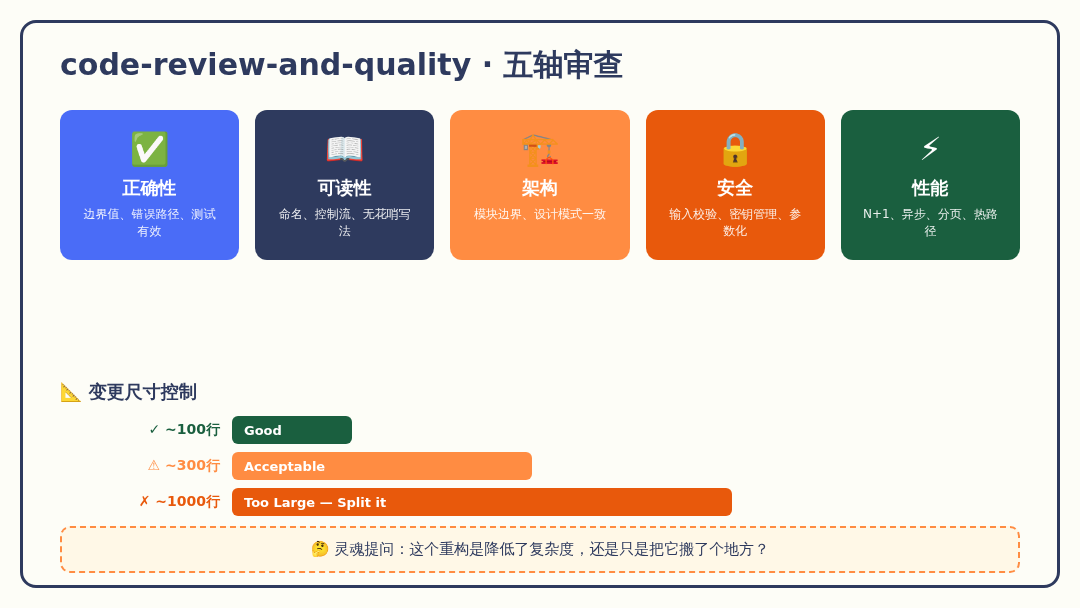
合并前必须过的五轴审查,每个变更从五个维度评估:
① 正确性——代码做了它声称做的事吗?边界值处理了吗?错误路径覆盖了吗?
② 可读性——另一个工程师不看注释能理解吗?变量名是 temp 还是 duration?有没有"聪明"到反而难读的写法?
③ 架构——符合现有设计模式吗?模块边界清晰吗?是不是在共享模块里塞了业务逻辑?
④ 安全——用户输入校验了吗?密钥有没有进代码?SQL 参数化了吗?外部数据当可信数据处理了吗?
⑤ 性能——有没有 N+1 查询?有没有同步操作该用异步的?列表接口分页了吗?
变更尺寸控制也很硬核:
约 100 行变更 → 好。坐着就能看完。
约 300 行变更 → 可以接受,前提是单个逻辑变更。
约 1000 行变更 → 太大了,拆开。
还有一个灵魂提问:这个重构是降低了复杂度,还是只是把它搬了个地方? 好的重构应该让整个模块、分支或层消失,而不是把同样的逻辑换个位置重新组织一遍。
装上它:一键搞定
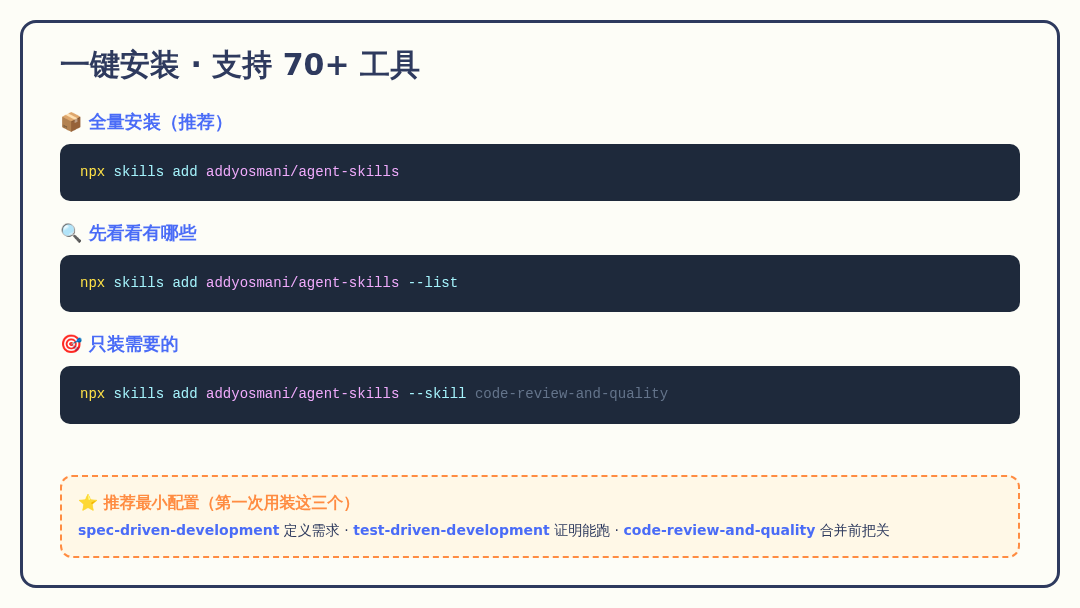
安装方式对比图
最快的方式:一行命令(支持 70+ 工具)
# 装全部 24 个技能
npx skills add addyosmani/agent-skills

# 先看看有哪些再决定
npx skills add addyosmani/agent-skills --list

# 只装你需要的
npx skills add addyosmani/agent-skills --skill code-review-and-quality
npx skills add addyosmani/agent-skills --skill test-driven-development
npx skills add addyosmani/agent-skills --skill spec-driven-development
适配 Claude Code、Cursor、Codex、Copilot、Cline 等主流工具。
Claude Code 用户
/plugin marketplace add addyosmani/agent-skills
/plugin install agent-skills@addy-agent-skills
遇到 SSH 报错的话,换成 HTTPS:
/plugin marketplace add https://github.com/addyosmani/agent-skills.git或者本地 clone:
git clone https://github.com/addyosmani/agent-skills.git
claude --plugin-dir /path/to/agent-skills
Cursor 用户
把 agent-skills/skills/ 下的内容同步到项目的 .cursor/skills/ 目录,然后在 .cursor/rules/*.mdc 里加简短引用就行。别把完整技能塞进 rules 文件——那会爆 Token。
任何支持 Markdown 指令的 Agent
git clone https://github.com/addyosmani/agent-skills.git找到你需要的 skills/xxx/SKILL.md,内容复制到你的 Agent 系统提示词或者项目的规则文件里。
推荐的最小配置
第一次用,装这三个就够了:
- 01spec-driven-development —— 定义要建什么
- 02test-driven-development —— 证明它能跑
- 03code-review-and-quality —— 合并前质量把关
这三个覆盖了 AI 辅助开发中最严重的质量缺口。用顺手了再加其他的。
8个斜杠命令:一键触发完整流程
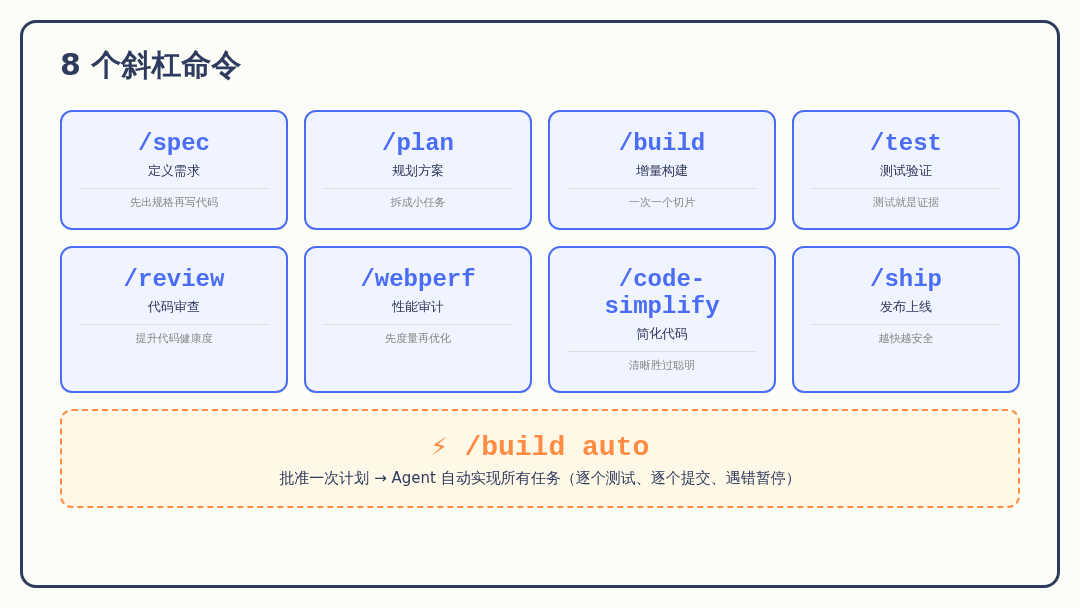
8个斜杠命令映射图
项目提供了 8 个命令,对应开发的不同阶段。不用记哪个技能在什么时候触发,命令会自动激活对应的技能:
| 你在干嘛 | 敲这个 | 核心原则 |
|---|---|---|
| 定义需求 | /spec | 先出规格再写代码 |
| 规划方案 | /plan | 拆成小任务 |
| 写代码 | /build | 一次一个切片 |
| 测试 | /test | 测试就是证据 |
| 代码审查 | /review | 提升代码健康度 |
| 性能审计 | /webperf | 先度量再优化 |
| 简化代码 | /code-simplify | 清晰胜过聪明 |
| 发布上线 | /ship | 越快越安全 |
还有一个杀手级命令——/build auto。你只需要批准一次计划,Agent 就会自动把所有任务逐个实现。每个任务仍然走完整的 TDD 流程、逐个提交,遇到失败或风险操作会自动暂停。它去掉的是你在任务之间来回确认的等待时间,不是去掉验证环节。
4个专家角色:专业的事交给专业的人
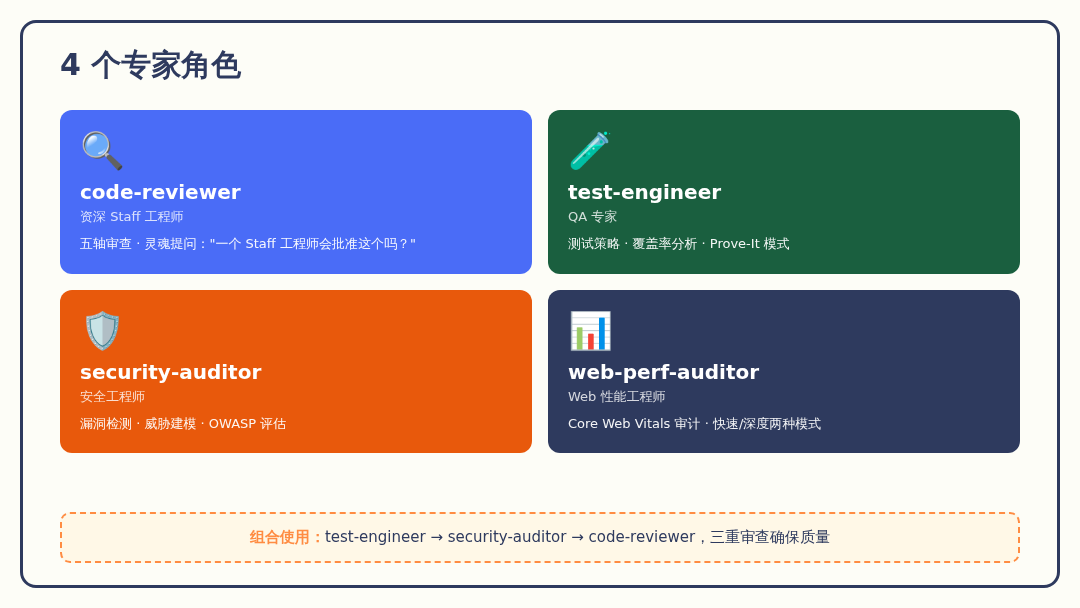
除了技能,项目还预置了 4 个 专家角色,专门做针对性审查:
| 角色 | 身份 | 干什么 |
|---|---|---|
| code-reviewer | 资深 Staff 工程师 | 五轴审查,灵魂提问:"一个 Staff 工程师会批准这个吗?" |
| test-engineer | QA 专家 | 测试策略、覆盖率分析、Prove-It 模式 |
| security-auditor | 安全工程师 | 漏洞检测、威胁建模、OWASP 评估 |
| web-performance-auditor | Web 性能工程师 | Core Web Vitals 审计,快速/深度两种模式 |
这些角色跟技能配合使用。比如你做完一个功能,可以先让 test-engineer 审查测试覆盖,再让 security-auditor 做安全检查,最后让 code-reviewer 做整体审查。
Google工程文化的基因
这套技能不是凭空设计的。Addy 在 Google 干了十几年,很多东西直接来自 Google 的工程实践。
Google工程实践映射图
你在技能里能看到这些 Google 经典概念 的影子:
- Hyrum's Law(出现在 API 设计技能中)——当你的 API 有足够多用户时,你做的任何契约保证都不如他们观察到的行为重要
- Beyoncé Rule(出现在测试技能中)——如果你移除一段代码没人抱怨,那它就是多余的
- 测试金字塔(80% 单元 / 15% 集成 / 5% E2E)
- 变更尺寸和审查速度规范(来自 Google 的工程实践指南)
- Chesterton's Fence(出现在简化技能中)——拆除一个东西之前,先搞清楚它为什么在那
- Shift Left 和 Feature Flag(出现在 CI/CD 技能中)
- 代码即负债(出现在弃用技能中)——Google 内部的核心信条之一
这些不是抽象原则。它们被直接写进了 Agent 要遵循的 分步工作流 里。Agent 不是在"理解"这些原则,而是在"执行"它们。
实际跑起来什么感觉
场景一:从零做一个新功能
你:/spec
    给博客系统加评论功能,嵌套回复、Markdown、@提及

Agent(自动激活 spec-driven-development):
  → 先列假设:数据库?认证方式?目标用户量?
  → 生成完整规格文档
  → 你确认后自动进入 /plan

你:/plan
Agent:规格拆成 8 个任务,每个有验收标准和依赖关系

你:/build auto
Agent:按计划逐个实现,每个任务有测试、有提交
场景二:修一个 Safari 白屏 Bug
你:用户反馈登录页在 Safari 上白屏

Agent(自动激活 debugging-and-error-recovery):
  Step 1: 复现——Safari 打开登录页,确认白屏
  Step 2: 定位——browser-testing-with-devtools 查 Console
  Step 3: 缩小——某个 polyfill 缺失
  Step 4: 修复——加上 polyfill
  Step 5: 守护——写回归测试防止复发
场景三:合并前审查
你:/review

Agent(自动激活 code-review-and-quality):
  ✅ 正确性——边界值完整,错误路径已覆盖
  ⚠️ 可读性——变量名 `d` 建议改为 `duration`
  ✅ 架构——符合现有模块边界
  ⚠️ 安全——SQL 查询建议参数化
  ✅ 性能——无 N+1 问题

  结论:修掉 2 个 Warning 后可合并
写在最后
AI 编程这个领域,接下来的竞争不会只比谁的模型参数更大。谁能让 AI 按照工程纪律干活,谁才是赢家。
agent-skills 做的事情不复杂:把顶级工程师的判断力编码成 AI 能执行的工作流。不追求让 AI 更聪明,让它 更靠谱。
对每个在用 AI 编程工具的开发者来说,这套东西值得花十分钟装上试试。
项目地址:https://github.com/addyosmani/agent-skills
官网:https://skills.addy.ie
许可证:MIT
本文转载自微信公众号「开发者社区」,仅供学习交流使用。
觉得内容不错?我要