
大模型如何吐出第一个Token
本文来源: AI产业拆解(公众号:AI产业拆解)
原文链接: https://mp.weixin.qq.com/s/tMIoPCZWtmsvkXa43d4ooA
发布时间: 2026-08-04 22:06
作者: AI产业拆解 发布时间: 2026-08-04 22:06
模型机制
第一个Token是怎样产生的
词表先把文字变成编号,Attention找相关信息,FFN继续加工,LM Head最后才给整个词表打分。
核心判断:大模型不会一次写好整句话;它先处理当前上下文,再从词表中选出第一个Token。
我们在对话框里输入:
苹果最常见的颜色是____。
点击发送后,大模型可能先输出“红色”,再继续补充苹果也有绿色、黄色等其他颜色。
很多人会疑惑:从点击发送到“红色”出现,中间究竟发生了什么?模型怎样理解这句话,又怎样从庞大的词表中选出第一个Token?
大模型并没有提前准备一份固定答案。它的工作方式更像我们写作文:动笔前有一个大致方向,但写到每个词时,仍会回看前文,判断接下来写什么最顺。区别在于,人依靠语言经验,大模型依靠训练得到的参数,把所有候选Token计算成一组分数。
对典型的自回归语言模型来说,第一个Token通过六步产生:
第一个Token的生成链路
1词表与Tokenizer
把文字切成Token并换成ID
↓
2Embedding
根据ID查出对应向量
↓
3多层Transformer
Attention找信息,FFN转换特征
↓
4最后位置隐藏表示
汇总当前问题的上下文
↓
5LM Head
给整个词表的候选Token打分
↓
6选出第一个Token
本例选中“红色”
在这个例子里,模型读到“苹果、最常见、颜色、是”以后,最终让“红色”获得较高分数,于是它成为第一个输出Token。
这里的顺序很重要:模型不是先给候选词打分,再用上下文重新排序;它先用Transformer处理完整上下文,最后才由LM Head一次性给整个词表打分。
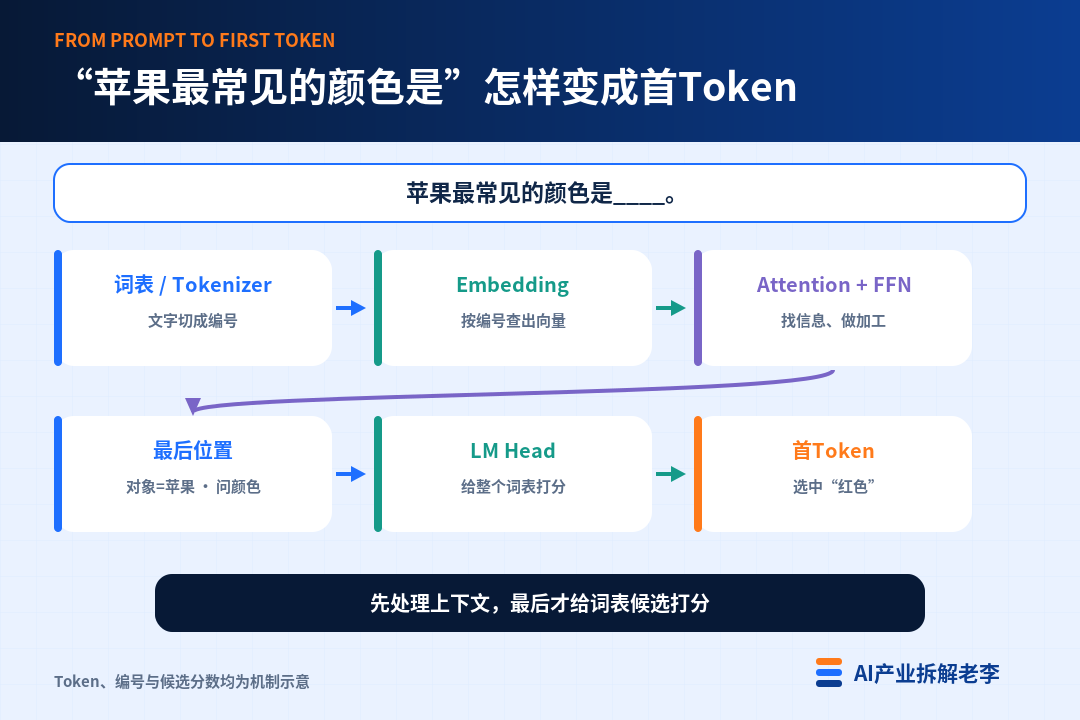
图1:文字先变成模型能计算的向量,经过多层Transformer形成上下文表示,最后从整个词表中选出第一个Token“红色”。
Tokenizer、Embedding、Transformer这些名字第一次看可能有些陌生。下面继续沿着“红色”这个例子,把每一步分别拆开。
模型先有一张词表,文字才能变成编号
模型不能直接计算“苹果”或“红色”这些文字。训练开始前,Tokenizer会先建立一张词表,把常见词、子词、汉字或字节片段分配成不同的Token ID。
为了说明机制,可以先假设这张词表完整收录了下面这些片段:
| 词表片段 | Token ID |
|---|---|
| 苹果 | 110 |
| 最常见 | 220 |
| 颜色 | 330 |
| 是 | 440 |
| 红色 | 550 |
| 绿色 | 551 |
| 蓝色 | 552 |
这些编号只是示意。真实模型的词表可能把“苹果”保留为一个Token,也可能切成更小的字符或字节片段;不同模型的编号也不相同。
Tokenizer把“苹果最常见的颜色是”切分并查表后,模型收到的是一串整数,例如:
[110, 220, 330, 440]
为什么一定要换成编号?因为模型本质上是一套巨大的数学函数,GPU或NPU只能对数字做计算,不能直接拿“苹果”两个字做矩阵乘法。Token ID先把每个Token换成一个可以查表的数字索引。
但[110, 220, 330, 440]还不能直接送进Transformer。编号的大小和距离没有语义:110和111相邻,不代表它们对应的Token含义也相近。Tokenizer只是把这些ID按原顺序排成序列,并不是把几个编号拼成一个更大的数字。
接下来轮到Embedding(嵌入层)。词表确定后,模型会为每个Token准备一行向量;这些向量一开始通常是随机数,再通过海量文本训练不断调整,最终形成Embedding表。它是模型权重的一部分。
假设模型的隐藏维度是4096,查表过程可以写成:
• 苹果(ID 110) → [0.42, -0.18, 0.73, ...]
• 颜色(ID 330) → [0.61, 0.25, -0.09, ...]
这里的每一行实际都有4096个数字,图中只展示前几个作为示意。
可以简单理解为:模型用4096个维度共同表示一个Token。Token ID像身份证号,只负责找到对应记录;Embedding向量更像这个Token在4096维语义空间中的一组坐标。“红色”和“绿色”这样的相关概念,整体表示通常也会更接近,但不是像身份证号码那样前几位固定相同。
一句话里的每个Token都会查出一个等长向量,这些向量再按原来的Token顺序排成一个矩阵。为了方便理解,可以把模型输入记成:Token的内容向量 + Token的位置信息。前者告诉模型“这是什么”,后者告诉模型“它排在第几位”。
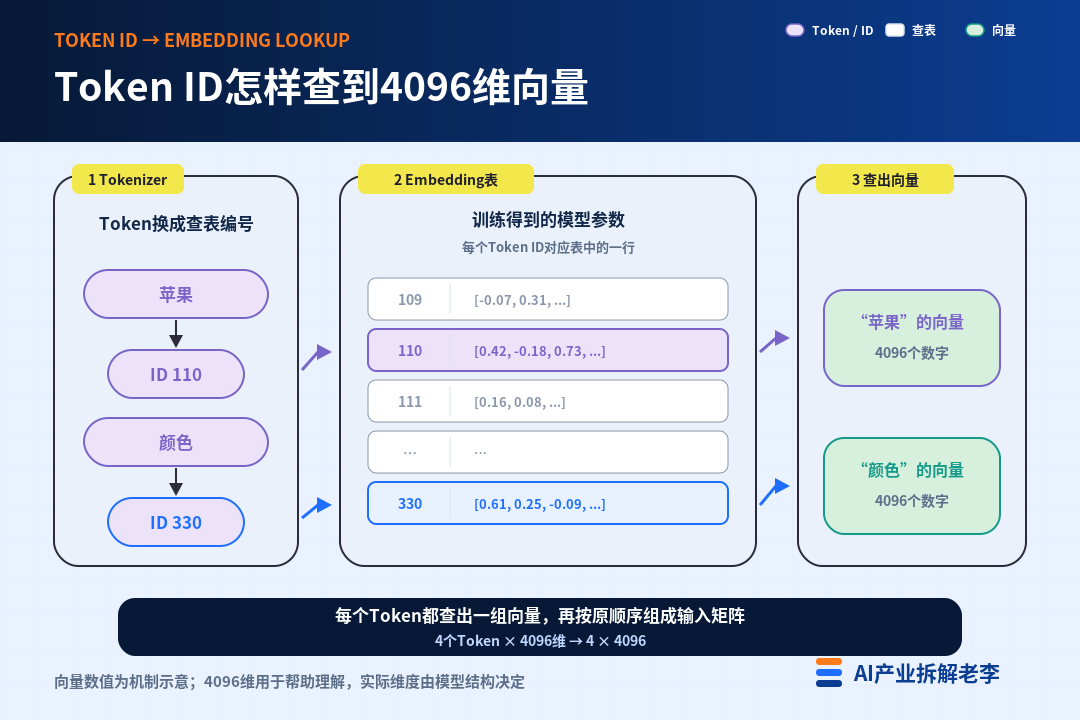
图2:Tokenizer先把Token换成ID;Embedding再用ID查询训练得到的向量表,把每个Token换成一组4096维表示。
Attention先找相关信息,FFN再加工这些信息
输入向量会连续穿过几十层甚至上百层Transformer。每一层主要包含Attention和FFN两类计算。
Q、K、V像一次查书
Attention(注意力)的任务,是让当前位置从前文找到与当前预测最相关的信息。
可以把它想象成去图书馆查“苹果最常见的颜色”:
• Q,Query(查询):我们正在查什么,这里是“苹果最常见的颜色是什么”;
• K,Key(键):每份资料的索引标签,例如“水果”“颜色”“常见程度”,用于判断哪些资料和问题相关;
• V,Value(值):索引背后的实际内容,也就是找到以后真正取回的信息。
在“苹果最常见的颜色是____”里,最后位置生成的Query会与前面每个Token的Key比较。它会重点读取“苹果”“颜色”“最常见”携带的Value,而不会平均看待所有信息。
Q、K、V不是人工写好的标签,而是输入向量经过Projection(投影,常缩写为proj)得到的新表示。投影可以理解为一次训练得到的矩阵变换。
如果不熟悉proj,先记住这条关系就够了:输入向量分别经过q_proj、k_proj、v_proj,得到Q、K、V;Attention取回信息后,再由o_proj合并结果。
FFN把找到的线索变成更明确的题意
Attention已经把“苹果”“颜色”“最常见”三条线索带回当前位置,但找齐资料还不等于理解了题目。FFN(前馈网络,也常写作MLP)会在每个Token位置内部继续判断:这些线索应该怎样组合,哪些特征与当前问题有关。
仍以苹果为例。Attention取回线索以后,最后位置的向量同时带着“对象是苹果、属性是颜色、条件是最常见”等信息。FFN像是把一道综合题拆成许多小判断:“这是水果问题吗”“问的是颜色还是形状”“有没有最常见这个限制”。常见的门控FFN,可以按作用理解成三步:
| FFN里的计算 | 在苹果问题里起什么作用 |
|---|---|
| up_proj:展开 | 把原本紧凑的向量铺到更多特征维度,相当于把一道综合题拆成“水果?”“颜色?”“形状?”等许多小判断 |
| gate_proj + 激活:开关 | 根据当前语境让有用的特征通过,例如“苹果 + 颜色 + 最常见”,同时压低“苹果 + 形状”等不符合题意的方向 |
| down_proj:压回 | 把筛选后的特征重新合并到原来的向量维度,交给下一层Transformer继续处理 |
为什么要先展开再压回?更宽的中间层可以同时表达更多特征组合;处理完成后压回原维度,才能与原来的信息相加,并继续送入下一层。
FFN并不会在这里直接写出“红色”。它只是让当前位置的表示从一个普通的“是”,变得更像“正在回答苹果最常见的颜色”。Attention与FFN在几十层甚至上百层中反复配合,最后才形成适合预测下一个Token的隐藏表示。
两者的分工可以这样记:Attention负责在不同Token之间找信息,FFN负责在每个Token内部识别、筛选和转换特征。残差连接保留原有信息,归一化让多层计算保持稳定。
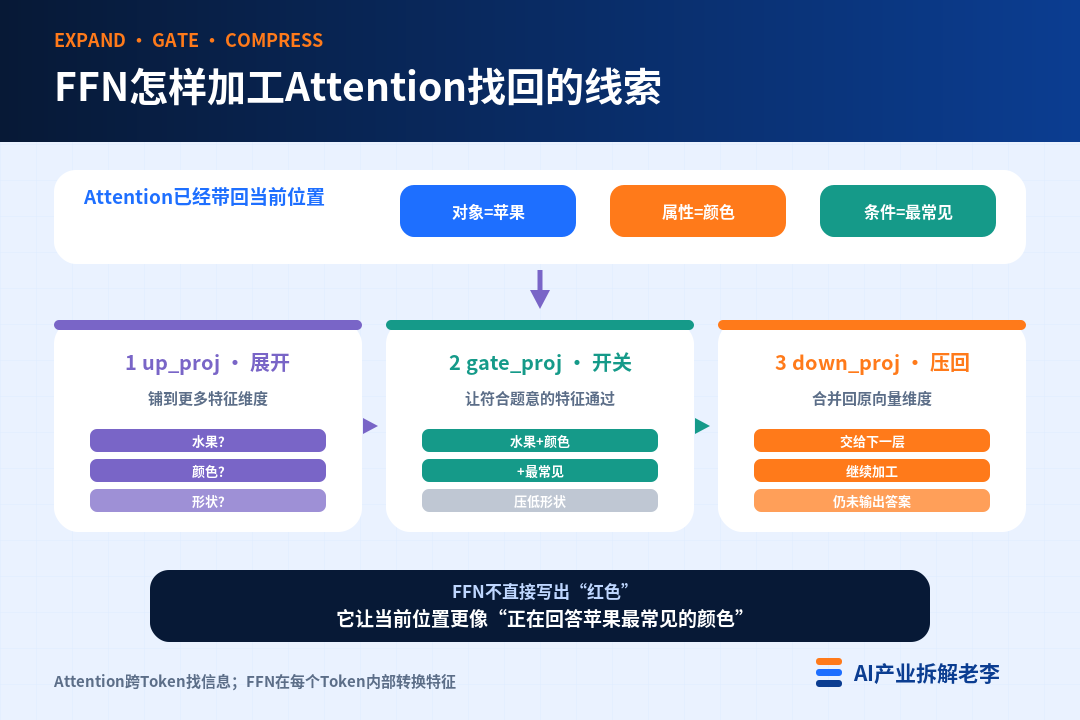
图3:Attention先把相关线索带回当前位置;FFN再通过展开、门控筛选和压回,把这些线索转换成更明确的题意表示。
最后一个位置,汇总了当前问题
聊天模型通常使用带因果遮罩的Self-Attention(自注意力)。第1个位置只能看自己,第2个位置可以看前两个位置,最后一个输入位置则能读取此前的整段内容。
训练时,完整句子明明已经放在模型面前,因果遮罩仍会盖住每个位置右侧的内容,强制模型只能根据“已经出现的Token”预测下一个Token。这样做是为了模拟真实推理:生成答案时,未来的文字还不存在,模型不可能提前看到。训练和推理因此面对的是同一道题。
经过多层Transformer后,每个Token都会得到一组新的隐藏表示。最后一个输入位置的隐藏表示,被用来预测紧接在后面的Token。
在这个例子里,它不再只是“是”这个字的向量,而是已经融入了前面的语境:对象是苹果,问题问颜色,条件是最常见,当前位置需要补全答案。
模型与其说是在“查找苹果的固定标签”,不如说是在把整个问题压缩成一个适合继续生成的向量。换成“苹果最常见的形状是____”,最后位置的表示也会变化,后面的候选排序自然不同。
LM Head最后才给整个词表打分
最后位置的隐藏表示仍是一串数字。LM Head(语言模型输出头)会把它投影到整个词表:假如词表有10万个Token,就会一次得到10万个候选分数。
这些分数叫logits,也就是还没有归一化的原始分数。在“苹果最常见的颜色是____”这个语境中,可以把候选结果想象成:
| 候选Token | 相对分数示意 | 为什么 |
|---|---|---|
| 红色 | 8.7 | 苹果与常见颜色关系匹配 |
| 绿色 | 6.4 | 也是常见苹果颜色 |
| 黄色 | 5.8 | 语义和问题类型匹配 |
| 蓝色 | 1.2 | 属于颜色,但与苹果关系弱 |
| 圆形 | 0.6 | 与苹果相关,却不回答颜色 |
这里的分数只用于说明机制,不对应某个真实模型。
Softmax会把logits转换成概率,解码策略再按照贪心、温度、Top-k或Top-p等规则选出一个Token。假设这张示意词表把“红色”收录为完整Token,模型本轮就会输出ID 550,Detokenizer(反分词)再把它还原为可见文字“红色”。
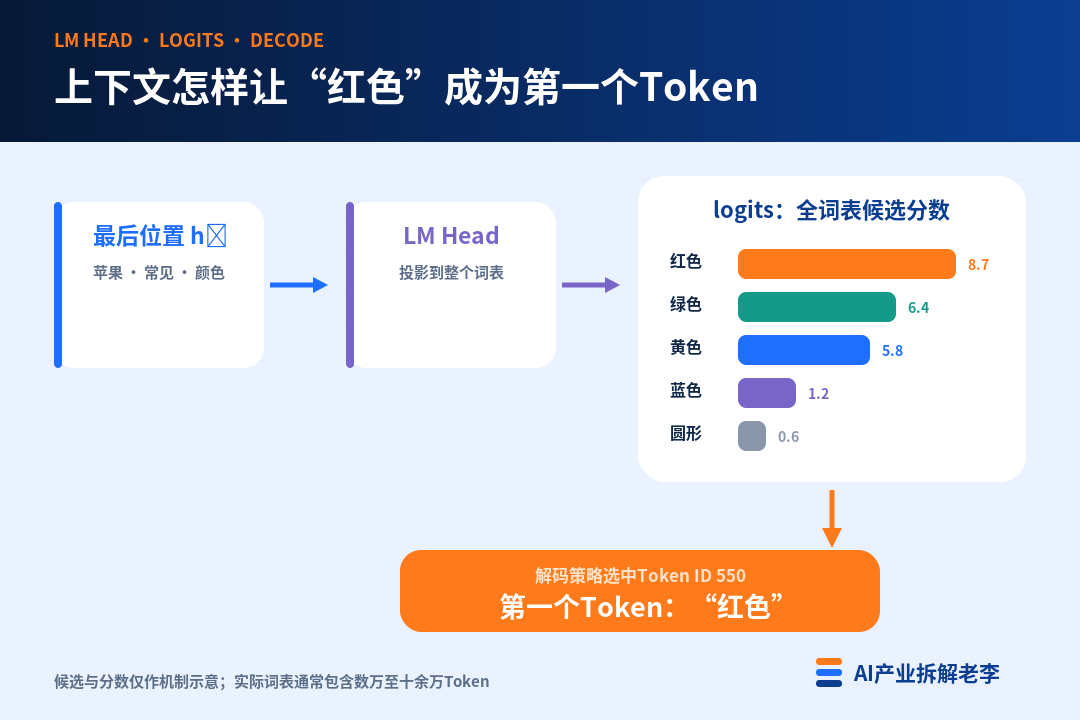
图4:Transformer先把上下文压缩成最后位置的隐藏表示,LM Head随后给全词表打分,解码策略选出“红色”。
第一个Token,浓缩了整套大模型
大模型不会在点击发送的一刻拿出一份已经写好的答案。词表先把文字变成编号,Embedding把编号变成向量,Attention找到相关信息,FFN继续加工,LM Head最后才给所有候选Token打分。
这条链路也说明,大模型的能力不是来自某一个孤立模块。Tokenizer、Embedding、Attention、FFN和LM Head层层配合,才把一句自然语言变成词表中的一次选择。
国产大模型近两年进步很快,开放模型让更多开发者能够理解、验证和改进这条完整链路。模型结构不断演进,训练数据和工程能力持续积累,才能让从输入到第一个Token的整条链路更准确、更可靠。
第一个Token不是从固定答案里取出来的,而是完整上下文经过Transformer后,由LM Head从词表中计算出来的。
关注「AI产业拆解老李」,我们继续把大模型从输入到输出的核心机制讲清楚。
如果身边有人也好奇一句话怎样变成大模型的第一个Token,可以把这篇转给他。
看懂 AI 产业,看见新机会。
本文转载自微信公众号「AI产业拆解」,仅供学习交流使用。
觉得内容不错?我要