
为什么Prefill吃算力,Decode吃带宽?
本文来源: AI拆解师(公众号:AI拆解师)
原文链接: https://mp.weixin.qq.com/s/hrmtkQIRZLdyUjE63sNlbA
发布时间: 2026-08-23 12:06
作者: AI拆解师 发布时间: 2026-08-23 12:06
TOKEN生产技术专章 · 第12篇
为什么Prefill吃算力,
Decode吃带宽?
用Roofline模型看懂推理瓶颈
TOKEN · GPU · INFERENCE · SYSTEMS
大模型推理常被一句话概括:“Prefill是计算密集型,Decode是带宽密集型。”这句话大体正确,却很容易被误用。长提示词、短批次、GQA、量化、超长KV Cache和多卡通信,都可能改变瓶颈的位置;同一个Decode,在批次增大后也可能重新靠近计算受限区。
要把这件事讲透,需要一个统一坐标系:算术强度。它衡量每搬运一个字节的数据,GPU完成了多少次运算。Roofline模型把硬件峰值算力与内存带宽画成两条上限,由此判断某个工作负载更可能撞上“计算屋顶”还是“带宽斜坡”。
一、先把一次请求拆成两个不同阶段
Prefill接收整段Prompt,并行计算每个位置的隐藏状态,同时建立各层KV Cache。它决定用户等待第一个Token多久,是TTFT的重要组成部分。Decode从第一个输出Token开始,每轮只为每个活跃请求推进一个或少数几个位置,直到生成结束;它决定流式输出是否顺滑,常用TPOT或ITL衡量。
两者使用同一套模型权重,但张量形状不同。Prefill的Token维度大,线性层更像矩阵—矩阵乘法;Decode单步Token维度小,常接近矩阵—向量或很窄的矩阵乘法。前者能让一次权重读取服务很多Token,后者对每个新Token都要穿过几乎整套权重。
这不是“Prefill计算更多、Decode计算更少”这么简单。关键在于计算量与数据搬运量的比例:同样读取1GB权重,若为2048个Prompt Token共同使用,它产生的有用运算远多于只为一个新Token使用。
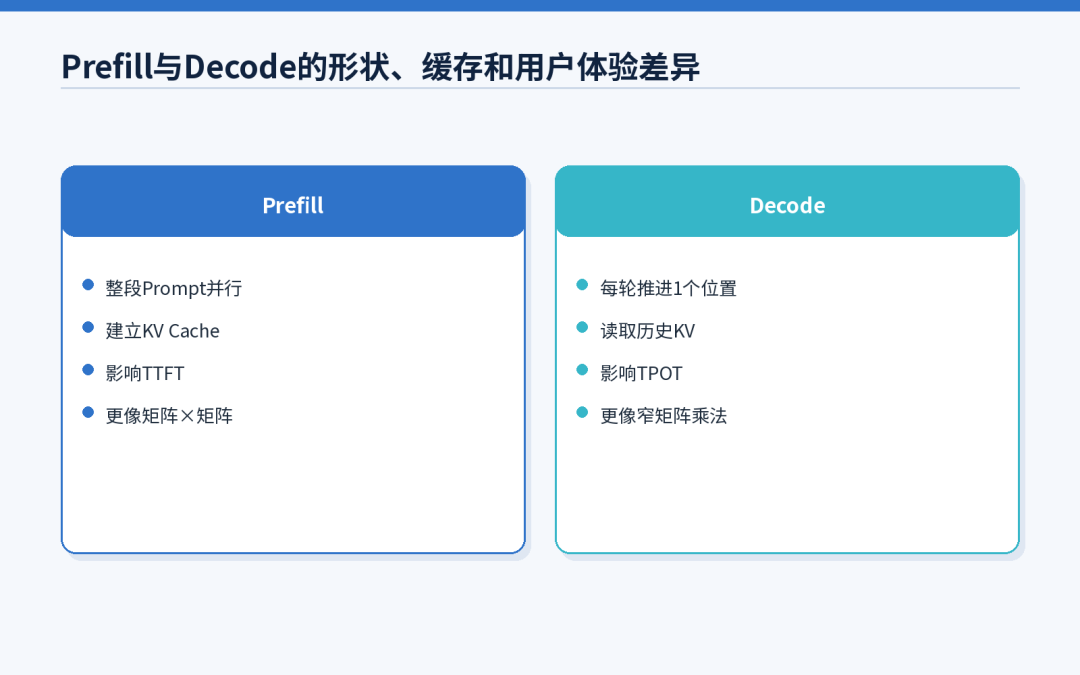
图1 Prefill与Decode的形状、缓存和用户体验差异
二、Roofline模型只问两个数字
对一个算子或一段工作负载,算术强度可写成:
I=(FLOPs) / (从主存搬运的字节数)
硬件有两个关键上限:峰值计算吞吐 P_(peak) 和显存带宽 BW_(peak)。可达到的性能近似受下面的较小者限制:
P≤ min(P_(peak), I× BW_(peak))
当I很低时,即使Tensor Core理论算力巨大,数据也来不及喂给它,性能落在带宽斜坡上;当I足够高时,数据复用充分,性能才可能靠近水平的计算屋顶。两者交点 I^*=P_(peak)/BW_(peak) 常被称为ridge point。
Roofline不是精确预测器。它忽略了内核启动、同步、缓存层级、通信和不规则访问,但非常适合第一轮诊断:如果工作负载的算术强度远低于交点,就不该把主要希望寄托在增加更多Tensor Core上。
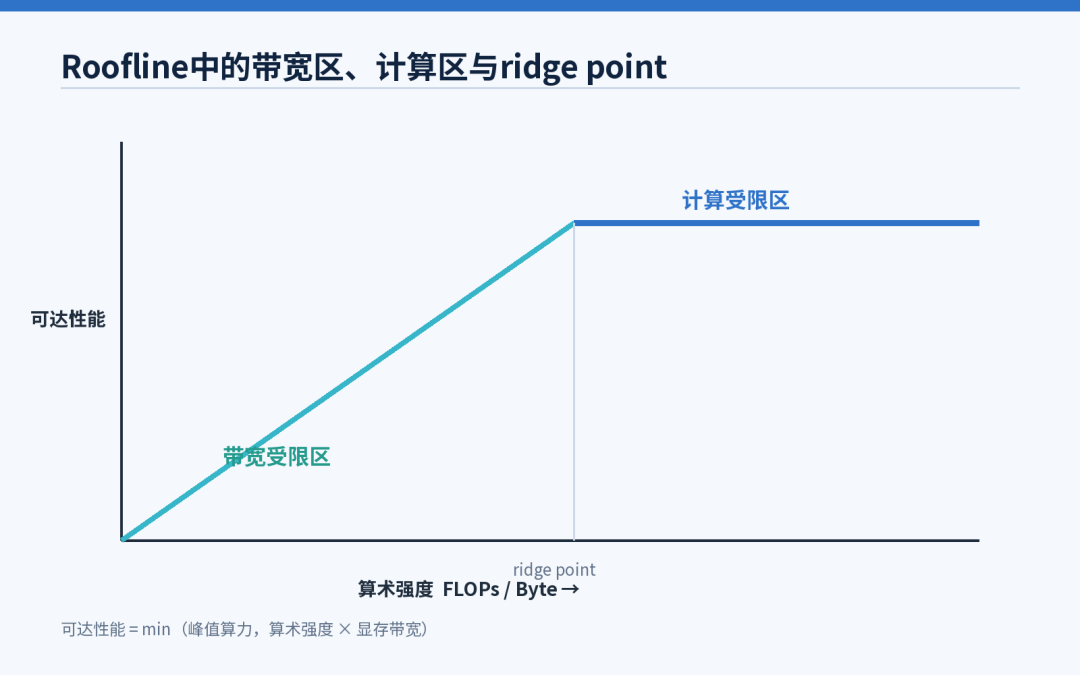
图2 Roofline中的带宽区、计算区与ridge point
三、Prefill为什么通常有较高算术强度
以线性层 Y=XW 为例。权重W很大,但Prefill的X含有许多Token行。权重从HBM读取到片上缓存后,可以参与大量乘加;Token越多、分块越合理,数据复用越充分。大GEMM也更容易让大量SM持续工作,摊薄内核启动和尾部不满块的损失。
注意力又带来另一层复杂性。标准实现若把完整注意力分数矩阵写回HBM,会产生巨大的中间IO;FlashAttention通过分块与在线Softmax,把更多工作留在片上SRAM,显著降低HBM读写。它没有从数学上省去所有点积,却提高了有效算术强度,因而让长序列Prefill更快。
但Prefill不保证永远计算受限。很短的Prompt、小批次、碎片化的调度或大量小算子,都可能让GPU吃不满;超长Prompt下,Attention的IO、KV写入甚至多卡Context Parallel通信也会成为主导项。正确表述应是:Prefill更容易形成高算术强度的大矩阵计算,因此通常更接近计算受限。
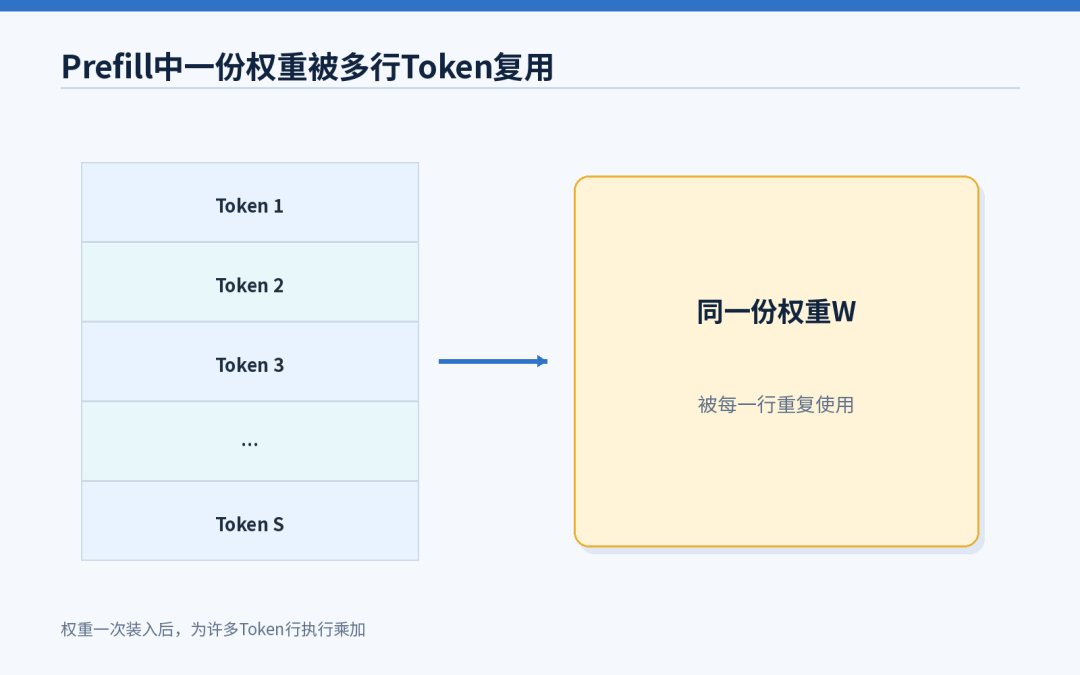
图3 Prefill中一份权重被多行Token复用
四、Decode为什么通常变成“搬权重”问题
Decode每步新增一个Token。假设单请求或小批次,线性层输入只有少量行,同一份权重在这一轮被复用的次数很少。为了完成一次Token推进,GPU需要从HBM读取注意力与MLP的大量参数;计算单元很快做完乘加,然后等待下一批数据。
可以做一个极简估算:若某密集模型有效权重约为140GB,而单步只服务一个Token,那么不考虑缓存与并行时,至少要搬运接近这个量级的权重字节。即使HBM带宽是TB/s级,单步也不可能无限缩短。把权重量化到更少字节,或把多个请求合成批次让权重共享,往往比单纯提高峰值FLOPs更直接。
除此之外,Decode还要读取所有历史位置的KV Cache。上下文越长、层数越多、KV头越多,这部分带宽与容量越大。GQA/MQA、KV量化和更紧凑的注意力结构,都是在降低这条随上下文增长的读流量。
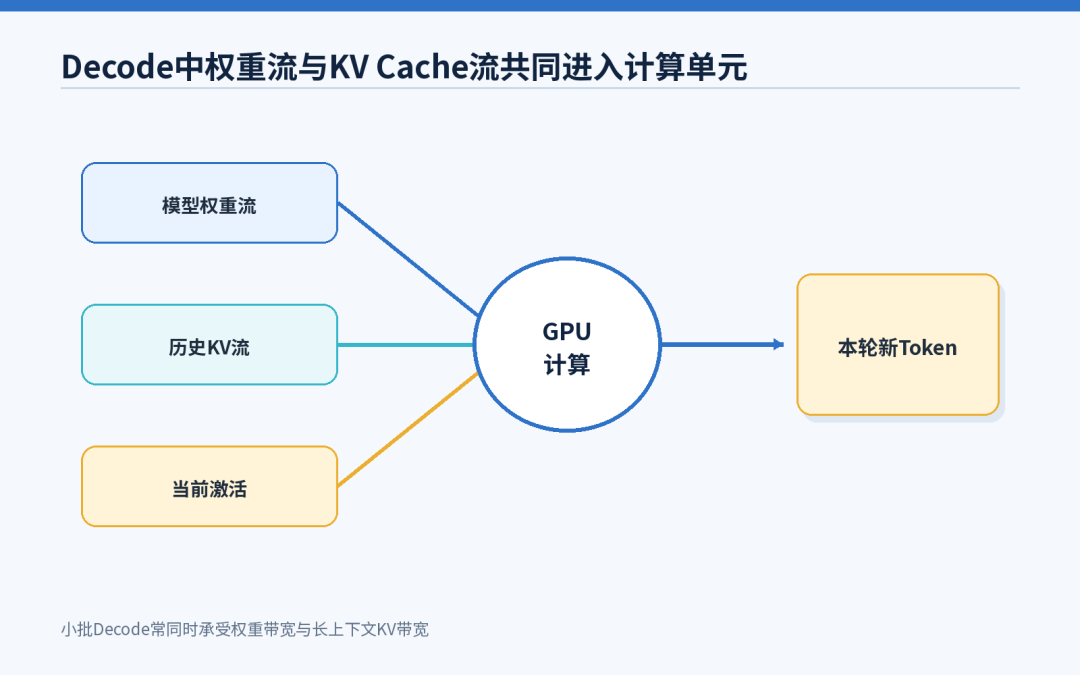
图4 Decode中权重流与KV Cache流共同进入计算单元
| 维度 | Prefill | Decode |
|---|---|---|
| 每轮新增Token | 一段Prompt中的许多Token | 每个请求通常1个 |
| 典型矩阵形状 | 宽而高的大GEMM | 窄GEMM/矩阵—向量 |
| 权重复用 | 高 | 小批时低,批次增大后改善 |
| KV行为 | 计算并写入新KV | 读取历史KV并追加新KV |
| 主要体验指标 | TTFT | TPOT/ITL |
| 常见主瓶颈 | 算力、Attention IO | HBM带宽、KV容量、调度 |
表1 为什么Prefill吃算力、Decode吃带宽?关键对照
五、Batch为什么能提高吞吐,却不免费
把B个请求的Decode Token合并,相当于让同一份权重服务B行输入。B从1增加到更大时,算术强度上升,矩阵形状更友好,Token/s通常显著增加。这是连续批处理能提升产能的物理基础。
但Batch不是越大越好。每个请求都带着自己的KV Cache,批次增大会抬高显存占用;正在等待的请求还会增加排队时间。若一次迭代塞入太多Prefill Token,Decode请求可能遭遇TPOT抖动。达到某个点后,计算、KV访问或通信重新成为瓶颈,吞吐增幅趋缓,P99延迟却继续恶化。
所以生产系统不会只追求最大离线Token/s,而会在给定TTFT和TPOT服务目标下寻找最大Goodput。这个问题已经从单算子性能变成调度与容量规划问题。
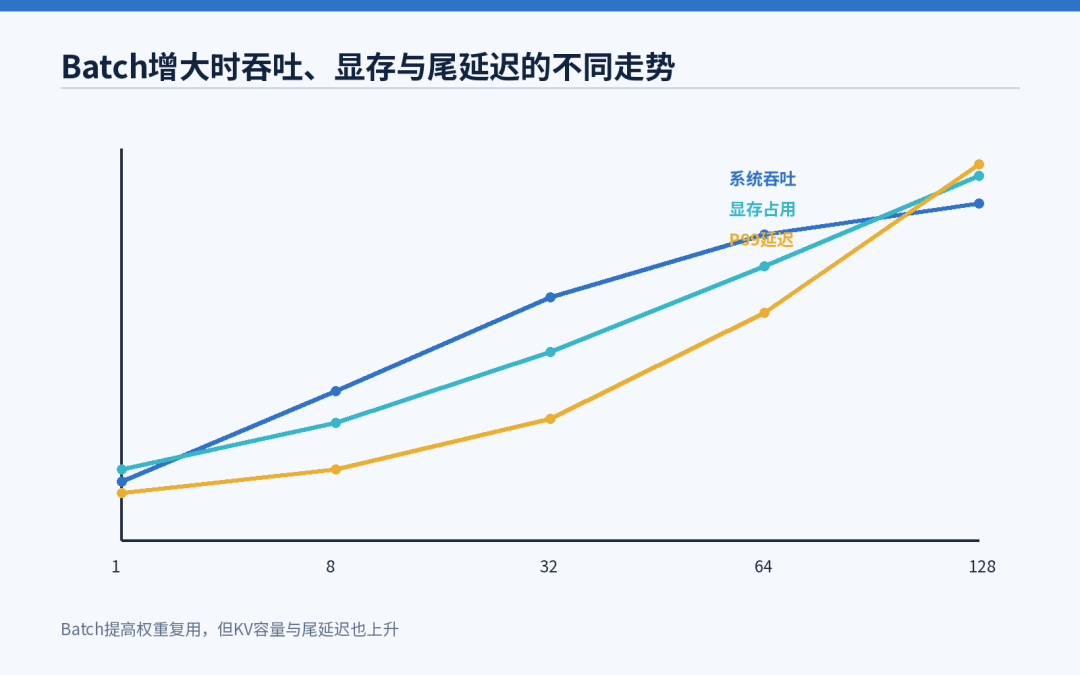
图5 Batch增大时吞吐、显存与尾延迟的不同走势
六、量化为什么对Decode往往更“对症”
量化把FP16/BF16权重压缩为FP8、INT8、FP4或INT4等形式。若Decode主要受权重带宽限制,权重字节数减半,理论上可明显减少每步搬运时间;同时更小权重允许更大Batch或更多副本进入同一台服务器。
但是低比特并不自动等于成比例加速。量化值可能需要解码、反量化或专门Tensor Core支持;矩阵形状、分组尺度和Kernel成熟度都会影响收益。若工作负载已是计算受限,量化能否提升速度还取决于低精度计算吞吐是否真的被利用。若瓶颈在跨节点通信、采样或排队,压权重也不会解决全部问题。
同理,KV Cache量化主要缓解长上下文的缓存容量与读带宽,而权重量化主要缓解参数驻留与读取。把两者混成一句“模型变成4bit”,容易误判收益来源。
七、如何用测量判断自己站在Roofline的哪一边
第一步不是计算一个漂亮的理论值,而是固定工作负载:模型、精度、输入长度、输出长度、并发、批策略和GPU拓扑必须明确。然后分别测TTFT、TPOT、输出Token吞吐,以及HBM带宽利用率、Tensor Core利用率、内核时间占比和通信占比。
若Prefill中大GEMM占主导、计算单元持续繁忙且带宽未饱和,优化方向可能是更低精度计算、更优GEMM、并行划分;若Attention大量时间用于HBM中间读写,应优先检查FlashAttention与分块。若Decode带宽接近上限而计算利用率低,权重量化、增大有效Batch和减少KV字节更可能奏效。
如果两者都不高,问题往往在第三类:小Kernel、CPU调度、同步、形状抖动、内存分配或通信等待。Roofline告诉你“理论大类”,Profiler告诉你“具体哪一段”。
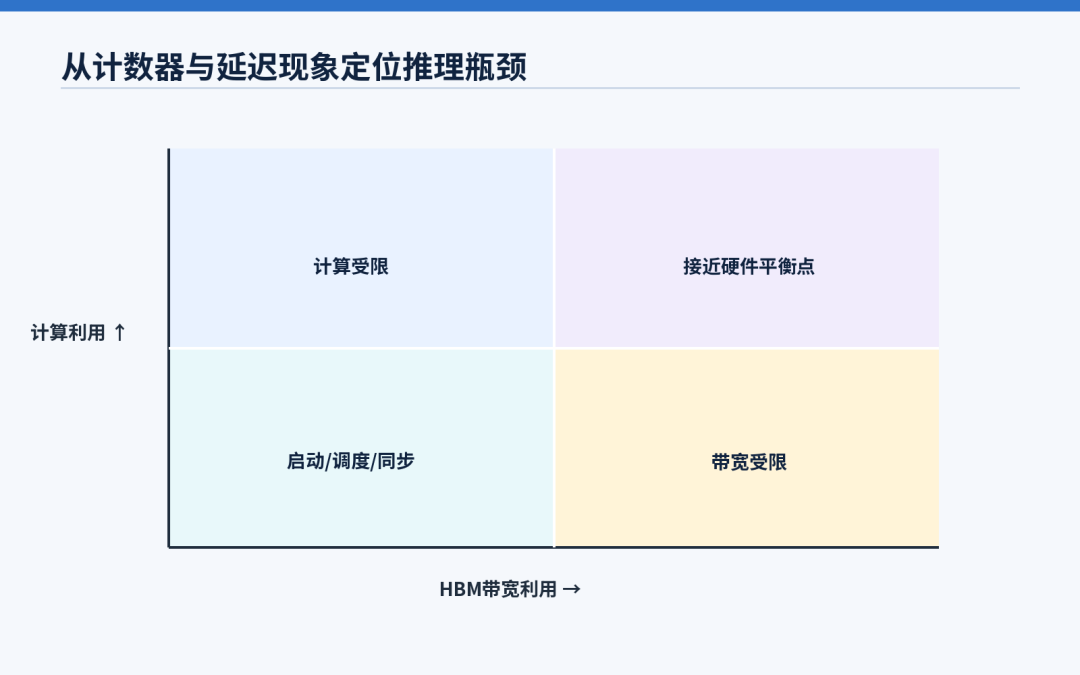
图6 从计数器与延迟现象定位推理瓶颈
| 观测现象 | 更可能的瓶颈 | 优先验证的手段 |
|---|---|---|
| 高计算利用率、低带宽余量仍充足 | 计算 | 低精度Tensor Core、GEMM形状、TP划分 |
| 高HBM带宽、计算利用率偏低 | 内存带宽 | 量化、Batch、融合、KV压缩 |
| 两者都低且小Kernel很多 | 启动/调度 | 算子融合、CUDA Graph、固定形状 |
| 多卡随规模扩展反而变慢 | 通信 | NCCL时间线、链路拓扑、并行度 |
| 平均值正常但P99恶化 | 排队/干扰 | 负载模型、Chunk大小、优先级与Goodput |
表2 为什么Prefill吃算力、Decode吃带宽?关键对照
八、Roofline最有价值的地方,是阻止“万能优化”叙事
FlashAttention主要减少Attention的HBM往返;量化减少权重、激活或KV的字节数,并可能利用低精度计算;Batch提高权重复用;并行把计算摊到多卡,却引入通信;推测解码用额外验证计算换取更少串行步数。它们作用在不同坐标轴上。
所以“某技术能让推理快几倍”必须附带条件:在哪个模型、哪个阶段、哪种精度、什么序列长度、什么并发和什么SLO下。离开这些条件,倍数不能迁移。
回到标题:Prefill通常吃算力,是因为大量Token让权重与片上数据被充分复用;Decode通常吃带宽,是因为每个串行步只推进少量Token,却要读取大量权重和历史KV。Roofline模型把这句经验判断变成了可测量、可反驳、可指导优化的工程框架。
九、三个最常见的Roofline误判
第一,把模型参数字节当成每步实际HBM流量。缓存、权重分片、融合和重复读取会让两者不同,KV与中间张量也会增加流量。第二,用整机峰值TFLOPS除以理论FLOPs直接预测延迟,却不检查数据类型和矩阵形状是否能触发该峰值。第三,把端到端服务放在一张单GPU Roofline图上,忽略排队、CPU、网络与NCCL。
更稳妥的做法是分层使用模型:先用Roofline判断“计算还是数据移动”;再用Kernel级Profiler验证实际带宽、计算吞吐与占用;最后用在线负载测试确认优化有没有转化成TTFT、TPOT和Goodput。三层结论若不一致,通常意味着瓶颈已迁移,或测量口径不相同。
还需警惕平均算术强度。一次迭代中可能同时有计算受限的GEMM和带宽受限的Norm,平均后落在中间并不代表存在一个“半计算半带宽”的单一算子。优化应针对关键路径上的具体Kernel,而不是追逐整段平均值。
参考资料
·Williams et al., Roofline: An Insightful Visual Performance Model for Multicore Architectures:https://dl.acm.org/doi/10.1145/1498765.1498785
·NVIDIA, GPU Performance Background User's Guide:https://docs.nvidia.com/deeplearning/performance/dl-performance-gpu-background/index.html
·Dao et al., FlashAttention:https://arxiv.org/abs/2205.14135
·NVIDIA, NIM LLM Benchmarking Metrics:https://docs.nvidia.com/nim/benchmarking/llm/latest/metrics.html
本文转载自微信公众号「AI拆解师」,仅供学习交流使用。
觉得内容不错?我要